
[arXiv 2024] BFCL:打破工具调用迷雾,打造 AI Agent 的“真金白银”度量衡
The berkeley function calling leaderboard (bfcl): From tool use to agentic evaluation of large language models
本文推出了 Berkeley Function Calling Leaderboard (BFCL),这是一个旨在全面评估大语言模型(LLM)工具使用能力的基准测试。它涵盖了从单步并行调用到复杂多步 Agent 场景的 5,551 个任务,并引入了基于抽象语法树(AST)的创新评估方法,目前已成为评估 GPT-4、Claude 3.5 等 SOTA 模型函数调用能力的行业标准。
TL;DR
伯克利大学的研究团队发布了 Berkeley Function Calling Leaderboard (BFCL),这是一个包含 5,551 个高质量样本的基准测试,旨在解决 LLM 在“工具使用(Tool Use)”评估中不可扩展和场景单一的弊端。通过引入 AST 匹配 技术和多轮 Agent 场景,BFCL 不仅揭示了顶级模型在简单调用上的 SOTA 表现,也无情地指出了当前 LLM 在长程推理和记忆管理中仅有约 12% 准确率的残酷现实。
痛点深挖:为什么之前的评估都不作数?
在 AI Agent 系统中,Function Calling 是连接模型大脑与外部世界的“手”。然而,评估这双手是否灵活一直是个难题:
- 执行代价高昂:传统的评估需要真的运行 API。如果你要测试 1000 个模型在 5000 个任务上的表现,API 的响应延迟、密钥失效、网络波动会让你崩溃。
- 静态分布的局限性:许多模型在现有的 Benchmarks 上刷到了高分,但实际应用中,面对混乱的参数、缺失的信息或长对话历史就直接“宕机”。
- 数据污染:由于很多评测集是静态的,模型在预训练阶段可能已经见过答案。
Methodology:AST 评估与四维数据集架构
1. 核心创新:AST Substring Matching
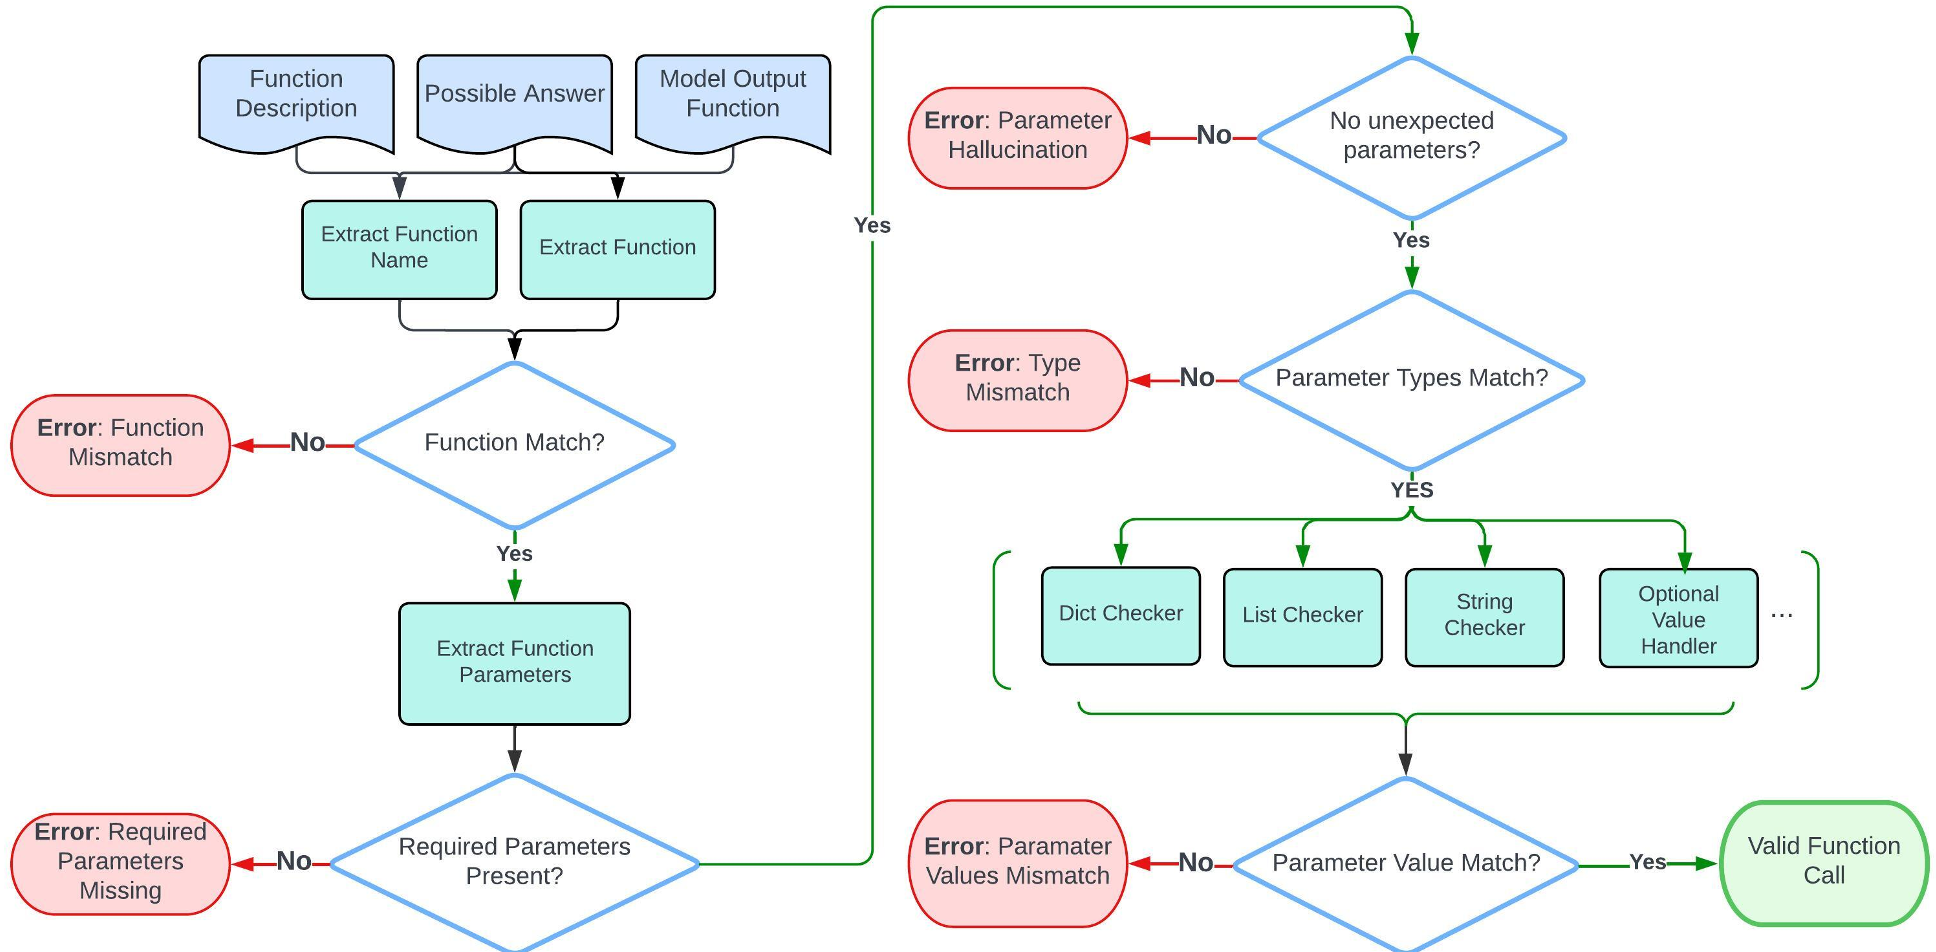
为了在大规模评估中摆脱“实际执行”的束缚,作者引入了抽象语法树(AST)匹配。如图所示,系统将模型的输出解析为语法树,不仅校验函数名,更递归地检查参数类型(如 Java 里的 long 必须带 L)和数值合法性。实验证明,这种 AST 评分与实际执行结果高度相关。
2. 数据集的四个象限
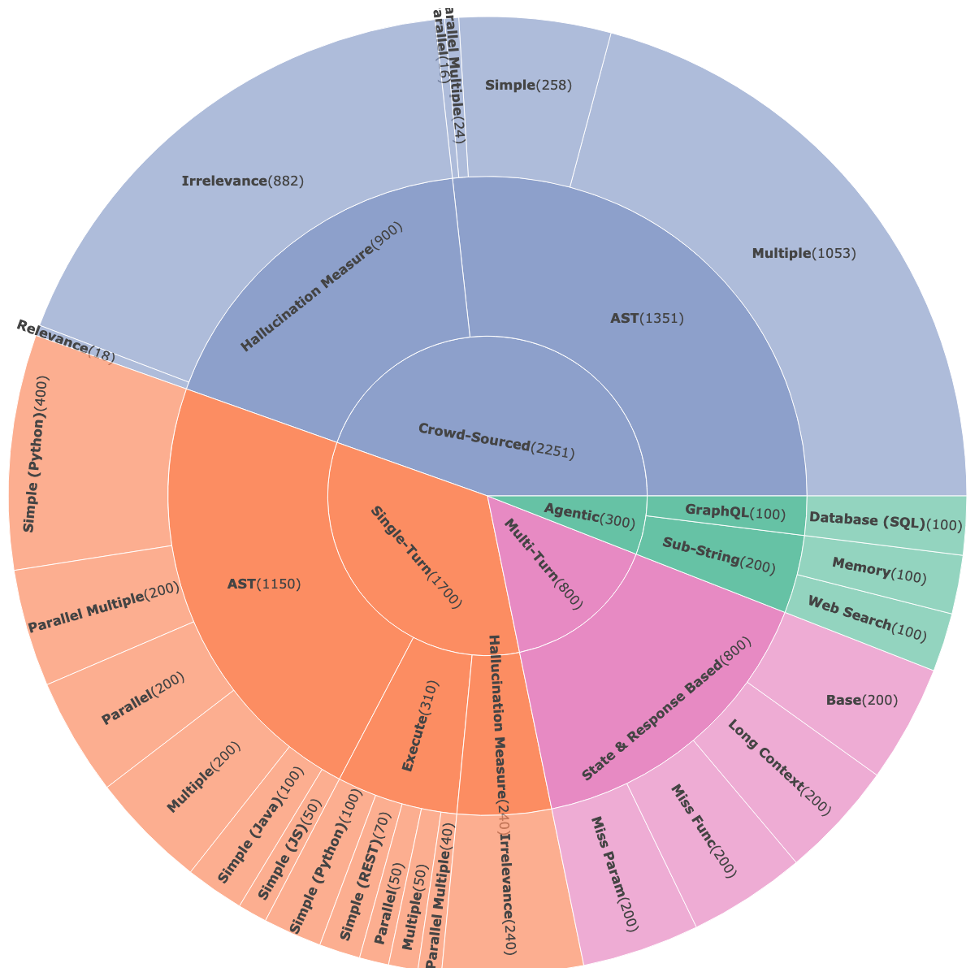
- 单轮 (Single-turn):测试简单、多个、并行及“不相关”调用(考察模型是否能忍住不乱调用)。
- 众包 (Crowd-sourced):来自 Gorilla 用户社区的真实复杂 Query,包含多语言混杂。
- 多轮 (Multi-turn):考察对话流,模型必须识别缺失参数并主动向用户追问。
- 智能体 (Agentic):涵盖 Web 搜索、SQL 查询和最难的记忆管理(Memory)。
核心实验与深度发现:顶级模型的滑铁卢
1. 记忆任务:AI 处理能力的“天花板”
在最新的测试中,强如 o1-2024-12-17 在记忆扩展分类中的表现也令人汗颜。模型在面对需要“读取、修改、删除”长期事实的任务时表现极差。常见的错误包括:
- 检索幻觉:模型不去查询现有的 Key(List Keys),而是凭直觉瞎猜。
- 分片错误:将“四年级男性 CS 专业”拆分成三个独立的 Key 存储,导致后续检索冲突。
2. 模式之争:FC Mode vs. Prompting Mode
这是一个出人意料的发现。虽然大多数厂商推出了原生的 FC Mode(结构化 JSON 输出),但研究发现:
- FC Mode 确实解析错误更少,格式更稳。
- Prompting Mode(通过 System Prompt 引导)在处理 Java/JS 或复杂并行调用时反而更灵活、准确率更高。例如,部分顶级模型在原生 FC 模式下竟然不支持并行调用,但在这种传统的提示词模式下却表现出色。
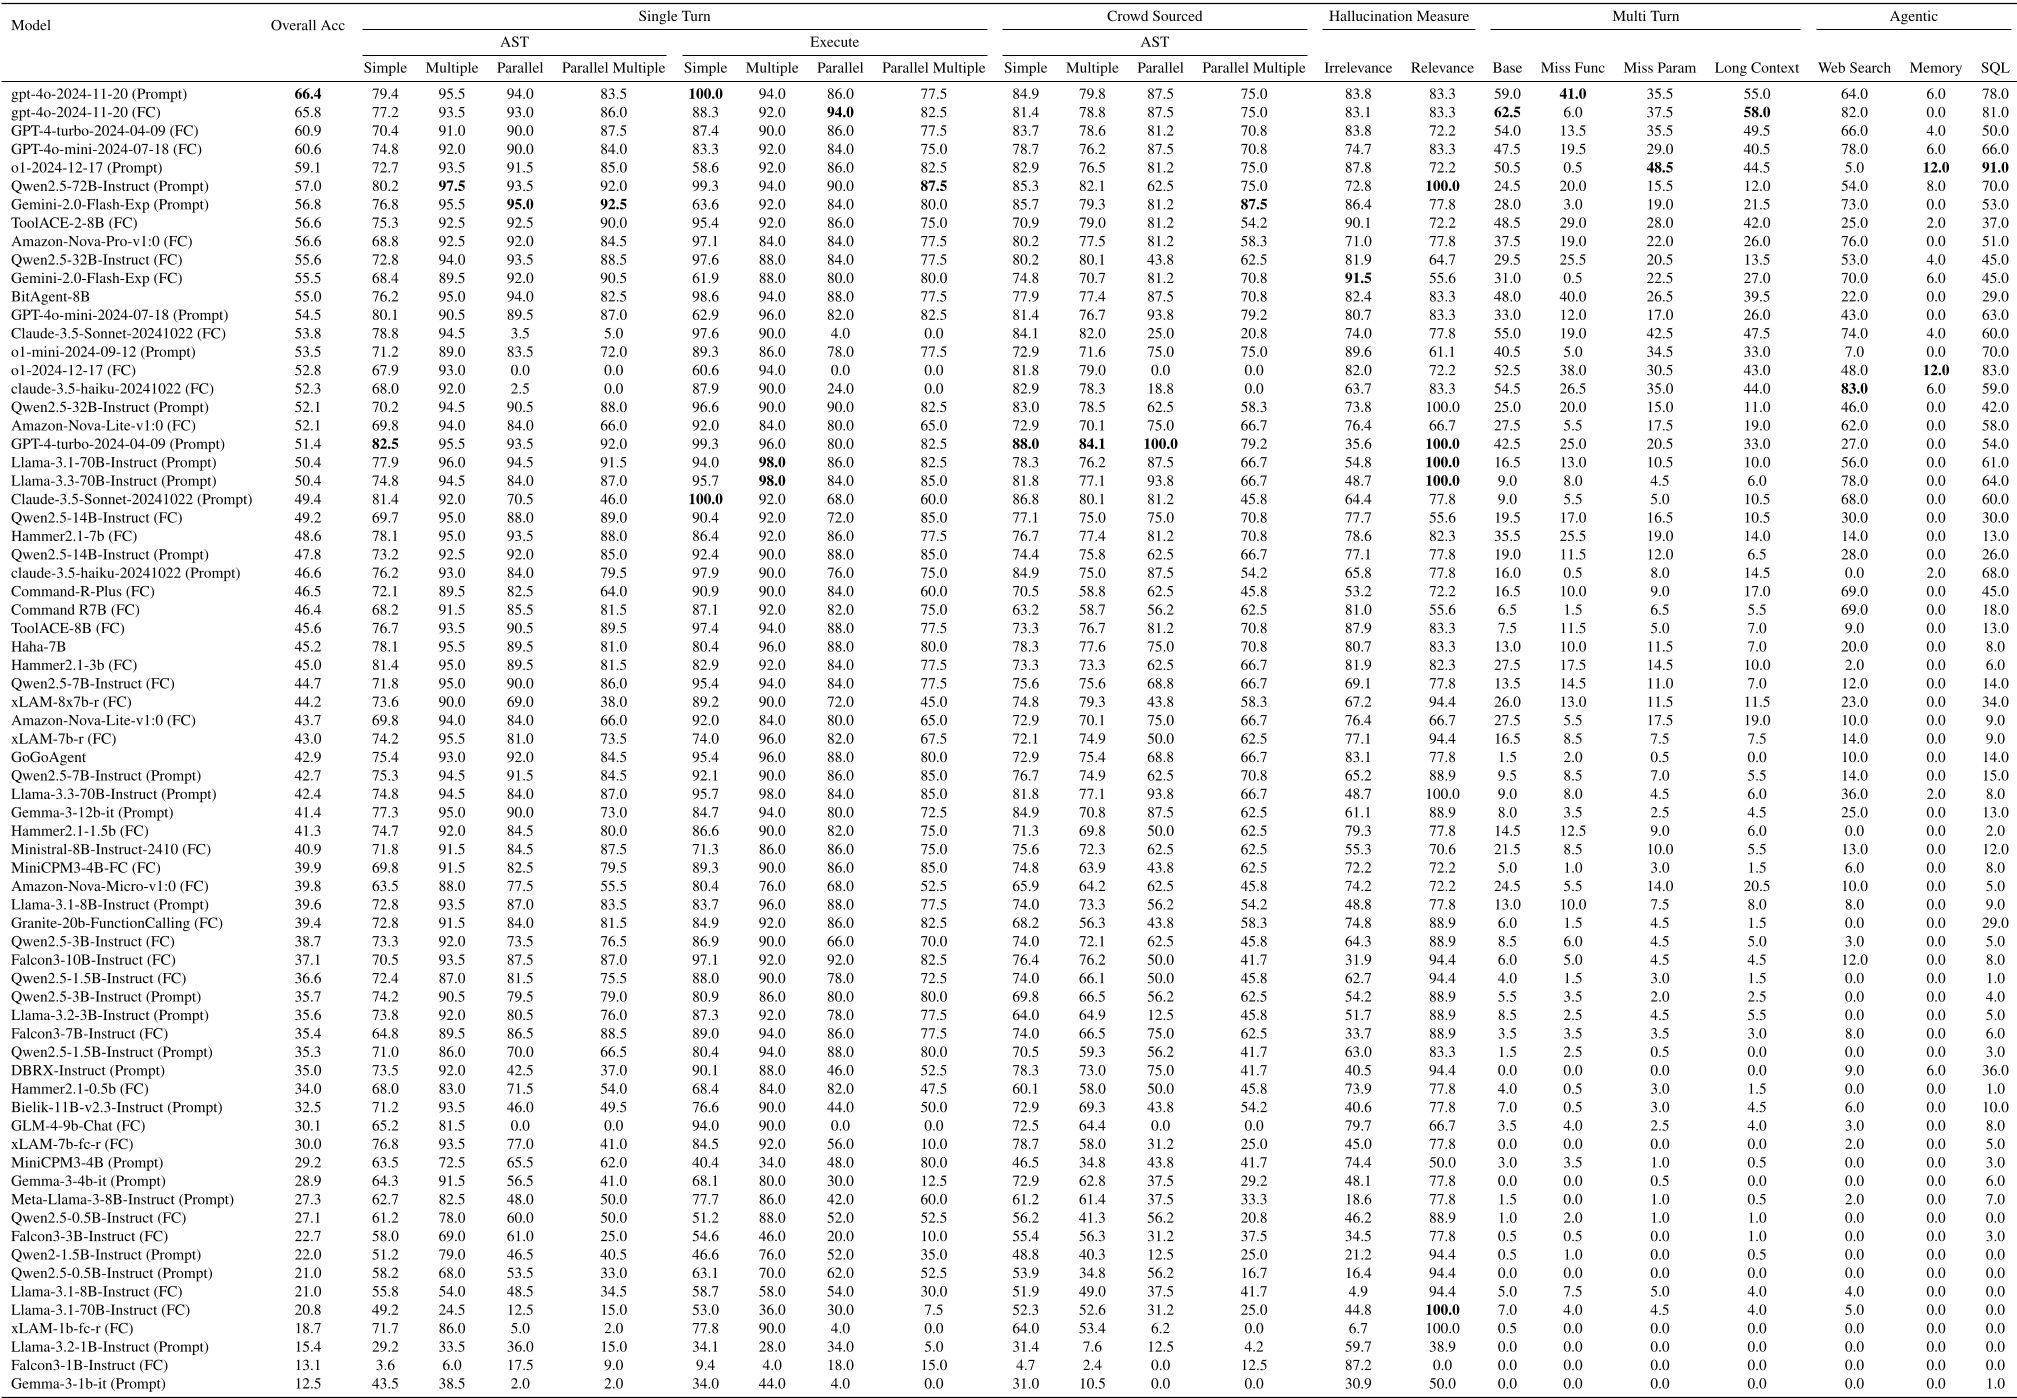 上表展示了 GPT-4o 系列在整体准确率上领跑,但在 Agent 任务特别是 Memory 任务中,所有模型几乎全军覆没。
深度洞察与总结
总结 (Takeaway): BFCL 证明了仅仅把输出格式化成 JSON 是远远不够的。真正的 Agent 能力在于状态感知(Environment State Awareness)。
局限性 (Limitations): 尽管 AST 匹配非常有效,但对于高度动态、输出具有无限可能性的开放式任务,依然需要更精细的逻辑验证。此外,目前的 SQL 和 Web Search 场景依然相对受限。
未来展望 (Future Work): 作者指出,未来的 AI 开发不应只关注单轮准确率,如何让模型像操作系统一样管理上下文、处理状态回滚和动态依赖,才是通向“通用智能体(General Agents)”的必经之路。
BFCL 现已开放,开发者可通过 Gorilla Leaderboard 实时查看各大模型的战况。