
Bf-Tree:重塑 B-Tree,实现超内存场景下的读写全能王
Bf-tree: A modern read-write-optimized concurrent larger-than-memory range index
本文提出了 Bf-Tree,一种针对超内存(Larger-than-memory)场景重构的现代 B-Tree 索引。通过引入 variable-length mini-pages 机制及基于循环缓冲区的内存管理,Bf-Tree 成功融合了 B-Tree 的扫描优势与 LSM-Tree 的写性能。
TL;DR
在数据库存储引擎领域,B-Tree(读友好)与 LSM-Tree(写友好)的战争已持续多年。近日,来自威斯康星大学麦迪逊分校与微软研究院的学者提出了 Bf-Tree,通过引入 变长微页 (Mini-pages) 机制,彻底打破了“鱼与熊掌不可兼得”的魔咒。在超内存负载下,它的点查性能是基准测试的 2 倍,写性能提升 6 倍,同时保持了 B-Tree 优秀的扫描性能。
1. 痛点:为什么传统的 B-Tree 变慢了?
尽管 B-Tree 物理上与磁盘 4KB 扇区对齐,但在现代高并发、非均匀分布的负载下暴露出两个致命缺陷:
- 写放大 (Write Amplification):更新一个 100 字节的记录,必须重写整个 4KB 甚至更广的数据页。
- 缓存污染 (Cache Inefficiency):如果你只想缓存页里最热的那条数据,对不起,B-Tree 强迫你把整页(包含大量冷数据)都塞进宝贵的内存里。
虽然前人尝试过用 Delta Record(如 Bw-Tree)或记录缓存(如 Anti-Caching),但往往会引入过长的指针链导致读性能下降,或者无法支持高效的扫描。
2. 核心直觉:缓存页不应是磁盘页的镜像
Bf-Tree 的天才之处在于解耦了内存布局与磁盘布局。
- 磁盘上:依然保留标准的页组织,方便 block-based IO。
- 内存中:引入 Mini-page。它不再是磁盘页的副本,而是根据需要动态增长的“瘦身版”页面。
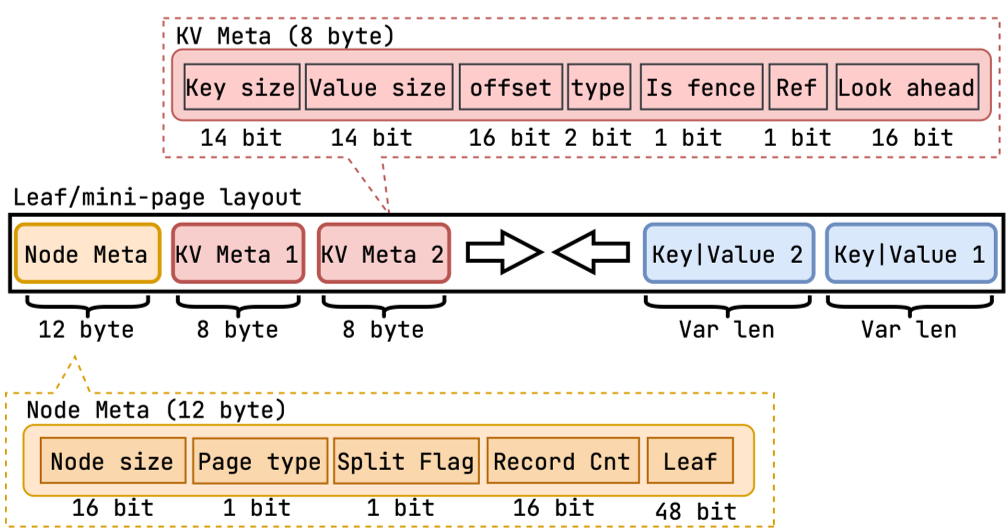 图 1: Bf-Tree 架构,Buffer Pool 中存储的是变长的 Mini-pages,而非固定大小的 Page。
3. 技术深挖:变长缓冲区管理 (Variable-length Buffer Pool)
如何管理一堆变长的内存块,且不产生碎片?Bf-Tree 设计了一个基于 循环缓冲区 (Circular Buffer) 的新型分配器:
- 三区域管理:通过 Head, Tail 和 Second-chances 三个指针将内存划分为“就地更新区”和“访问时复制区”。
- 热度感知:当数据页被访问时,如果它位于 Second-chance 区域,会被重新泵回 Tail(类似于 LRU 但更轻量)。
- 动态合并:当 Mini-page 增长到接近 4KB(阈值可调)或变冷时,系统会发起异步 Merge,将其合入磁盘基准页。
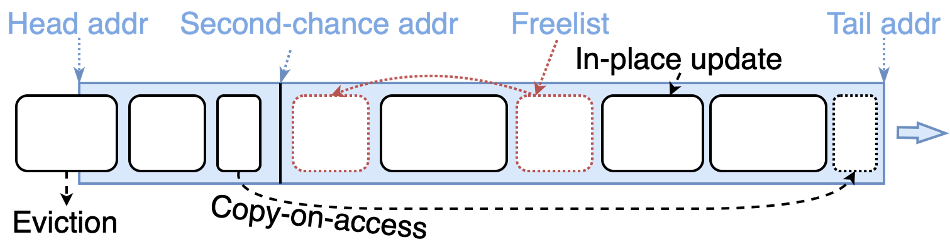 图 2: 管理 Mini-pages 的循环缓冲区设计,有效解决了内存碎片与热点追踪问题。
4. 实验战果:全方位的跨代碾压
在 YCSB 负载下,研究人员对比了业界标杆 RocksDB、Leanstore 以及高性能 B-Tree。
- 写吞吐:相比常规 B-Tree 提升了整整 6 倍。
- 扫描性能:得益于自动将 Mini-page 扩展为全页缓存,其扫描速度是 RocksDB 的 2.5 倍。
- 延迟表现:在高偏差(Skewed)负载下,Bf-Tree 的 99分位延迟降低了 50% 以上,因为它能更精准地捕捉热点记录。
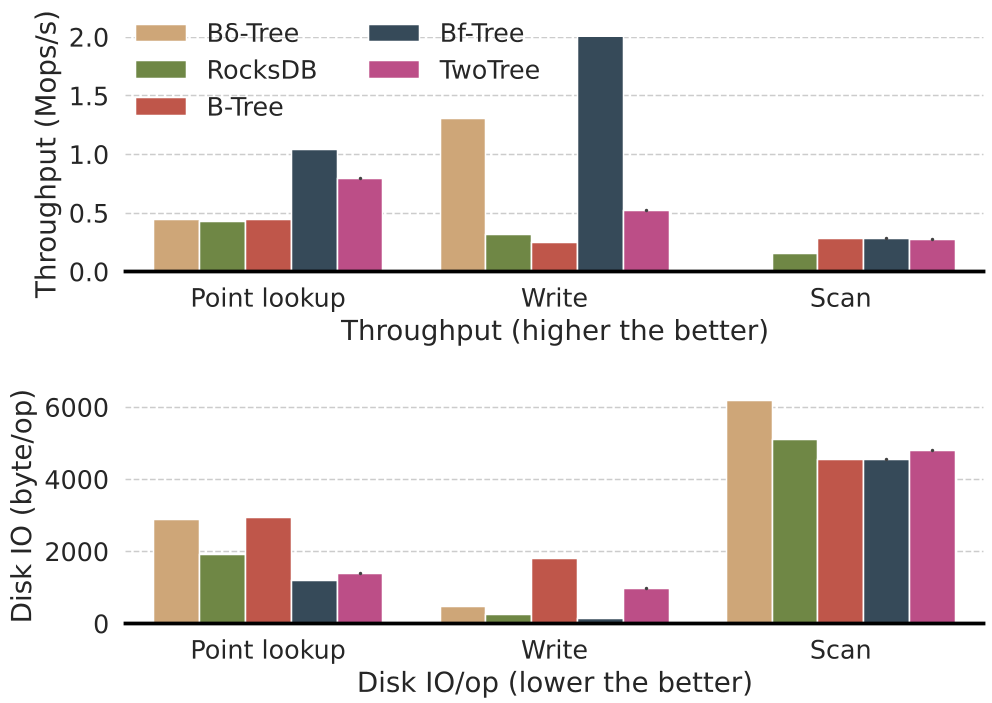 图 3: 各系统在点查、写入、扫描维度的吞吐对比,Bf-Tree 展示了最均衡的顶尖性能。
5. 资深主编点评
Bf-Tree 的成功并非靠复杂的数学推导,而是回归了存储系统的本质:解决粒度错配。它用变长的内存结构消解了固定页大小带来的资源浪费。
该论文值得关注的还有其工程实现:使用 Rust 编写 1.3 万行核心代码,通过 io_uring 压榨 NVMe SSD 的并行带宽,并利用 可验证的形式化方法 确保并发安全性。这不仅是一篇学术论文,更是一份工业级高效存储引擎的实战指南。
总结
Bf-Tree 证明了即使是像 B-Tree 这样古老的结构,在现代内存管理思想的软硬结合下,依然能焕发出远超 LSM-Tree 的生命力。对于下一代分布式数据库和云原生存储引擎而言,这种“变长缓存”的思想具有极强的借鉴意义。