
BLPO:突破视觉上下文瓶颈,让多模态 AI 裁判更懂“人意”
Bi-Level Prompt Optimization for Multimodal LLM-as-a-Judge
本文提出了 BLPO(双层提示词优化),这是一种针对多模态大模型判定器(MLLM-as-a-Judge)设计的自动提示词优化框架。通过将图像转换为任务相关的文本描述并同步优化 I2T 和判定提示词,BLPO 在 AI 生成内容评价任务中显著提升了与人类评价的一致性。
TL;DR
随着生成式 AI 的爆发,用大模型当“裁判”(LLM-as-a-Judge)评价 AI 生成图片已成主流。但多模态模型(MLLM)有个致命伤:没法同时看太多张图(长上下文瓶颈)。Meta AI 与 Emory University 的研究者提出了 BLPO (Bi-Level Prompt Optimization) 框架,通过“同步优化翻译官(I2T Prompt)与判官(Judge Prompt)”,成功在有限的上下文窗口内实现了高效、精准的自动提示词迭代,显著提升了 AI 裁判与人类审美的一致性。
1. 痛点:为什么 AI 裁判的“视力”受限?
传统的自动提示词优化(APO)依赖于一种“尝试-纠错”(Trial-and-Error)的范式:模型先做题,把错题集喂给优化器 LLM(如 GPT-4o),让它总结规律并改写提示词。
但在多模态领域,这个路子走不通:
- 视觉 Token 爆炸:一张图片动辄占用成百上千个 Token,想让模型同时对比 10 多张“错题”图片?显存和推理能力直接崩掉。
- 信息流失:如果把图转成文字(Caption),传统的描述器只会说“图中有一个人”,而忽略了评价 AI 生成图最关键的“手指是否有 6 根”、“光影是否违背物理定律”等局部细节。
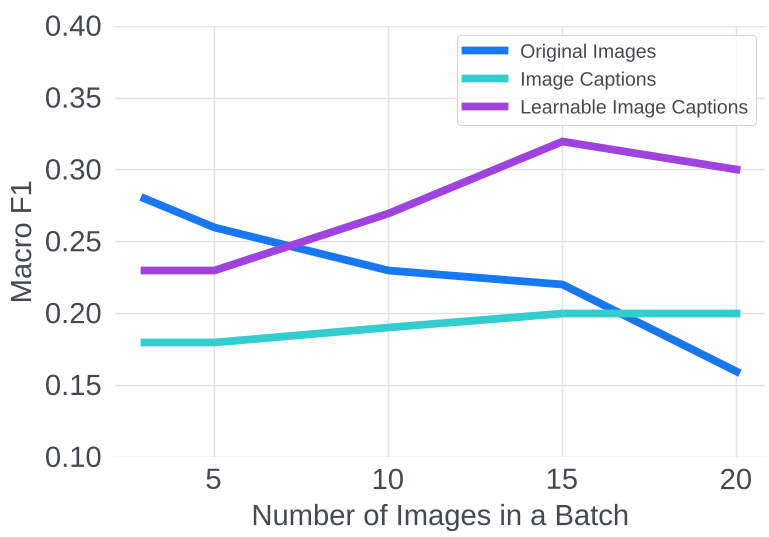 图 1:实验证明,随着 Context 中图片数量增加,传统优化方法的性能(蓝色线)会因推理负载过重而急剧下降。
2. 核心方案:双层优化 (Bi-Level Optimization)
BLPO 的核心直觉是:既然看图太累,我就找个“专业翻译”。这个翻译不仅能把图转成文字,还能根据裁判的评价标准,专门翻译那些“考点”。
2.1 双层架构设计
BLPO 将优化任务拆解为两个嵌套的循环:
- 外层优化 (Outer Loop):针对最终的“判定提示词”(Judge Prompt)进行迭代。它接收翻译好的文本描述、标注标签和预测结果,更新评分标准(如:如何给自然度打分)。
- 内层优化 (Inner Loop):针对“描述提示词”(I2T Prompt)进行迭代。它的目标是:如果目前的翻译导致了判定错误,就调整翻译重点(如:多关注阴影和物体边缘)。
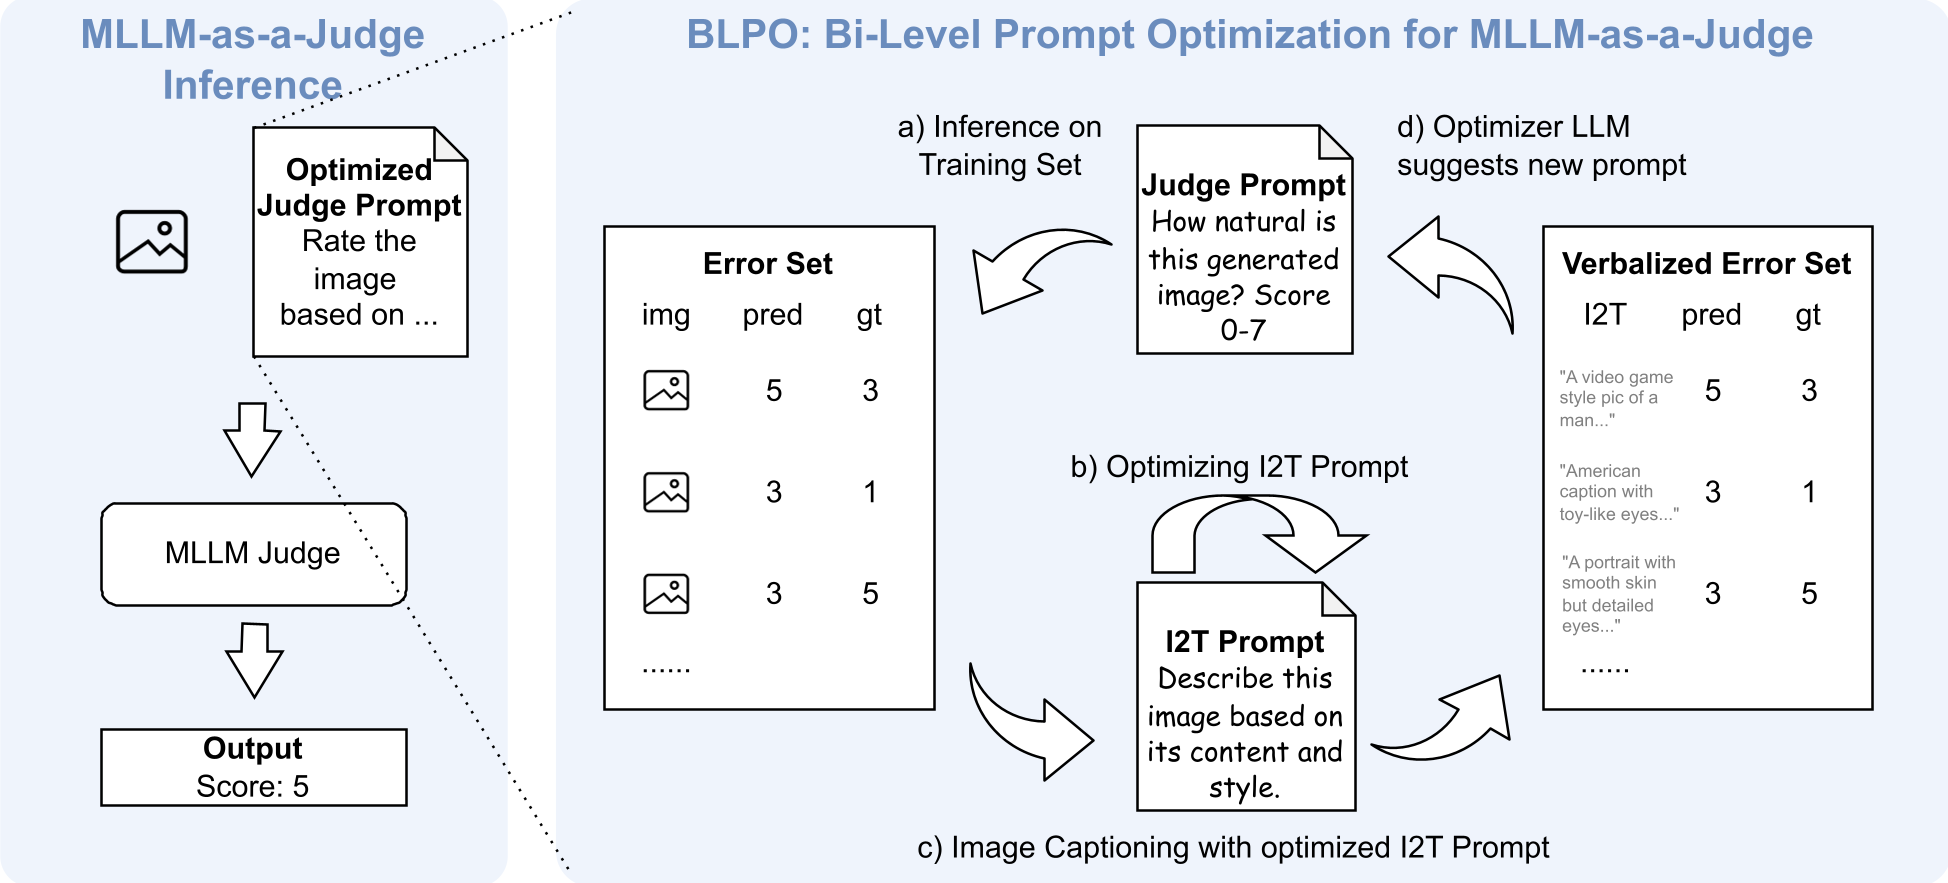 图 2:BLPO 框架示意图。左侧为判定过程,右侧为 I2T 与判定提示词的双层协同更新逻辑。
2.2 公式背后的物理含义
论文中定义了一个基于损失函数的梯度近似。简单来说,内层优化的目标是寻找一个 (I2T 提示词),使得在该描述下的 (判定提示词)更新后,能带来最大幅度的性能提升(Score Maximize)。这就确标了:“翻译官”必须说对“裁判”最关心的话。
3. 实验结果:全线 SOTA
研究团队在 Llama-4 和 Qwen2.5-VL 等主流模型上进行了验证。在涉及安全性(UnsafeBench)、自然度(AGIN)和图文对齐(SeeTRUE)的测试中,BLPO 展现了极强的统治力。
| 核心发现 | 数据支撑 |
|---|---|
| 显著提升 | 在 UnsafeBench 任务中,F1 分数比强基线 TextGrad 高出约 8%。 |
| 快速收敛 | 仅需 5 轮外层迭代,模型就能达到性能峰值。 |
| 稳定性强 | 相比 OPRO 等方法,BLPO 的优化曲线(见下图)更加平滑且单调上升。 |
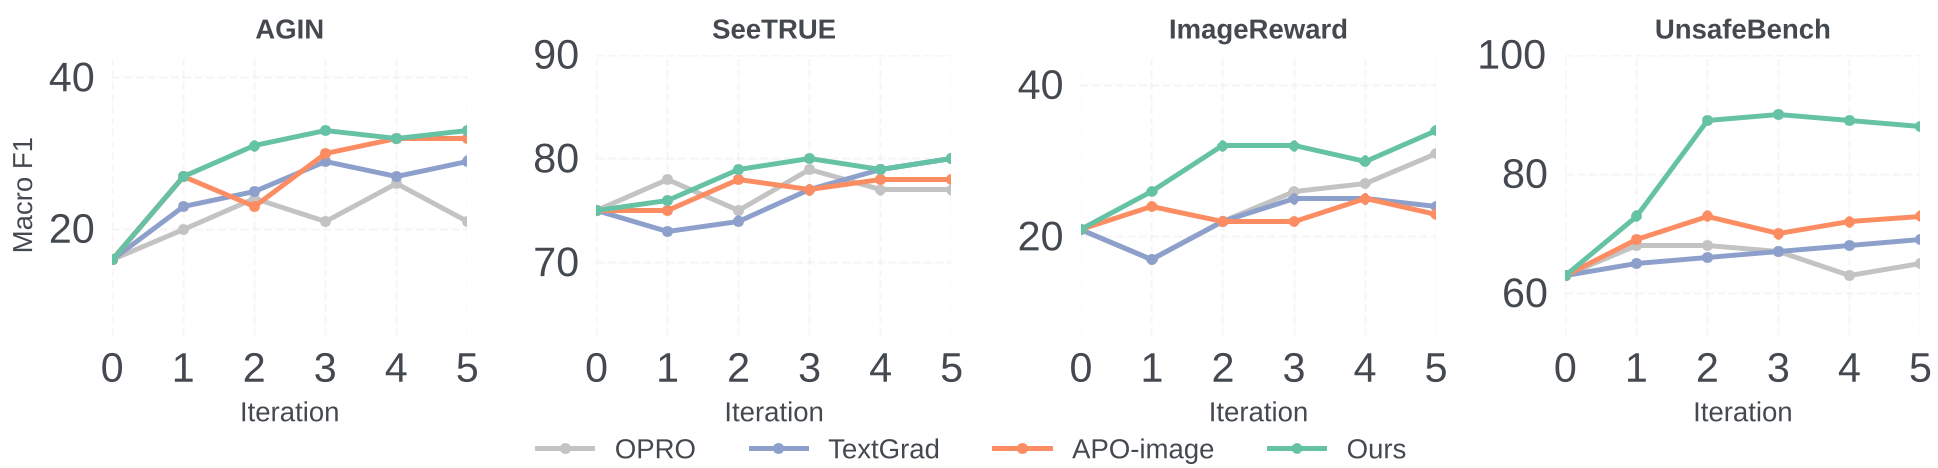 图 3:Llama-4 骨干网络下,BLPO 在四个数据集上的收敛表现均优于传统基线。
4. 深度洞察:为什么这有效?
消融实验(Ablation Study)给出了清晰的答案:
- 固定描述没前途:使用统一的“详细描述这张图”作为 I2T 提示词,效果远不如 BLPO。
- 不仅是裁判准,是眼力好:BLPO 优化出的 I2T 提示词学会了使用各种专业术语,如“检查几何形变”、“分析光照明暗差异”等。
这种“双层协同”实际上是在通过离散提示词更新,完成一种伪梯度下降。它巧妙地规避了多模态模型在原始像素层面的推理负担,转而利用 LLM 强大的文本总结能力来“压缩”视觉信息。
5. 局限与未来展望
- 局限性:虽然解决了 Context 数量问题,但如果视觉缺陷极其细微(如 4K 图中的几个像素噪点),仅靠文本描述可能依然难以完全捕捉。
- 未来方向:这种双层优化思路可以推广到视频评价(Video-as-a-Judge)或者更复杂的自主智能体(Agent)任务中,其中“感知”与“决策”的提示词需要高度协同。
总结
BLPO 证明了在多模态时代,提示词工程不应只是单点突破,而需要系统性的协同设计。通过双层优化,我们终于可以让大模型这位“裁判”在不增加显存负担的前提下,看得越准,断得越清。