
BoostDream:打破快与好的边界,三阶段精炼实现 Text-to-3D 质量飞跃
BoostDream: Efficient Refining for High-Quality Text-to-3D Generation from Multi-View Diffusion
本文提出了 BoostDream,一个即插即用的高效 Text-to-3D 精炼框架。它结合了前馈生成技术(如 Shap-E)的快速初始化能力与 Score Distillation Sampling (SDS) 的高质量优化能力,通过多视图扩散先验实现 3D 资产的细节增强。
TL;DR
BoostDream 是一项旨在提升 Text-to-3D 生成效率与质量的研究。它像是一个“3D 打印精度增强器”:先用极短时间生成一个粗糙模型,再利用创新的 多视图 SDS (Multi-view SDS) 和 法线贴图引导 进行精雕细琢。该方法不仅解决了令研究者头疼的 Janus(多头)现象,还将优化时间缩短了近一倍,且支持 NeRF、DMTet 和 Gaussian Splatting 等主流 3D 表示。
背景定位
在 3D 生成领域,我们长期在“前馈速度”与“优化质量”之间徘徊。虽然像 Shap-E 这样的模型可以秒级出图,但其精细度往往惨不忍睹。BoostDream 的核心直觉在于:与其从一片虚无中开始漫长的优化,不如站在前人的肩膀上(利用粗糙模型作为先验),通过多视图一致性的约束进行快速精炼。
痛点深挖:为何 3D 生成总有“多张脸”?
传统的 SDS (Score Distillation Sampling) 方法在优化 3D 模型时,往往只关注单一视角的 2D 扩散先验。这导致模型在旋转时,由于缺乏全局空间约束,每个视角都想生成一个“正面”,从而产生了多头、多腿的魔幻几何体(即 Janus Problem)。此外,从零开始优化一个神经辐射场(NeRF)极为耗时,且极易陷入局部最优。
核心方法论:多视图协同精炼
BoostDream 提出了一个逻辑严密的三个阶段:
1. 快速初始化 (3D Model Distillation)
系统首先通过前馈模型(如 Shap-E)生成一个粗糙的 3D 资产。为了让这个硬资产变得“可训练”,作者将其蒸馏到一个随机初始化的可微 3D 表示(如 NeRF 或 3DGS)中。这一步只需 200 次迭代,极速建立几何雏形。
2. 多视图渲染系统与逻辑
这是解决 Janus 问题的关键。作者设计了一个多视图采样策略:在球面上随机采样一个视角后,自动生成其正交或特定旋转角度的其他三路视角,拼接成一个 的组合图。
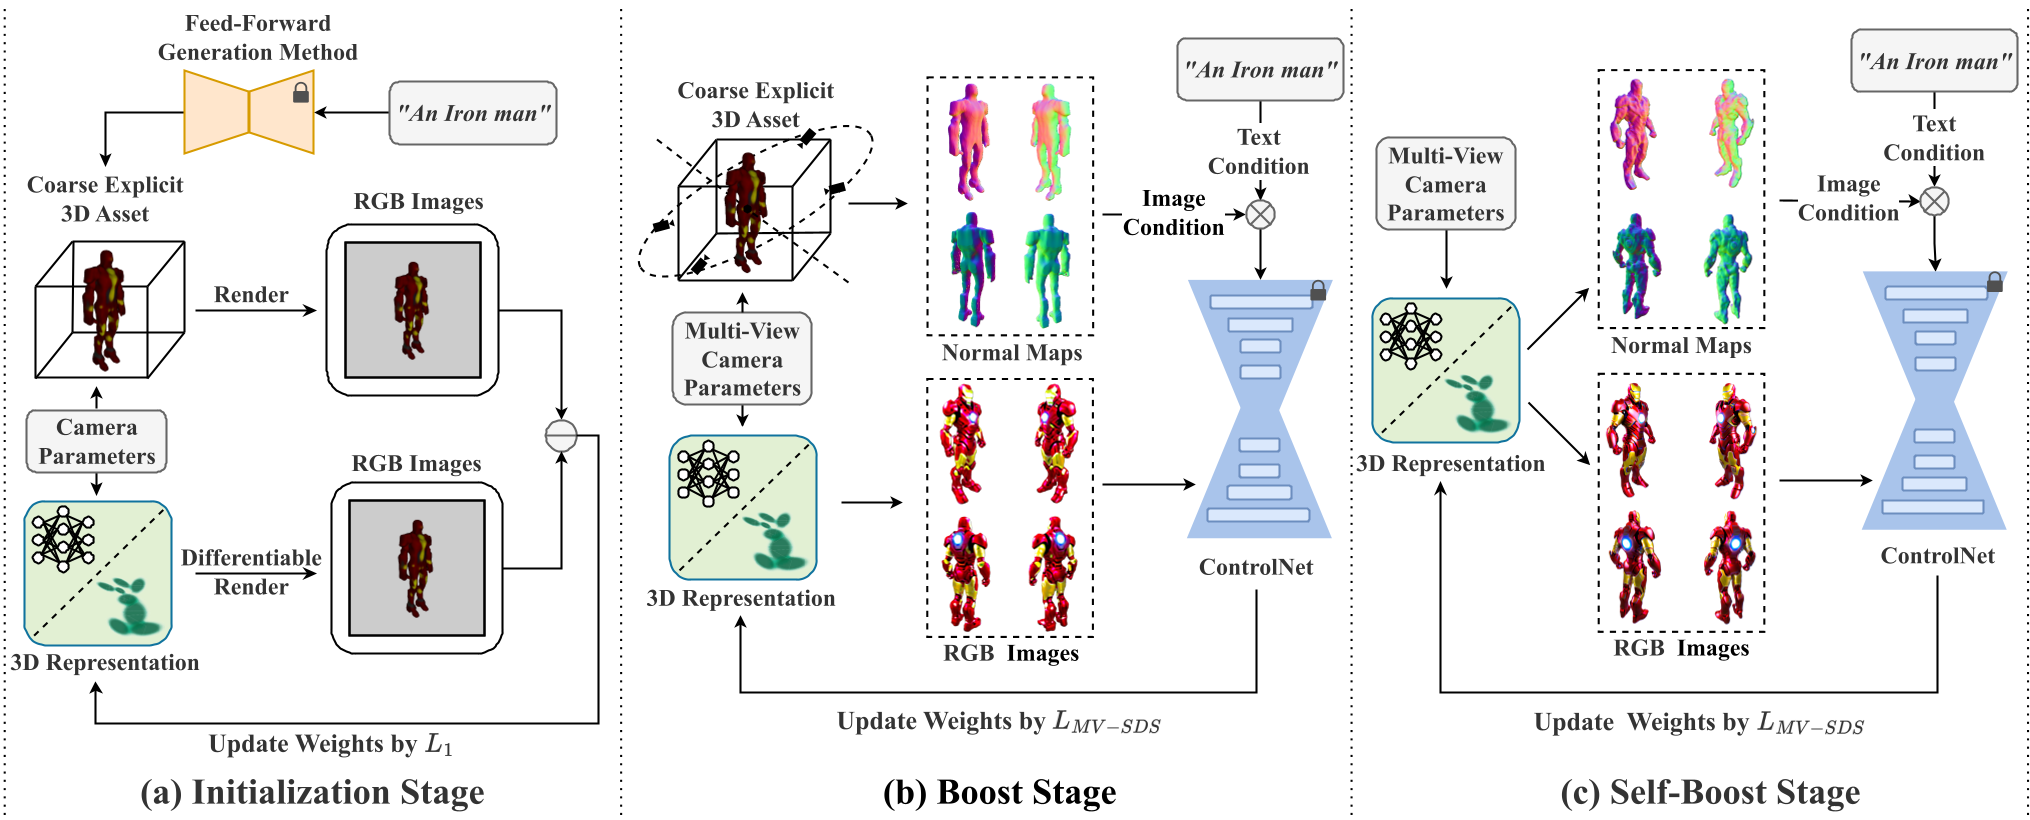 图 2:BoostDream 三阶段框架概览
3. 法线贴图引导的多视图 SDS
不同于传统的只用文本引导,BoostDream 引入了 ControlNet 机制。它利用从 3D 模型中渲染出的 法线贴图 (Normal Maps) 作为空间约束信号。法线贴图能捕捉到头发、褶皱等几何细节,相比深度图,它对表面朝向更敏感,产出的细节更真实。
公式表达为一种双重条件的噪声估计: 其中 代表多视图法线图,确保生成的纹理与粗糙几何保持高度对齐。
实验战绩:更快、更准、更美
研究团队在多种可微表示上验证了 BoostDream 的通用性:
- 效率提升:在 V100 GPU 上,BoostDream 精炼一个模型仅需约 33 分钟,而 DreamFusion 需要近 1 小时。
- 视觉震撼:对比实验显示,BoostDream 生成的资产在光影质感、几何完整度上远超 Magic3D。
- 无缝编辑:由于引入了法线贴图引导,该方法还具备极强的编辑能力。你可以在保持 Iron Man 姿态不变的情况下,将其一键重绘为 Batman。
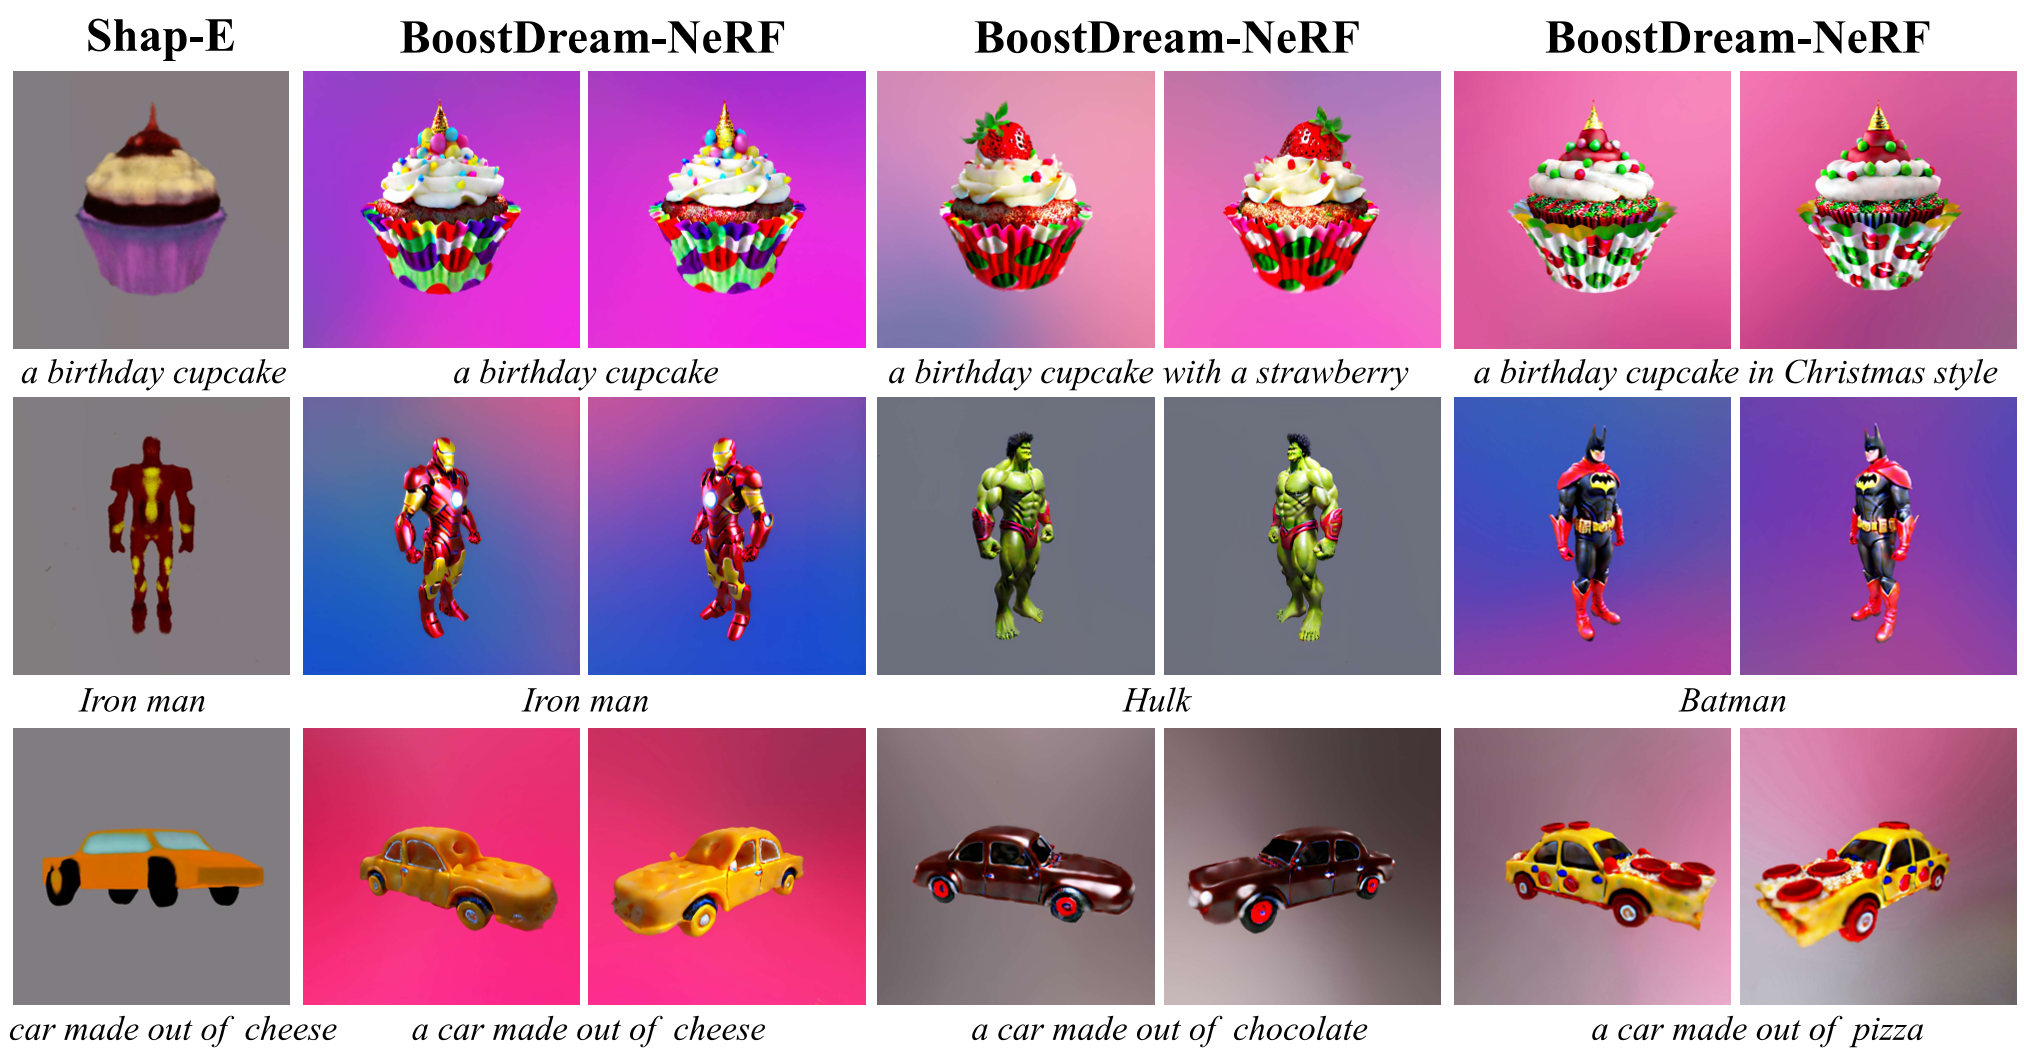 图 4:与 Shap-E、DreamFusion 和 Magic3D 的对比,可见 BoostDream 在细节和一致性上的显著优势
局限性与洞察 (Critical Analysis)
尽管 BoostDream 表现出色,但它仍受限于底层 2D 扩散模型的偏见。如果 Stable Diffusion 本身对某个物体的多视图理解有误,BoostDream 也很难完全修正。此外,虽然三阶段流程自动化程度高,但阶段间的权重转换(如从粗糙指引到自指引)仍需细致调优。
总结 (Takeaway): BoostDream 最大的贡献在于它证明了 “粗模初始化 + 多视图法线约束” 是一条高性价比的 3D 生成工业化道路。这种“先成型、后精修”的策略,为 VR/AR 和游戏产业的大批量 3D 资产自动生成提供了坚实的技术基石。