
BoostDream:打破效率与质量的边界,让 Text-to-3D 进入“高清重制”时代
BoostDream: Efficient Refining for High-Quality Text-to-3D Generation from Multi-View Diffusion
本文提出了 BoostDream,一种高效且即插即用的 Text-to-3D 细化方法。该方法结合了前馈生成的高速性与 Score Distillation Sampling (SDS) 的高质量,通过多视图扩散先验,实现了将粗糙 3D 资产快速转化为高保真资产的 SOTA 效果。
TL;DR
在 3D 内容生成的赛道上,速度与质量一直是鱼和熊掌。基于前馈生成的模型(如 Shap-E)几秒钟出一个“草稿”,但细节惨不忍睹;基于优化的方法(如 DreamFusion)虽然精致,却要消耗数小时。BoostDream 的出现终结了这一尴尬局势。它作为一个“即插即用”的 3D 细化框架,能够将粗糙的 3D 模型作为起点,通过多视图扩散先验,在极短时间内将其“重置”为媲美专业级的 3D 资产。
痛点深挖:为何 3D 生成总是“慢”而“乱”?
目前 Text-to-3D 领域主要有两个症结:
- 数据孤岛:相比于拥有几十亿图文对的 2D 图像领域,高质量 3D 数据集(如 Objaverse-XL)依然极度稀缺且噪声巨大,导致前馈生成模型语义理解能力弱、产出模糊。
- Janus 问题:SDS(得分蒸馏采样)在从 2D 扩散模型提取 3D 知识时,由于缺乏空间一致性,往往会给马生成六条腿,或者让高达长出好几条胳膊,这种“多头怪”现象被称为 Janus 效应。
Methodology:三步曲实现“平滑升级”
BoostDream 的核心在于它不追求从零开始,而是基于已有的“粗稿”进行精雕细琢。
1. 快速初始化 (3D Representation Initialization)
首先,利用简单的 L1 损失,将 Shap-E 生成的离散资产蒸馏到可微 3D 表示中(支持 NeRF, DMTet, 3DGS 等)。这一步仅需 200 次迭代,为后续工作定下“形”。
2. 多视图渲染与多视图 SDS (The Core)
这是本文的核心 Insight。作者设计了一套专门的多视图渲染方案。在每次迭代中,系统同时渲染 4 个相互正交视角的图像并拼成大图。
- 公式直觉:通过 ,模型不仅在学习文字语义,更在学习视角间的逻辑关联。
- 法向图引导 (Normal Map Guidance):BoostDream 利用 ControlNet 的思想,将多视图一致的法向图作为控制项。法向图包含了极其精细的表面几何信息(如肌肉纹理、服装褶皱),这比深度图(Depth)或边缘检测(Canny)能提供更强的几何约束。
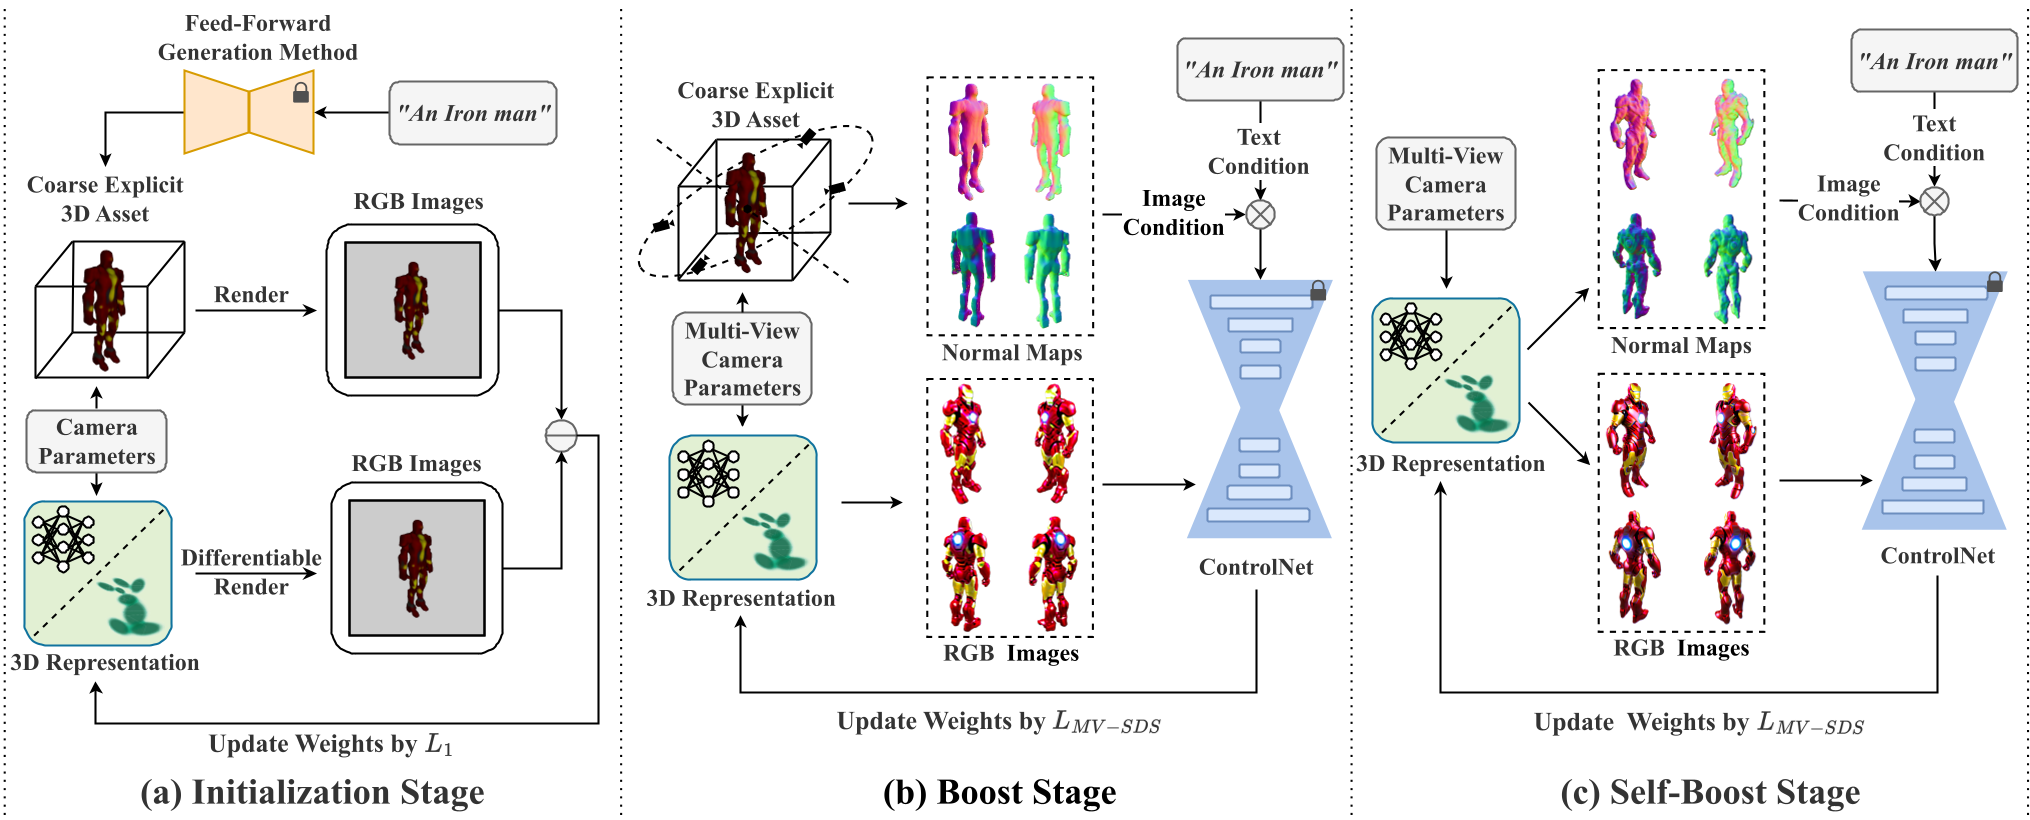 图 1:BoostDream 整体框架,展示了从粗糙初始化到双重阶段引导(Boost & Self-Boost)的过程。
实验与结果:速度与美学的双重飞跃
BoostDream 的实验设计非常硬核,跨越了三种主流 3D 表示方法:
- 效率对比:在 V100 上,BoostDream-NeRF 仅需约 2038 秒,而 DreamFusion 则需要 3519 秒。在迭代次数上,BoostDream 从 15000 次压缩到了 5000 次。
- 质量巅峰:对比图 4 可见,DreamFusion 产生的象头往往是混乱的,而 BoostDream 生成的象群或机甲不仅纹理锐利,更重要的是——它完全解决了“多头”问题。
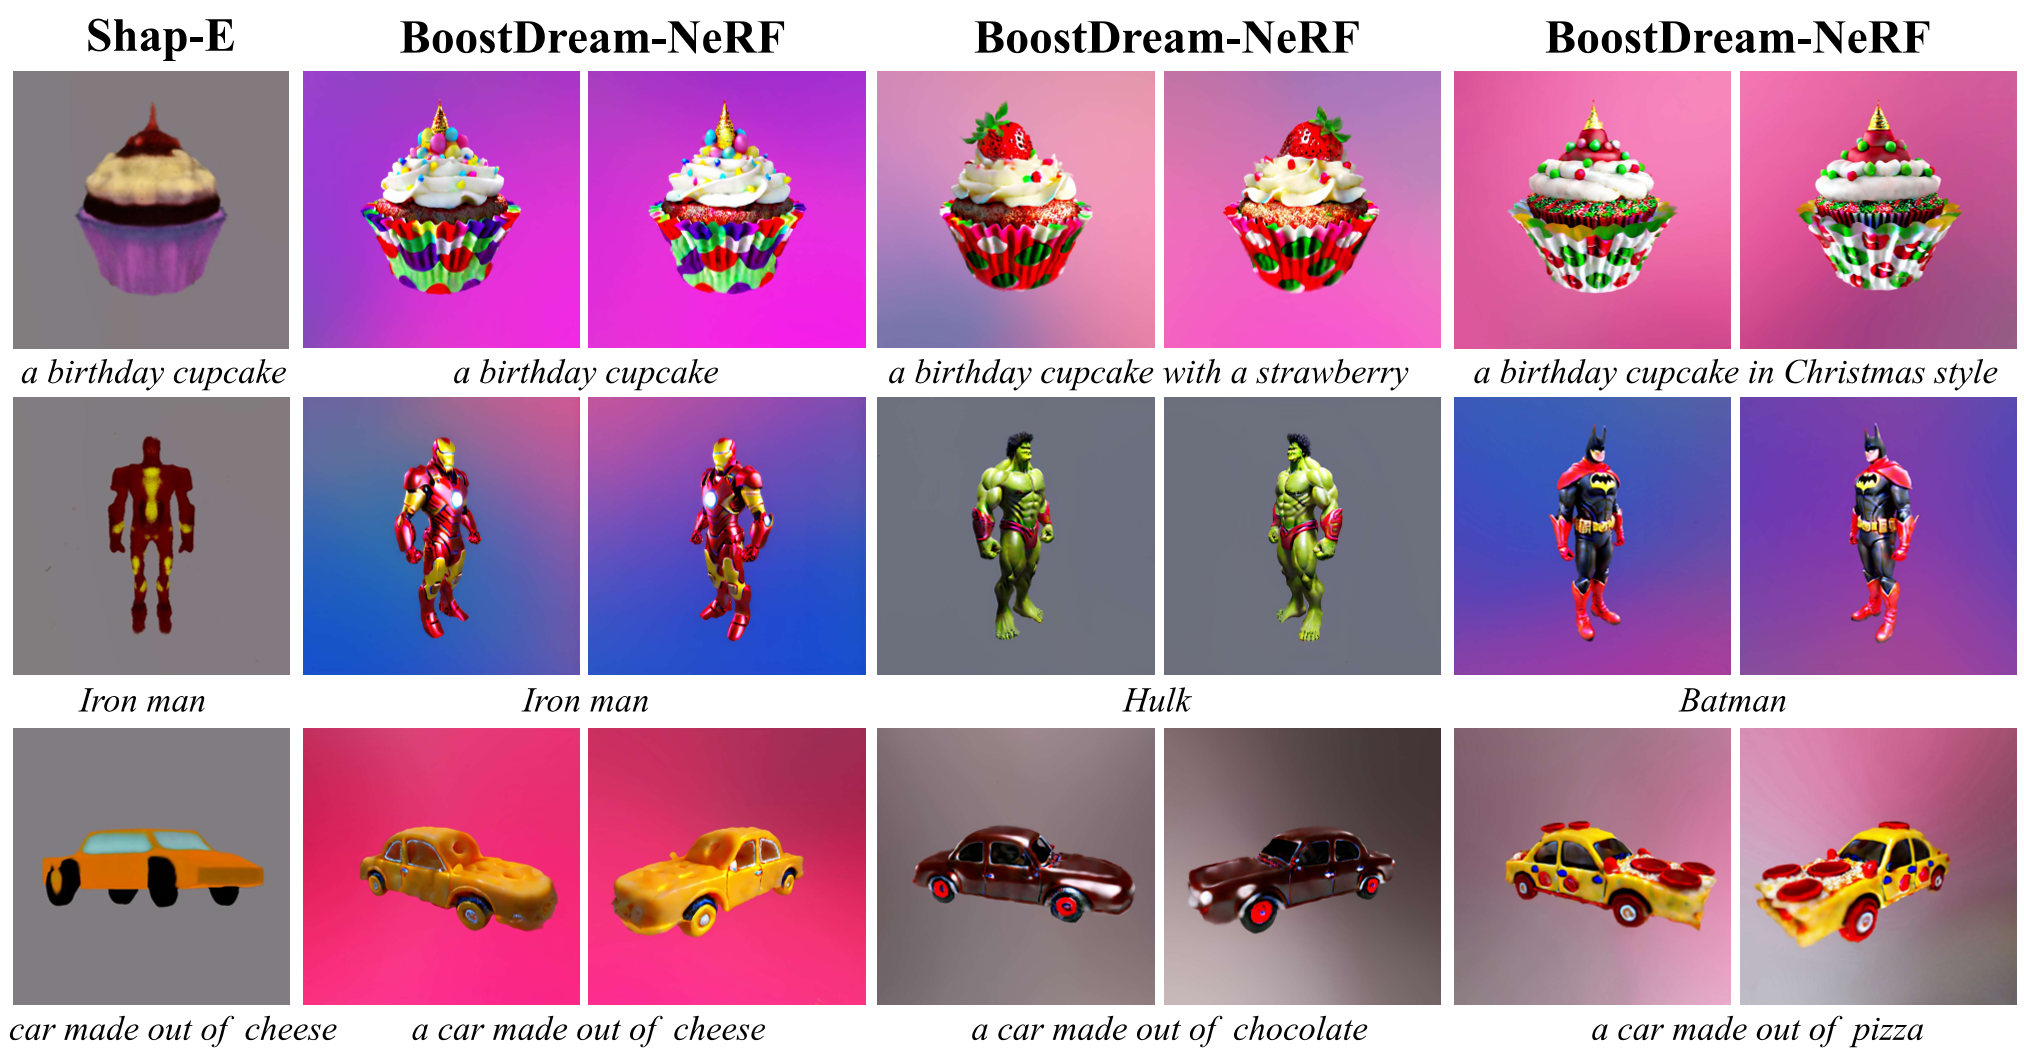 图 2:与 Shap-E、DreamFusion 和 Magic3D 的对比。可以观察到 BoostDream 在 Prompt 相关性和几何准确度上的明显优势。
深度洞察:为何“法向图”是关键?
在消融实验中,作者对比了 Canny、Depth 和 Normal Map。结论非常明确:
- Canny 只有线条,丢失了 3D 饱满度;
- Depth 虽然能控形,但对细小凹凸(纹理)不敏感;
- Normal Map 能够捕捉表面法线的微小偏移,这是 3D 渲染中体现“高级感”和细节真实感(Like hair or surface irregularities)的灵魂。
总结与局限性
BoostDream 成功的关键点在于:它意识到了 2D 扩散模型作为 3D 先验时,空间一致性才是第一生产力。
- 贡献:它是一个通用的“加强插件”,能让现有的低质量 3D 生成器瞬间获得产业级输出能力。
- 局限性:尽管显著提速,但它仍然依赖于每轮优化的显存消耗(渲染 2x2 拼图),对于显存较小的消费级 GPU 可能仍有压力;此外,其质量上限依然受限于底层的 2D 控制模型(如 Stable Diffusion 1.5)。
未来,若能结合更大规模的基础模型(如 SDXL),BoostDream 有望将 3D 生成的精度推向电影级水平。