
打破字节蒸馏的天花板:单次前向 End-Of-Token 与过训练缩放
Breaking the Token Ceiling: Distilling Smaller, Stronger Byte Models
本文研究字节模型蒸馏中的 logits 转换与过训练缩放。作者提出单次前向的 Marginalize-It 近似转换和 End-Of-Token 精确转换,并发现 End-Of-Token 蒸馏在低算力落后但高算力渐近性能超过 Token 蒸馏。论文外推预测其平均下游准确率高 4%,达到同精度约只需六分之一有效文本数据。
核心速览
TL;DR 这篇论文把“小字节模型能否从大词元模型蒸馏”的问题拆成两个环节:先如何一次教师前向把词元 logits 变成字节 logits,再如何判断字节与词元学生在过训练下谁有更高天花板。作者给出 Marginalize-It 近似法和 End-Of-Token 精确法,并在约 12.8 亿 layer 参数、最高 1 万亿字节数据的六组实验中发现:词元蒸馏在低算力阶段领先,字节蒸馏在高算力阶段反超,其中 End-Of-Token 蒸馏的渐近平均下游准确率预测比词元蒸馏高 4.0 个百分点,且达到词元蒸馏上限约只需六分之一有效文本数据。
从学术坐标看,这更像一篇系统实证与缩放定律论文,而不是单纯提出一个训练 trick。论文在摘要和 1.1 节把它定位为首次大规模同时扫描 tokenization scheme 与 training objective 的 decoder-only dense transformer 过训练研究。它真正推进的地方,是把“字节模型数据效率”和“蒸馏缩放上限”这两个通常分开讨论的问题放在同一条计算预算轴上比较。
问题与动机
已有蒸馏研究大多建立在学生和教师共享 tokenizer 的前提上。这个前提在工程上很自然:教师输出约 12.8 万维词元 logits,学生只需要在同一个词元空间里匹配分布。但一旦学生使用字节词表,教师分布就不能直接复用,因为一个 BPE token 对应一段字节序列,下一字节分布必须通过词元分布对字节位置边缘化得到。Hayase 和 Phan 等工作的 exact byte probabilities 路线已经能完成这种转换,但通常需要多次教师推理;在大规模离线蒸馏中,教师推理本身已经昂贵,多次前向会让 teacher dump 的生成成本失控。
存储问题同样尖锐。Table 10 说明,Llama 3-8B 的词元 logits 维度高达 128256,若为每个词元保存全部 logits,成本会迅速变成 exabyte 级别;常用 top-k 截断虽然可行,却要求确定一个足够大的 k。论文的 storage 设计在 Table 10 中通过把 1 个词元的成本与 4.5 个字节的字节 logits 成本对齐,求得 k 约为 600。字节模型的优势在于词表只有约 260 或 261,因此可以保存完整字节 logits,而不必依赖词元端 top-k 截断。
更深层的问题是缩放假设。字节模型因为每个原始词元被拆成平均 4.5 个字节,训练序列更长,每单位数据上的 FLOPs 更高;蒸馏目标和监督目标也会改变损失景观。因此,不能简单把不同 tokenizer 的 BPB 曲线排成一条公平阶梯。论文在 Section 5.4 与 Section 6.6 中反复指出:在约 220B token 数据点附近,字节模型可能拥有更低 BPB,却在下游基准上明显落后于词元蒸馏模型。这正是本文要把 BPB 再次校准到 downstream error scaling law 的原因。
核心章节:从 logits 转换到缩放边界
1. 近似转换:Marginalize-It 先证明“够用”,但没有消除偏差
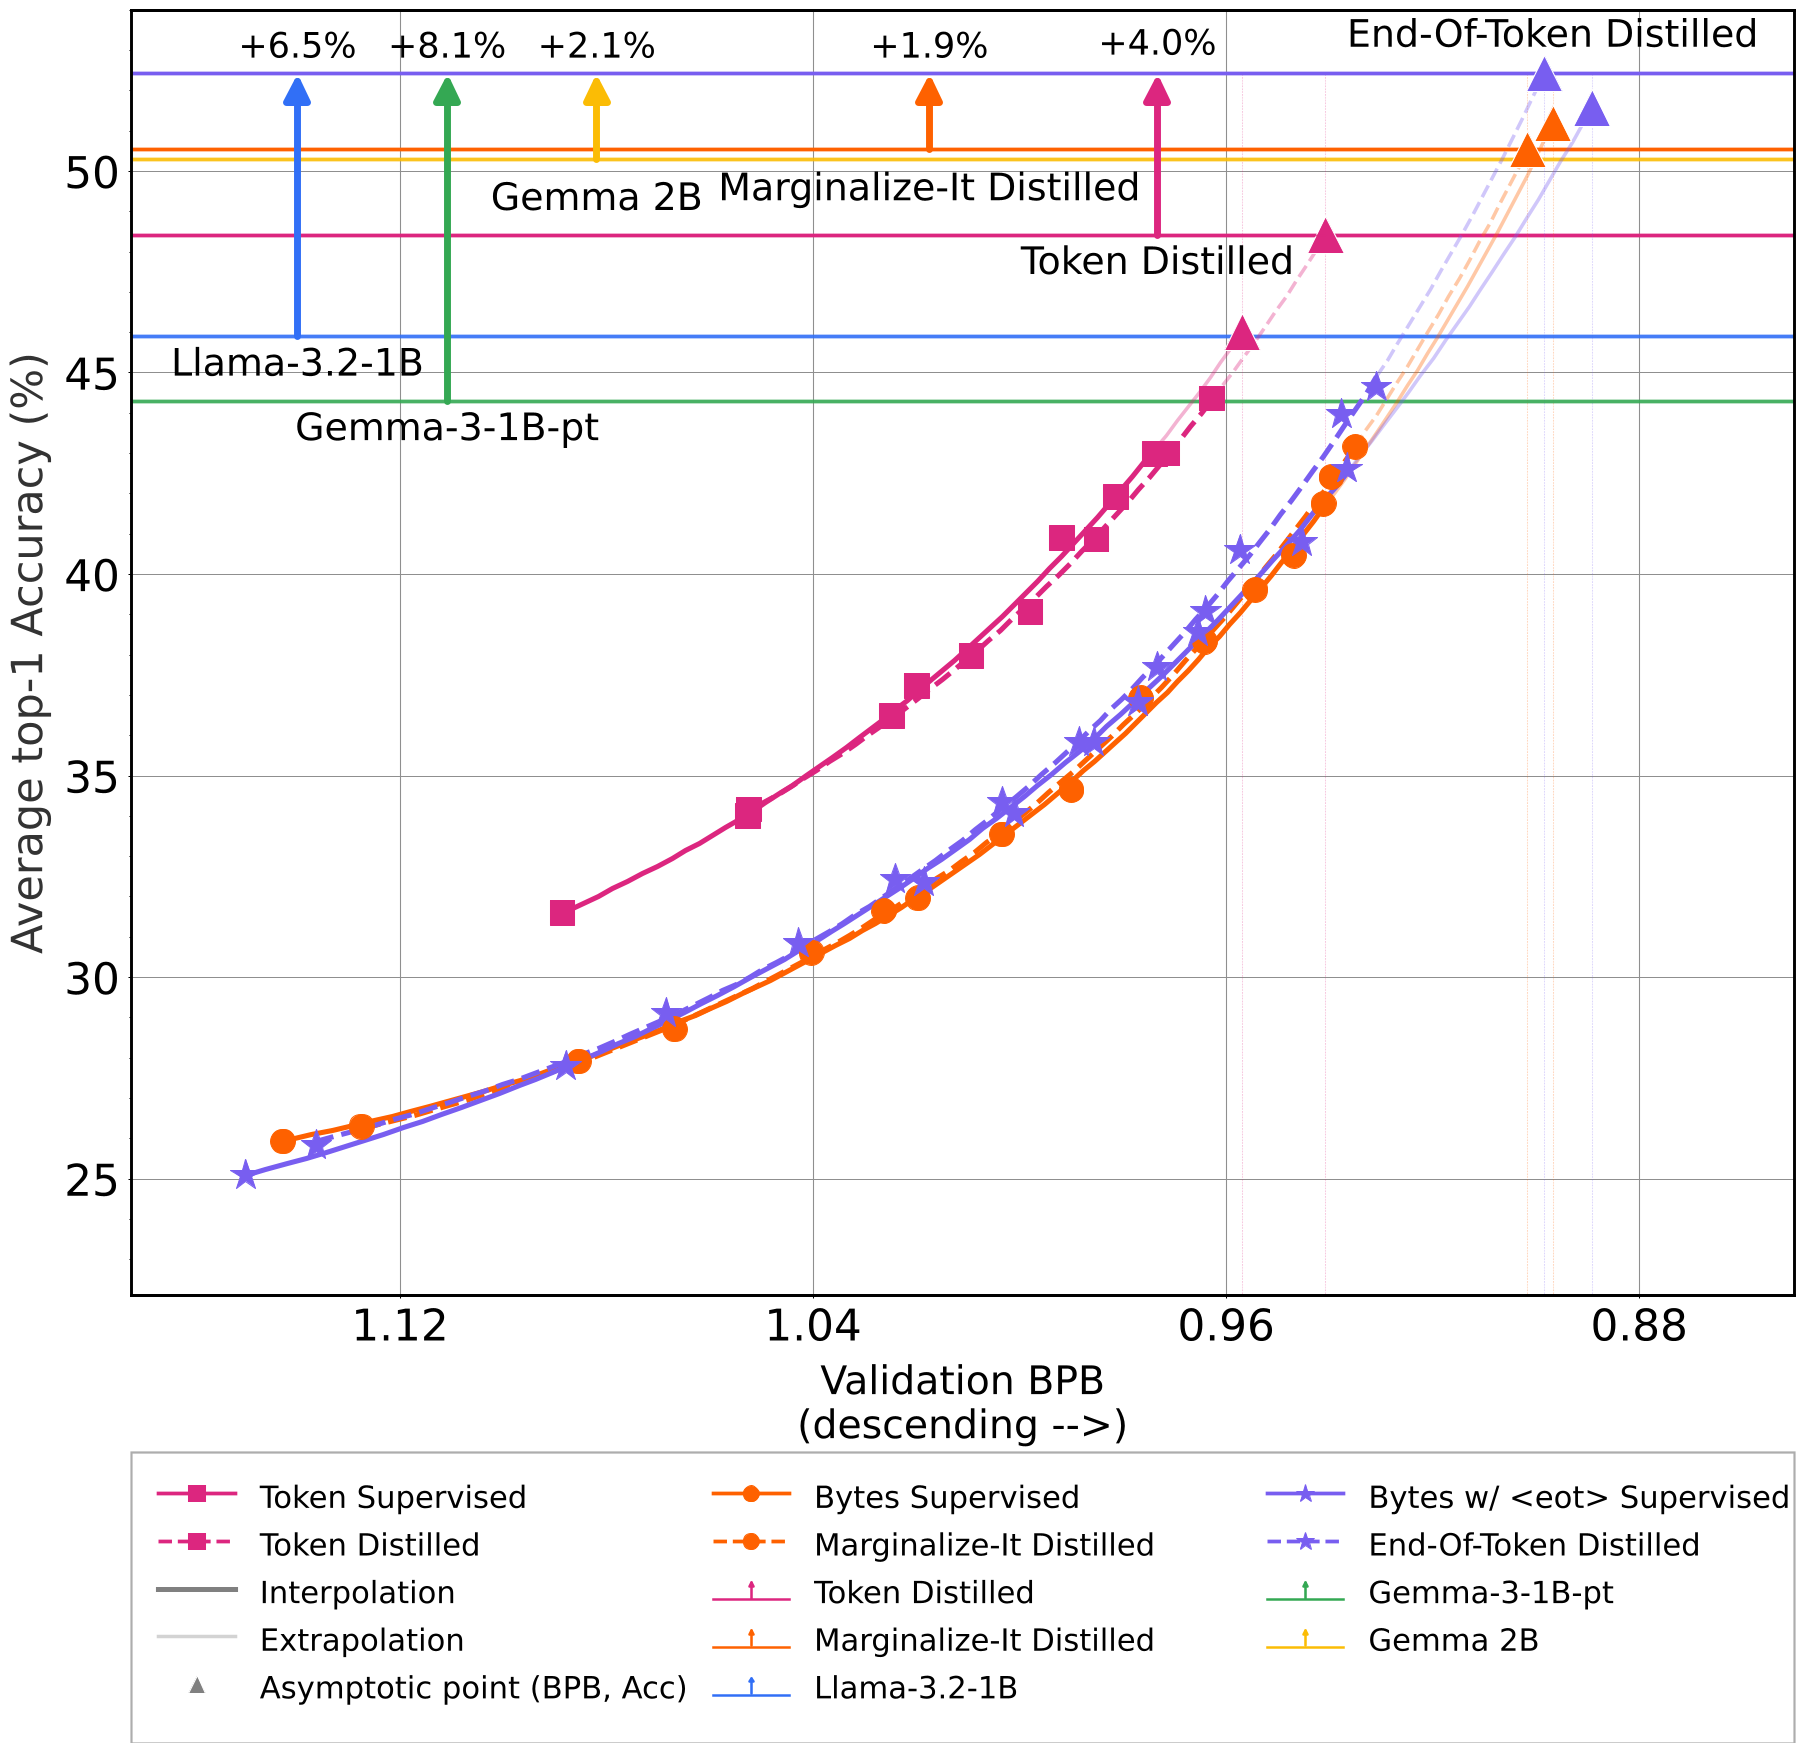
Figure 1 给出了全文最重要的宏观判断:在 lr=4e-3 下,Token-1B 蒸馏模型在低 FLOPs 区域领先,但曲线更早饱和;End-Of-Token 蒸馏模型起步较差,却在更高计算预算下抬升平均下游误差 scaling law 的上限。该图的 caption 同时给出渐近预测:End-Of-Token Distilled 相比 Token Distilled 高约 4%,相比 Marginalize-It Distilled 高约 1.9%,相对三个 open-weight 模型分别约高 6.5、8.1 和 2.1 个百分点。这个现象不是“字节一定好”,而是“字节在高预算与精确教师迁移下更可能拿到更高天花板”。
Marginalize-It 的思路是把教师词元分布按 ground-truth 字节前缀重新聚合。论文 Section 2.1 用一个例子说明其近似性:当预测第三字节时,若以 is 为前缀的候选中只保留 isu 和 isk,而丢弃更短词元 is 的延续可能,则需要把保留下来的概率重新归一化:
其中 0.5 和 0.125 是教师词元分布中 isu 和 isk 的概率,分母只包含前缀匹配且被保留下来的词元;该式的作用是把教师词元分布局部转成学生下一字节的近似目标。相比直接采样 ground-truth 字节,它仍然使用了教师的软分布;相比 exact token-to-byte conversion,它避免多次教师推理。边界也很明确:第一字节边缘化是 exact 的,因为所有词元的第一字节都能按 256 类聚合;后续字节一旦存在更短词元或其他可能延续,Marginalize-It 会把这些质量“悄悄丢掉”并重新归一化。论文在 Section 2.1 中称其为 approximate,且在整个研究中作为主要 baseline,而不是最终答案。
2. 精确转换:End-Of-Token 用一个边界符消除概率泄露
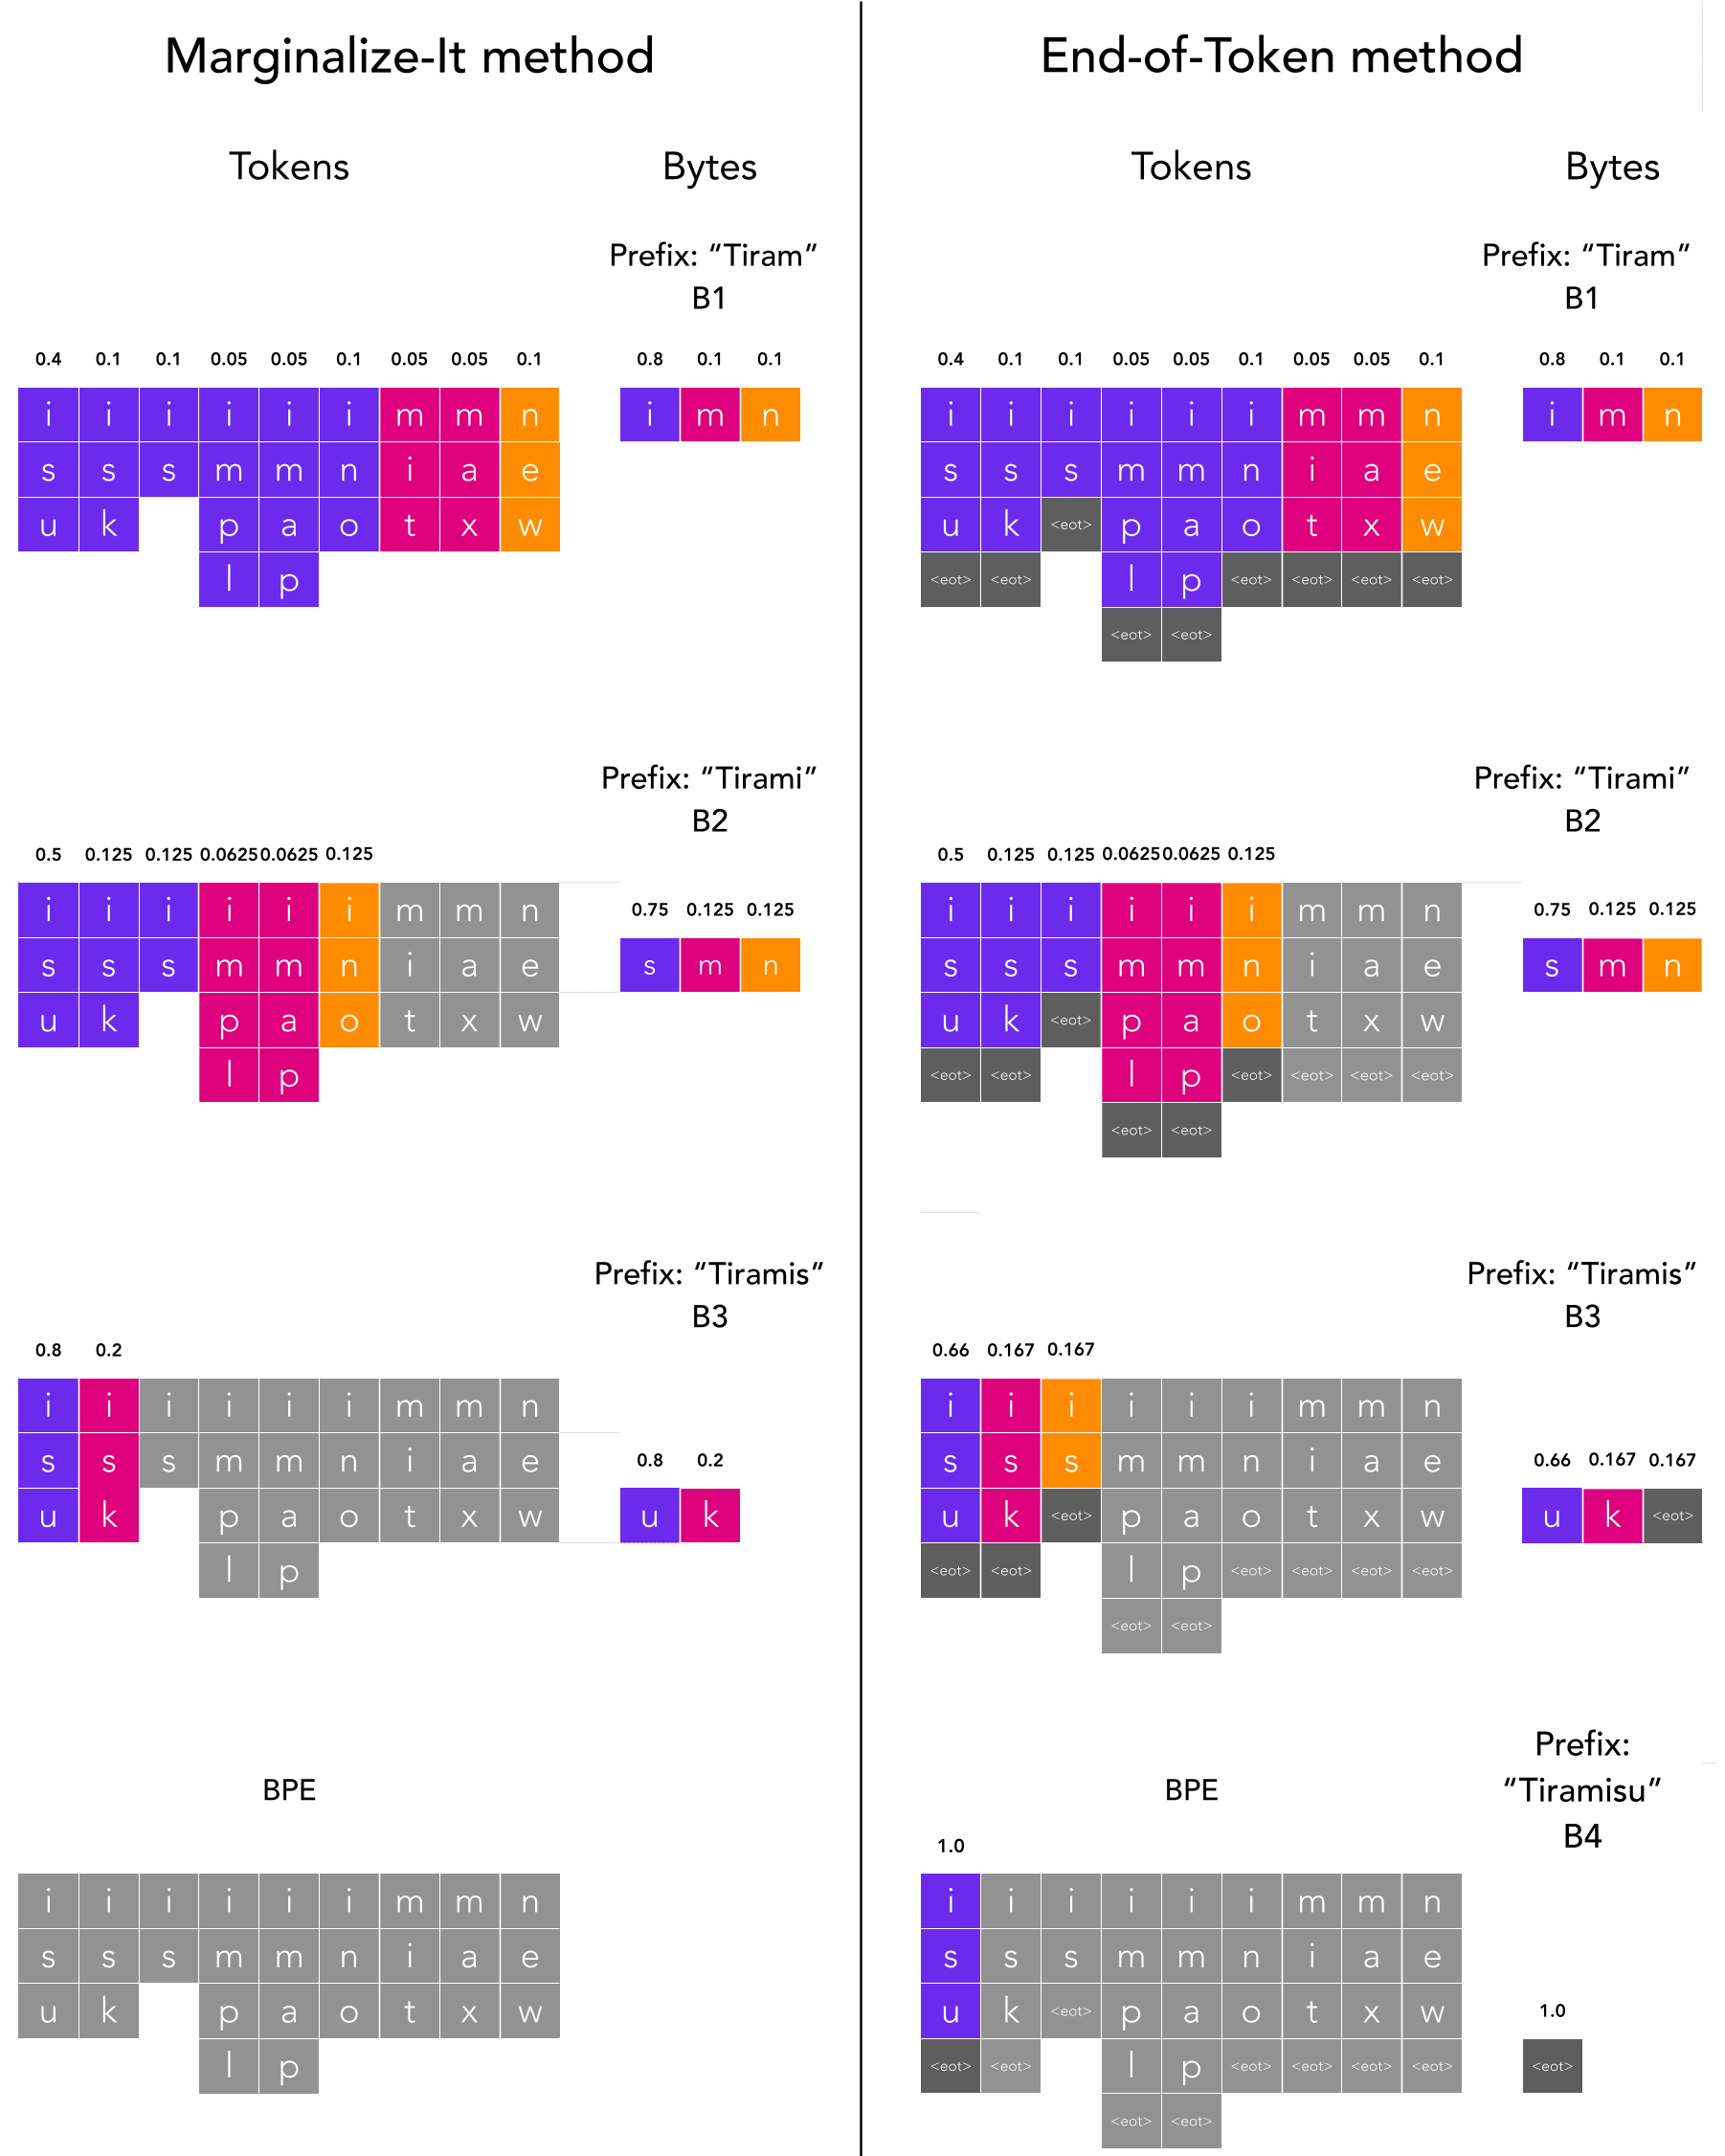
End-Of-Token 是 Marginalize-It 加上一个关键修正:在教师 logits 转换和训练序列中,把每个 BPE token 的结束显式表示成 eot 符号,并把词表从 260 扩展到 261。于是,原本会被丢掉或错误重分配的短词元概率,会进入一个“当前 token 到此结束”的分支。Figure 2 用同一个 Tiramisu 例子对比了两种方法:第一列中,预测 B3 时只考虑 isu 和 isk;第二列中,预测 B3 时所有以 is 开头的路径都保留,包括 isu、isk 以及 is 本身,后者被转换为 is eot。
论文在 Section 2.2 给出精确转换后的示例:
其中分母 0.75 是所有以 is 为前缀的词元总概率,包含 isu、isk 和 is 本身;三个分子分别对应继续写字节 u、k 或结束当前 token 的概率。该式的作用是恢复教师分布中原本缺失的概率质量,使字节 logits 成为 exact conversion。与 Marginalize-It 相比,它不需要额外教师前向,因为边界符本身就编码了“这个路径在这里停止”的信息。它的代价是序列变长:Table 1 显示 End-Of-Token 的词表为 261,Table 3 caption 说明 End-Of-Token-1B 相比 Bytes-1B 每单位数据多花约 30.94% FLOPs。论文把这个额外开销称为 unintended but remarkable consequence,因为多花在固定数据上的计算反而改善了渐近表现。
3. 缩放边界:从 BPB 到下游误差,才能判断谁有更高上限
论文的核心实验不是只看训练 loss,而是同时拟合两类规律。第一类是 Validation BPB vs Training FLOPs:
其中 是总训练 FLOPs, 是 held-out validation BPB, 是正系数, 是负指数, 是计算量增大时 BPB 的水平渐近线。相比简单比较 loss,这个式子把 tokenizer 导致的单位差异放进同一坐标:一个 BPE token 被词元模型视为 1 个 unit,被字节模型视为约 4.5 个 units,被 End-Of-Token 模型视为约 5.5 个 units。Table 3 报告了 lr=4e-3 的拟合结果:Token Distilled 的 为 0.9407,Marginalize-It Distilled 为 0.9016,End-Of-Token Distilled 为 0.8983;Table 3 caption 进一步指出 End-Of-Token-1B 相比 Bytes-1B 每 token 多花约 30.94% FLOPs,因为总 FLOPs per token 从 升至 。若只看低算力点,这条规律并不公平:字节和 eot 曲线通常起步更差。它真正描述的是 overtraining 下的渐近行为。
第二类是 downstream error vs validation BPB,用来把验证损失转成可比较的基准表现:
其中 是 validation BPB, 是平均 top-1 error, 控制曲线水平, 控制误差与 BPB 之间的偏移幅度, 控制误差随 BPB 下降而变化的速率。Table 4 报告了六组实验的拟合式,Table 5 则把每组曲线代入其 asymptotic BPB,得到渐近平均准确率:Token Distilled 为 48.4%,Marginalize-It Distilled 为 50.5%,End-Of-Token Distilled 为 52.4%。这个链条解释了两件事:其一,蒸馏本身通常会比同 tokenizer 的监督训练带来小幅上限提升;其二,Exact 的 End-Of-Token 不仅比近似 Marginalize-It 高 1.9 个百分点,而且因为每个 token 边界被保留,教师分布没有概率泄露。若把 eot 分支去掉,模型退化为 Marginalize-It 或普通 Bytes 方案,Table 5 的渐近准确率会下降;若把蒸馏损失换成纯交叉熵,论文在 Table 3 与 Section 10 也显示同 tokenizer 内蒸馏仍优于监督。
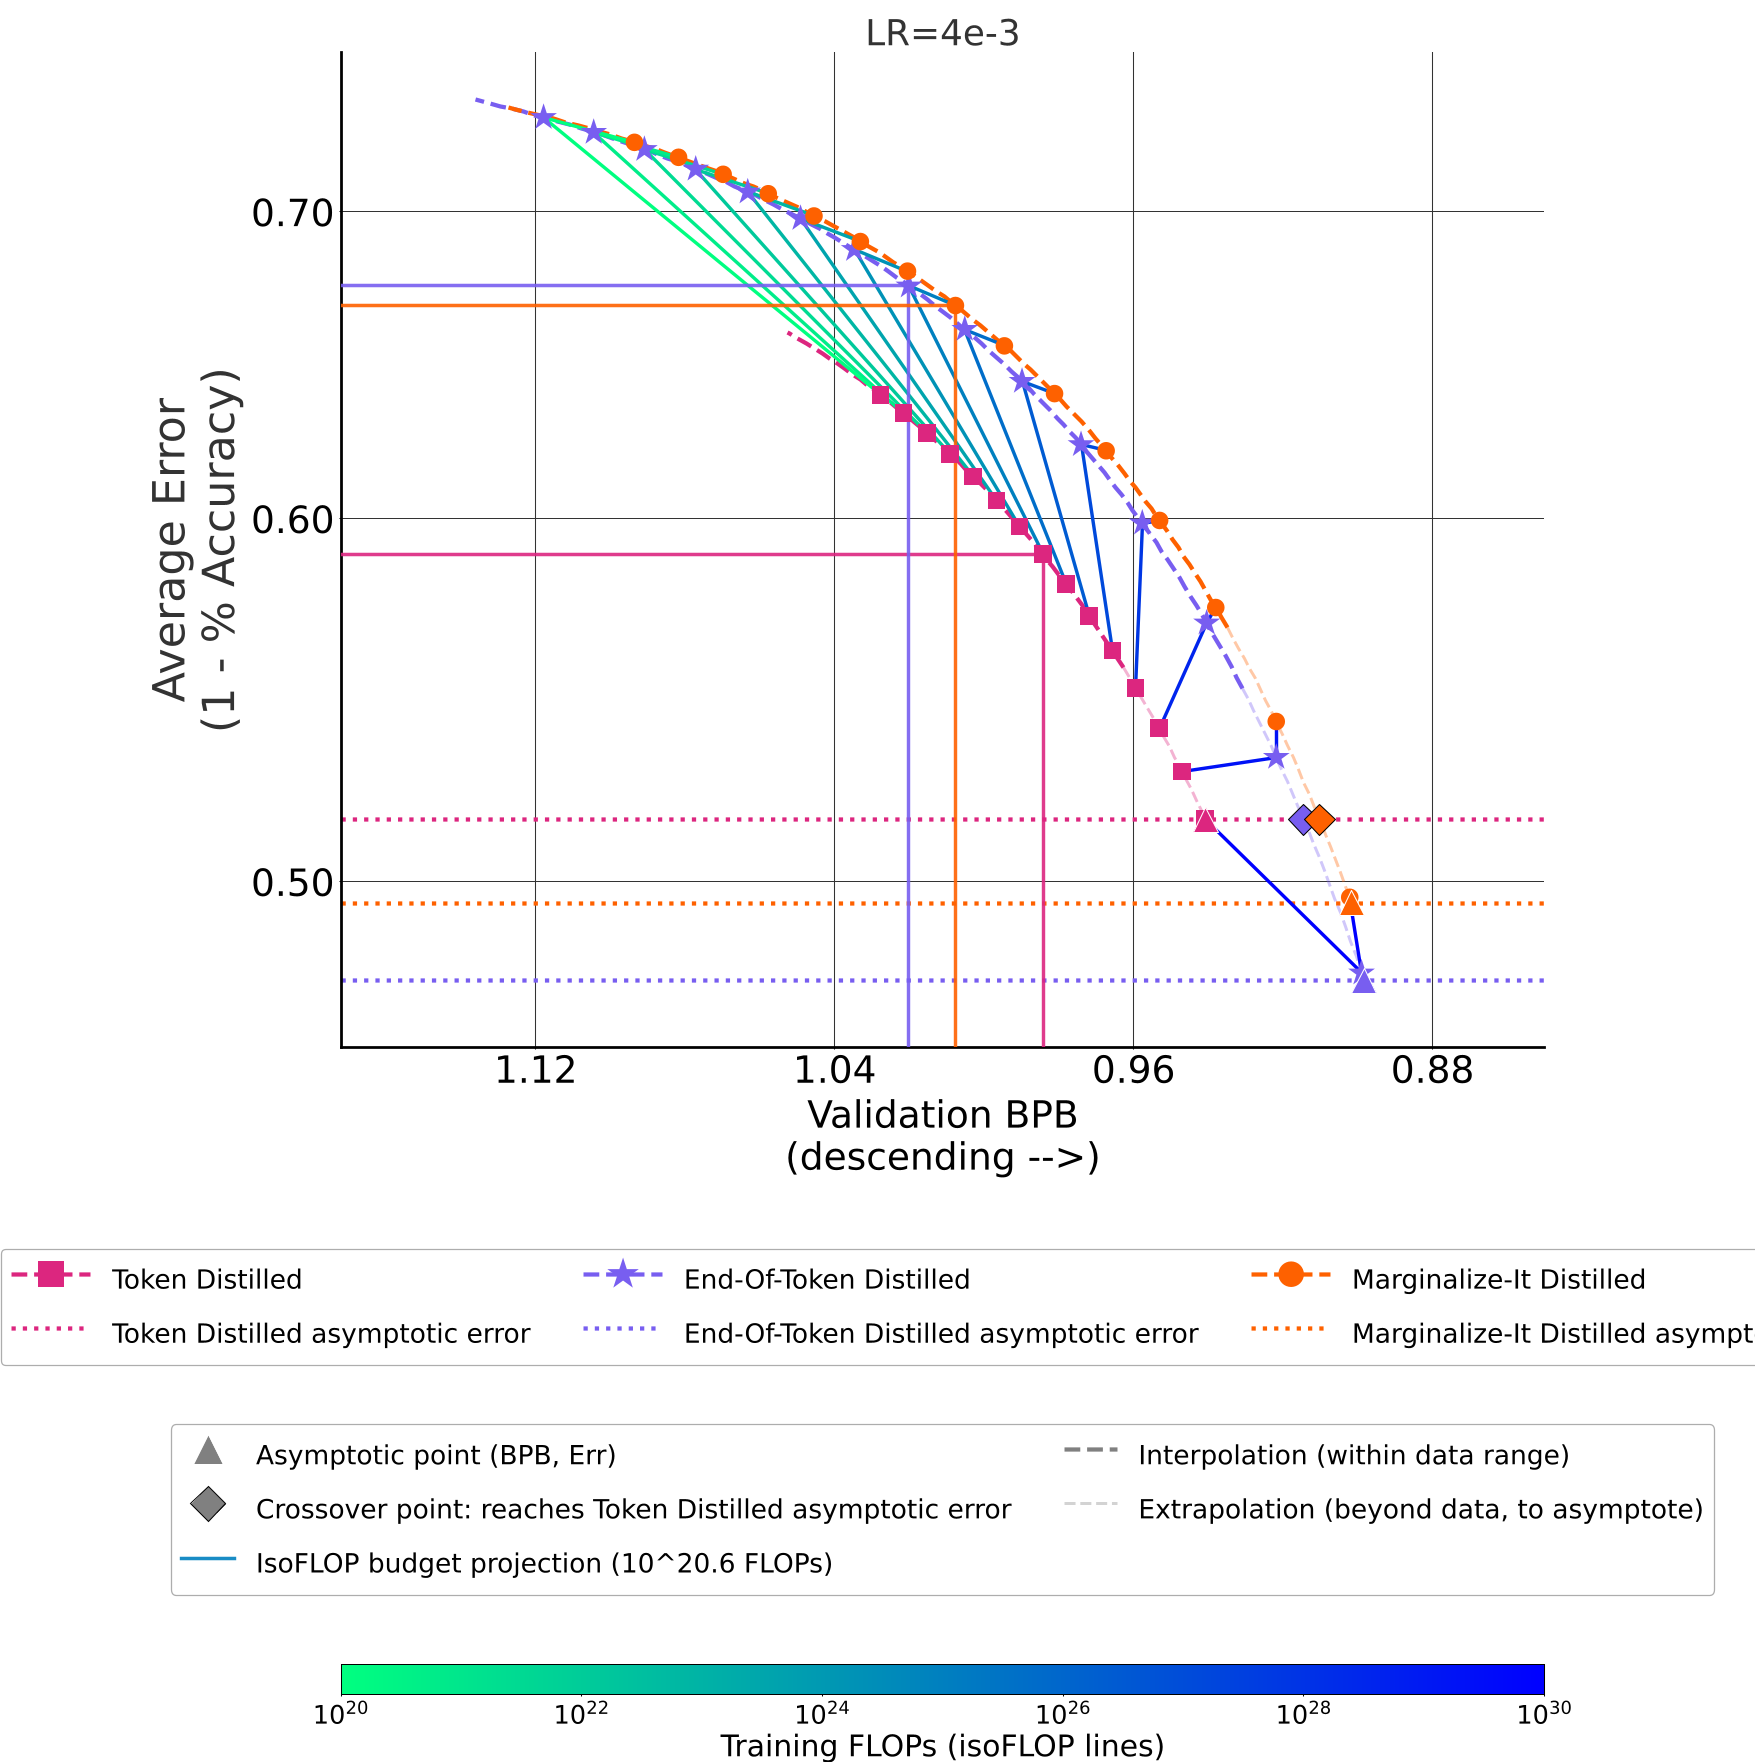
Figure 11 的 Feather Plot 把等 FLOPs 点同时投影到 BPB 轴和 downstream error 轴。它在论文中的作用不是展示新公式,而是回答“什么时候选哪个方法”。caption 给出的关键观察是:在 FLOPs 左右,Token Distillation 仍显著领先;继续提高计算预算后,End-Of-Token Distilled 才追上并超过 Marginalize-It 与 Token 方案。换言之,这不是“低算力部署时优先字节”的论文,而是“高算力过训练和渐近上限分析时字节有优势”的论文。
实验与证据
实验设计可以概括成六组二维对照:训练目标为 Supervised Cross-Entropy 或 Distillation,tokenization 为 Tokens、Bytes、Bytes w/ eot。Table 1 给出了完整设置:所有架构共享 1.28B total layer parameters,但 Token-1B 因词表为 128256 而总参数达到 1.81B,Bytes-1B 与 End-Of-Token-1B 总参数为 1.28B。单位 FLOPs 分别为 、 和 。这一设计让比较不再是“参数量不同导致的模型规模差”,而是聚焦于 tokenizer 和 objective 如何改变每单位数据的计算量。
| 实验 | 分词方案 | 词表大小 | 训练目标 | 架构 | 总参数量 | FLOPs per unit |
|---|---|---|---|---|---|---|
| Token Supervised | Tokens, Llama 3-8B | 128256 | Cross-Entropy | Token-1B | 1.81B | 8.18e9 |
| Token Distilled | Tokens, Llama 3-8B | 128256 | Distillation top-k | Token-1B | 1.81B | 8.18e9 |
| Bytes Supervised | Bytes, 256 special | 260 | Cross-Entropy | Bytes-1B | 1.28B | 8.81e9 |
| Marginalize-It Distilled | Bytes, 256 special | 260 | Distillation approximate | Bytes-1B | 1.28B | 8.81e9 |
| Bytes w/ eot Supervised | Bytes with eot | 261 | Cross-Entropy | End-Of-Token-1B | 1.28B | 9.44e9 |
| End-Of-Token Distilled | Bytes with eot | 261 | Distillation exact | End-Of-Token-1B | 1.28B | 9.44e9 |
Table 1 之后最重要的量化证据是渐近预测,而不是某一 checkpoint 的即时表现。Table 5 报告了 lr=4e-3 下每组实验的 asymptotic BPB 与预测平均准确率 :
| 方法 | 渐近 BPB c | 预测平均准确率 percent |
|---|---|---|
| Token Supervised | 0.9568 | 46.0 |
| Token Distilled | 0.9407 | 48.4 |
| Bytes Supervised | 0.8967 | 51.2 |
| Marginalize-It Distilled | 0.9016 | 50.5 |
| Bytes w/ eot Supervised | 0.8891 | 51.6 |
| End-Of-Token Distilled | 0.8983 | 52.4 |
这张表把论文的三层结论压缩到数字中。第一,End-Of-Token Distilled 的 52.4% 高于 Token Distilled 的 48.4%,差 4.0 个百分点;高于 Marginalize-It Distilled 的 50.5%,差 1.9 个百分点。第二,Exact 蒸馏并非单纯因为字节词表小,而是因为它保留了教师分布;同 tokenizer 下,Bytes w/ eot Supervised 为 51.6%,而 End-Of-Token Distilled 为 52.4%,说明蒸馏带来额外 0.8 个百分点。第三,Bytes Supervised 为 51.2%,Marginalize-It Distilled 为 50.5%,说明近似转换在渐近精度上并不总能稳定超过监督,这正是 End-Of-Token 的价值所在。
Section 7 把“何时划算”进一步转成数据与存储节省。Table 7 以 Token Distilled 的渐近 48.4% 准确率为目标,计算每种字节方法需要多少训练计算才能追平:
| 方法 | 训练 FLOPs | Byte Units | 有效 Bytes | 等效 Token 数 | 数据节省倍数 | 存储节省倍数 |
|---|---|---|---|---|---|---|
| Marginalize-It Distilled | 2.04e23 | 2.32e13 | 2.32e13 | 2.50e13 | 4.85 | 4.85 |
| End-Of-Token Distilled | 6.33e22 | 6.70e12 | 5.48e12 | 7.73e12 | 6.35 | 5.19 |
Table 7 显示,End-Of-Token 达到 Token 蒸馏上限时,只需 6.70e12 个 byte units,扣除 eot 后约 5.48e12 个有效 bytes;相对 token 等效 bytes 的 3.48e13,约节省 6.35 倍数据。这与摘要中的“one-sixth of the training data”一致。存储方面,因为字节模型不需要为每个 BPE token 存 top-k 词元 logits,而只需存约 260 维完整字节分布,Table 7 给出的 storage savings 为 5.19 倍,摘要表述为约五分之一成本。
与 open-weight models 的比较必须谨慎。Table 8 展示的是论文用 scaling law 外推出的 asymptotic 平均准确率,而不是已训练 checkpoint 的当前成绩:End-Of-Token Distilled 预测为 52.4%,Llama-3.2-1B 为 45.9%,Gemma-3-1B-pt 为 44.3%,Gemma 2B 为 50.3%,对应摘要中的 6.5、8.1 和 2.1 个百分点优势。但 Table 18 的当前 checkpoint 更保守:End-Of-Token Distilled 在最大可用数据 880B byte units 上的平均准确率为 44.6%,Token Distilled 为 44.4%,而 Llama-3.2-1B 已经训练到约 9T BPE tokens,平均准确率为 45.9%。因此,论文的贡献是预测趋势与机制,而不是已经用更小算力复现 open-weight 终局。
拆解性证据来自两条线。第一是 Figure 4、Figure 5 与 Figure 6:MCQ、语言生成和机器翻译都显示 Token-1B 在低 compute 领先,字节模型起步更差但曲线更陡。第二是 BPB 与下游误差解耦:Section 5.4 明确列出反例,在 220B token supervised budget 附近,字节模型 BPB 低于 Token Supervised,下游却更差。Appendix G 还给出一个极端构造:两个模型每步 target 概率都是 0.4,序列为 7 个 tokens、20 bytes,则两者 BPB 都是 ;但一个模型 target rank 1,贪心解码 7/7 正确,另一个存在 rank 0.5 的干扰项,贪心解码 0/7 正确。这个例子说明 BPB 只看 target probability,不看见余 mass 的排序,而下游准确率常依赖 arg max 排序。
证据质量方面,论文的优势是控制变量充分、拟合优度较高、敏感性分析不回避。Table 13 显示 BPB vs FLOPs 的 power-law 基本在 0.998 以上,主文 Table 3 的拟合 也接近 1。Section 7 的 Feather Plot 和 Appendix D 的 leave-one-out、residual weighting、validation dataset 选择分析则说明:结论方向相对稳健,但具体交叉点和渐近数值对拟合设置敏感。尤其是 Table 21 的 Validation Dataset 2 结果中,End-Of-Token Distilled 在 lr=4e-3 下渐近准确率为 50.5%,Token Distilled 为 48.7%,差值比主结果小。这说明“字节蒸馏上限更高”是 scaling-law 外推下的方向性结论,而不是任何验证集、任何 checkpoint 都立刻兑现的事实。
深度洞察与总结
这项工作最核心的贡献不是简单证明 byte model 更好,而是把“token-to-byte distillation”的两种设计选择与 overtraining scaling law 连起来。Marginalize-It 说明近似转换已经能胜过词元蒸馏 baseline,但它的渐近上限受概率泄露限制;End-Of-Token 用一个边界符把泄露变成显式分布质量,从而让 exact teacher transfer 与更高单位计算同时发生。论文在 Discussion 中总结为两点:其一,End-Of-Token 保留教师分布;其二,它因为 eot 使序列更长,在固定数据上多花约 30.94% 计算,而这份额外计算反过来抬高渐近表现。
局限性也必须具体说清。第一,这不是 inference-cost matched 的比较。Table 9 给出 sequence length 分别为 2048、9216 和 11264,论文在 Section 10 明确承认 End-Of-Token-1B 推理显著更贵,且与更大 Token-1B 在匹配推理成本下的比较超出本研究范围。第二,论文主体聚焦 dense transformer、约 1.28B layer parameters、最高约 1T bytes 的过训练;Mixture-of-Experts、更大模型、更多数据只是 future work。第三,open-weight 比较基于 asymptotic prediction,而非同等训练预算下的实际终局;Table 18 的当前 checkpoint 尚未稳定超过 Llama-3.2-1B。第四,scaling law 外推受验证集选择和拟合权重影响,Appendix D 与 Table 21 已显示不同 validation dataset 会改变交叉点。
未来更值得推进的方向不是泛泛说“扩展到更多领域”,而是三个可证伪问题:一是把 eot 边界机制与推理效率结合,研究是否能在不牺牲 exact distribution 的情况下减少每 token 约 5.5 units 的序列长度开销;二是在 cross-tokenizer distillation 中使用 End-Of-Token 作为统一概率接口,探索能否让不同 tokenizer 的学生共享同一 teacher logits dump;三是把 BPB 到 downstream error 的校准做成分 tokenizer、分 objective 的元模型,而不是把所有模型压进一条 global scaling law。论文给出的答案其实已经很清楚:字节蒸馏的天花板来自精确教师分布和更高单位数据计算,但真正落地的门槛在于推理成本与校准可信度。