
DYPO:打破 SFT 与 RL 的二元对立,实现稳健的推理策略优化
Bridging SFT and RL: Dynamic Policy Optimization for Robust Reasoning
本文提出了 DYPO (Dynamic Policy Optimization),一种统一的大语言模型强化学习与监督微调的后训练框架。通过动态难度分级、多教师蒸馏以及群体对齐损失(GAL),DYPO 在复杂数学推理基准(如 AIME, GPQA-Diamond)上显著超越了传统的 SFT-then-RL 串行流水线,实现了推理稳定性与探索能力的深度融合。
TL;DR
在 LLM 后训练(Post-training)领域,SFT(监督微调)和 RL(强化学习)一直被视为“稳定但保守”与“高能但难训”的两个极端。由清华大学与中兴通讯联合提出的 DYPO (Dynamic Policy Optimization) 框架,通过一套精密的梯度层面的调度机制,首次在统一框架内结构性地解决了 SFT 的拟合偏差与 RL 的高方差冲突。在多项数学竞赛级基准测试(AIME, MATH)中,DYPO 展现出了远超 SFT-then-RL 串行方案的泛化性。
痛点深挖:偏差与方差的博弈
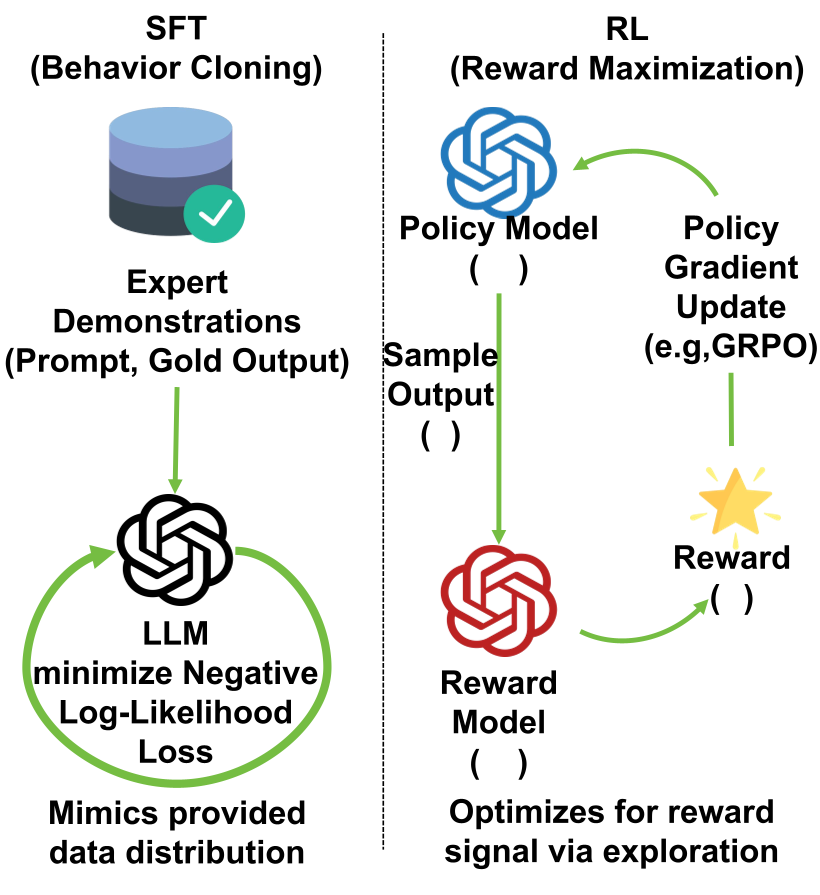
为什么简单的“先 SFT 再 RL”或者“静态混合 Loss”效果受限?作者通过理论分析指出,SFT 和 RL 的梯度信号在统计学上存在本质冲突:
- SFT 的原罪 (High Bias, Low Variance):模型被禁锢在静态数据集中。如果教师数据有偏差,模型就会学会“错误的模仿”,难以处理训练集之外的问题。
- RL 的陷阱 (Low Bias, High Variance):虽然 RL 鼓励探索,但依靠 Monte Carlo 采样的梯度极不稳定。对于基座能力尚弱的模型,面对复杂推理任务时,正确的奖励信号如同大海捞针,训练极易崩溃。
核心思路:动态分流与精准治理 (The DYPO Framework)
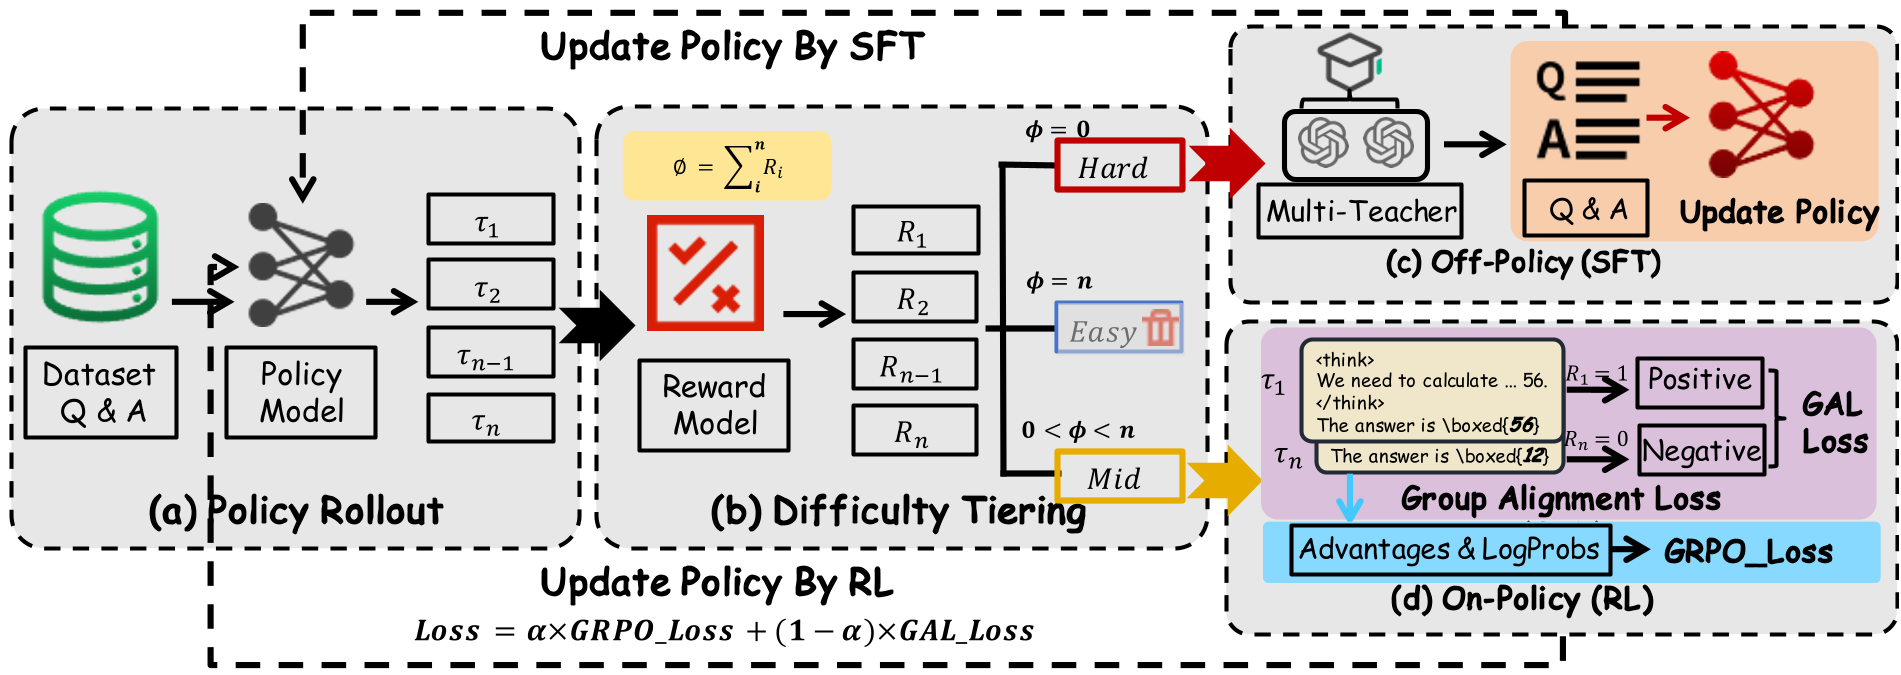
DYPO 的精妙之处在于它不强制对所有样本“一视同仁”,而是根据模型当前的生成反馈,将任务进行动态难度梯度分级:
1. 动态难度路由 (Dynamic Difficulty Grading)
对于每一个 Prompt,模型先生成一组 () 候选答案。
- Easy(全对):说明模型已掌握,直接跳过以节省算力。
- Hard(全错):RL 无法提供有效反馈,此时采用 多教师蒸馏 (Multi-Teacher Distillation)。
- Mid(有对有错):这是学习的“金区”,触发 方差抑制型 RL (Variance-Reduced RL)。
2. 偏差修正:多教师策略
为了不让模型“学偏”,DYPO 集成了 DeepSeek-R1 和 Qwen3 等多个模型作为教师。理论推导显示,通过集成多个不相关偏差的教师模型,固有偏差(Idiosyncratic Bias)会随教师数量 的增加而线性下降,引导学生进入“正确路径的交集”。
3. 方差抑制:群体对齐损失 (GAL)
这是本文的核心技术创新。在 RL 阶段,DYPO 不仅仅使用标准的 GRPO,还引入了 Group Alignment Loss (GAL)。
- 直觉:GAL 的作用类似于对齐(Alignment),它在同一次采样中,显式地“拉近”模型与正确路径的距离,同时“推开”错误的推理路径。
- 效果:与 GRPO 中无界的优势函数(Advantage)不同,GAL 的梯度权重是有界的(Sigmoid 映射),这极大地平滑了训练早期的梯度抖动。
实验战绩:推理能力的质变
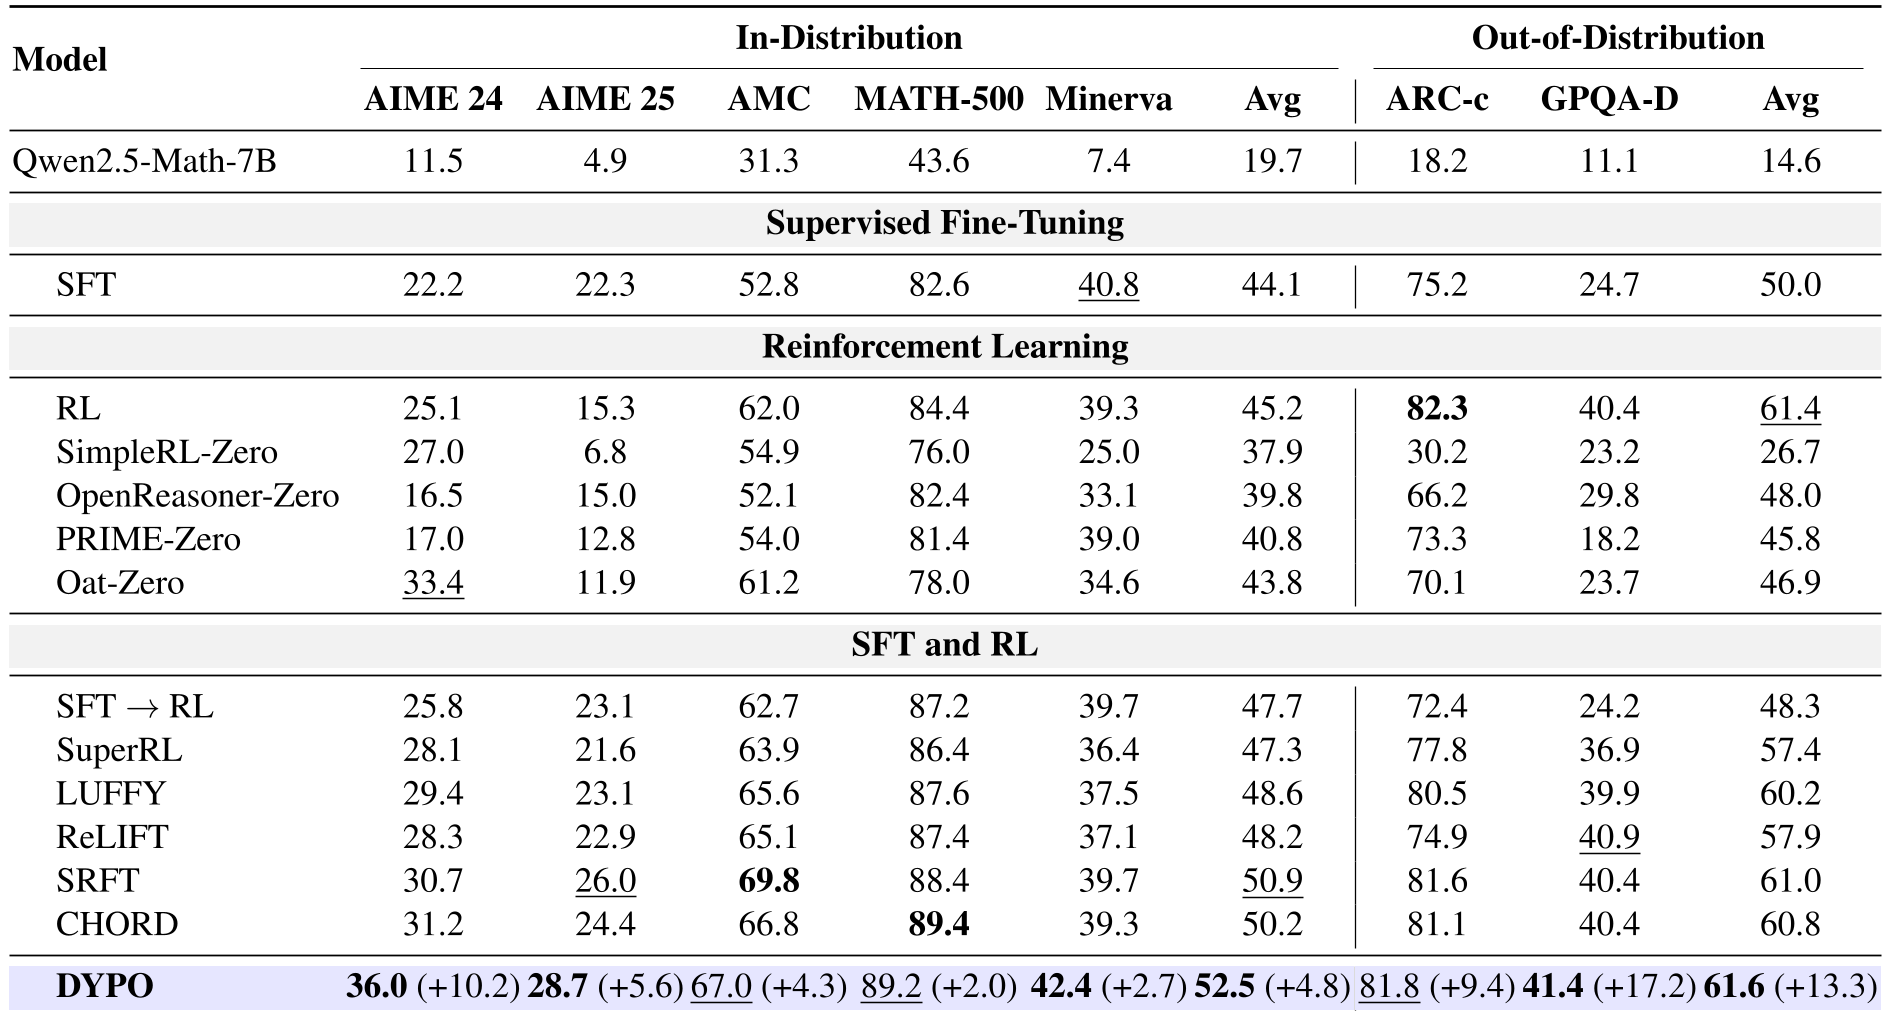
在 Qwen2.5-Math-7B 上的测试结果令人印象深刻:
- SOTA 表现:在 AIME 24/25 测试集上,DYPO 相比于复杂的 Post-SFT 优化方案(如 SRFT, CHORD)保持了 4-5% 的领先。
- 极强的 OOD 泛化项:在博士级别的科学问答数据集 GPQA-Diamond 上,DYPO 相比 SFT 提升了 16.7%。这意味着模型不仅是记住了模板,而是真正内化了逻辑推理性。
深度洞察:为什么 DYPO 更稳定?
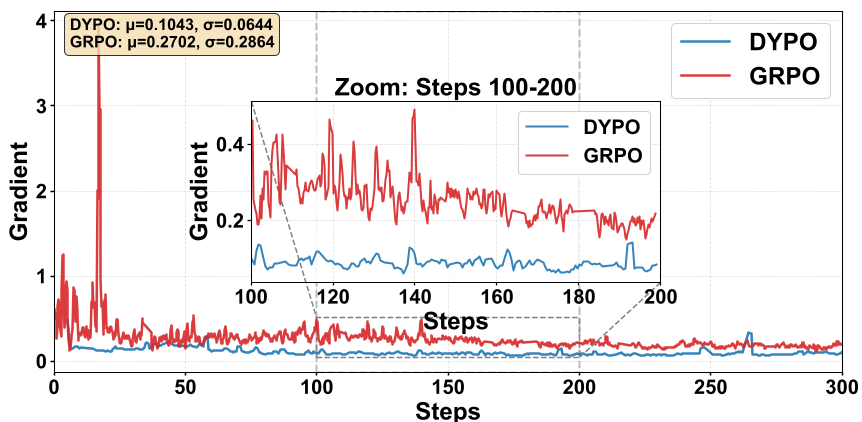
通过梯度范数(Gradient Norm)的时间序列分析(见下图),可以清晰地看到:
- 传统的 GRPO(红线)梯度波动剧烈,意味着模型在优化地形中“上窜下跳”。
- DYPO(蓝线)通过 GAL 的约束,使得梯度平滑下降。这种稳定性允许模型使用更大的学习率而不会导致模式坍塌(Mode Collapse),保持了更高的策略熵(Entropy),这也是其泛化性能更好的原因。
总结与启示
DYPO 告诉我们,后训练不是简单的“数据喂养”,而是不同统计路径的动态调度。
- 它成功将单纯的“概率拟合”提升到了“策略对齐”的高度。
- 局限性:尽管其样本效率高于全量采样 RL,但每次训练前需要生成 8 条路径,计算成本依然高于纯离线方法。
- 未来方向:这种动态分流的思想非常适合应用于多模态推理场景,在那些奖励信号更稀疏、反馈更复杂的领域,DYPO 这种“稳扎稳打”的进化路径将更具吸引力。
主编点评:在 o1 开启的强化学习基准竞赛中,DYPO 提供了一个极具参考价值的开源框架,它对 Bias-Variance Trade-off 的理论回归,是当前 LLM 训练从“玄学调优”走向“科学干预”的一个标志性工作。