
C2P-CLIP:解码 CLIP 的检测直觉,注入类别通识突破 Deepfake 泛化瓶颈
C2P-CLIP: Injecting Category Common Prompt in CLIP to Enhance Generalization in Deepfake Detection
本文提出了 C2P-CLIP,一种通过在 CLIP 模型中注入“类别通用提示词”(Category Common Prompt)来增强 AIGC 伪造检测泛化能力的通用方法。该方法在不增加推理参数的情况下,将 CLIP 在 Deepfake 检测中的准确率大幅提升了 12.4%。
TL;DR
本文深入探究了 CLIP 为什么能识别 AI 生成的图片。作者发现 CLIP 实际上是在寻找“相似概念”。基于这一发现,作者提出了 C2P-CLIP:通过向文本编码器输入带有“真实(Camera)”或“伪造(Deepfake)”标签的增强提示词,并利用对比学习将这些概念注入到图像编码器中,显著提升了模型对未知生成来源图片的识别准确率。
背景定位:Deepfake 检测的新高度
在 AIGC 技术爆发的今天,从 GAN 到 Diffusion Models,造假手段层出不穷。传统的检测器往往在训练集上表现优异,但遇到从未见过的生成器时就会“失灵”。本文在学术坐标系中属于机制解释+性能优化的双重贡献:它不仅解释了为什么 CLIP 是个好的 Baseline,还通过极简的 LoRA 微调刷新了 SOTA(State-of-the-art)。
1. 痛点深挖:CLIP 到底在看什么?
此前的研究(如 UniFD)发现,直接把 CLIP 的图像特征丢给一个线性分类器(Linear Classifier),就能得到不错的检测结果。但学术界一直没搞清楚:CLIP 是看到了像素级的伪造痕迹,还是理解了“真”与“假”的概念?
作者做了一个有趣的实验:利用 ClipCap 将线性分类器处理后的“检测特征”重新解码成文字。
- 现象:解码出的文字与原图内容(如“一只猫”)无关,而是变成了一些奇怪的语义组合。
- 直觉 (Insight):CLIP 并不是在判别真假,而是在特定特征空间里匹配某些与“伪造”相关的语义。
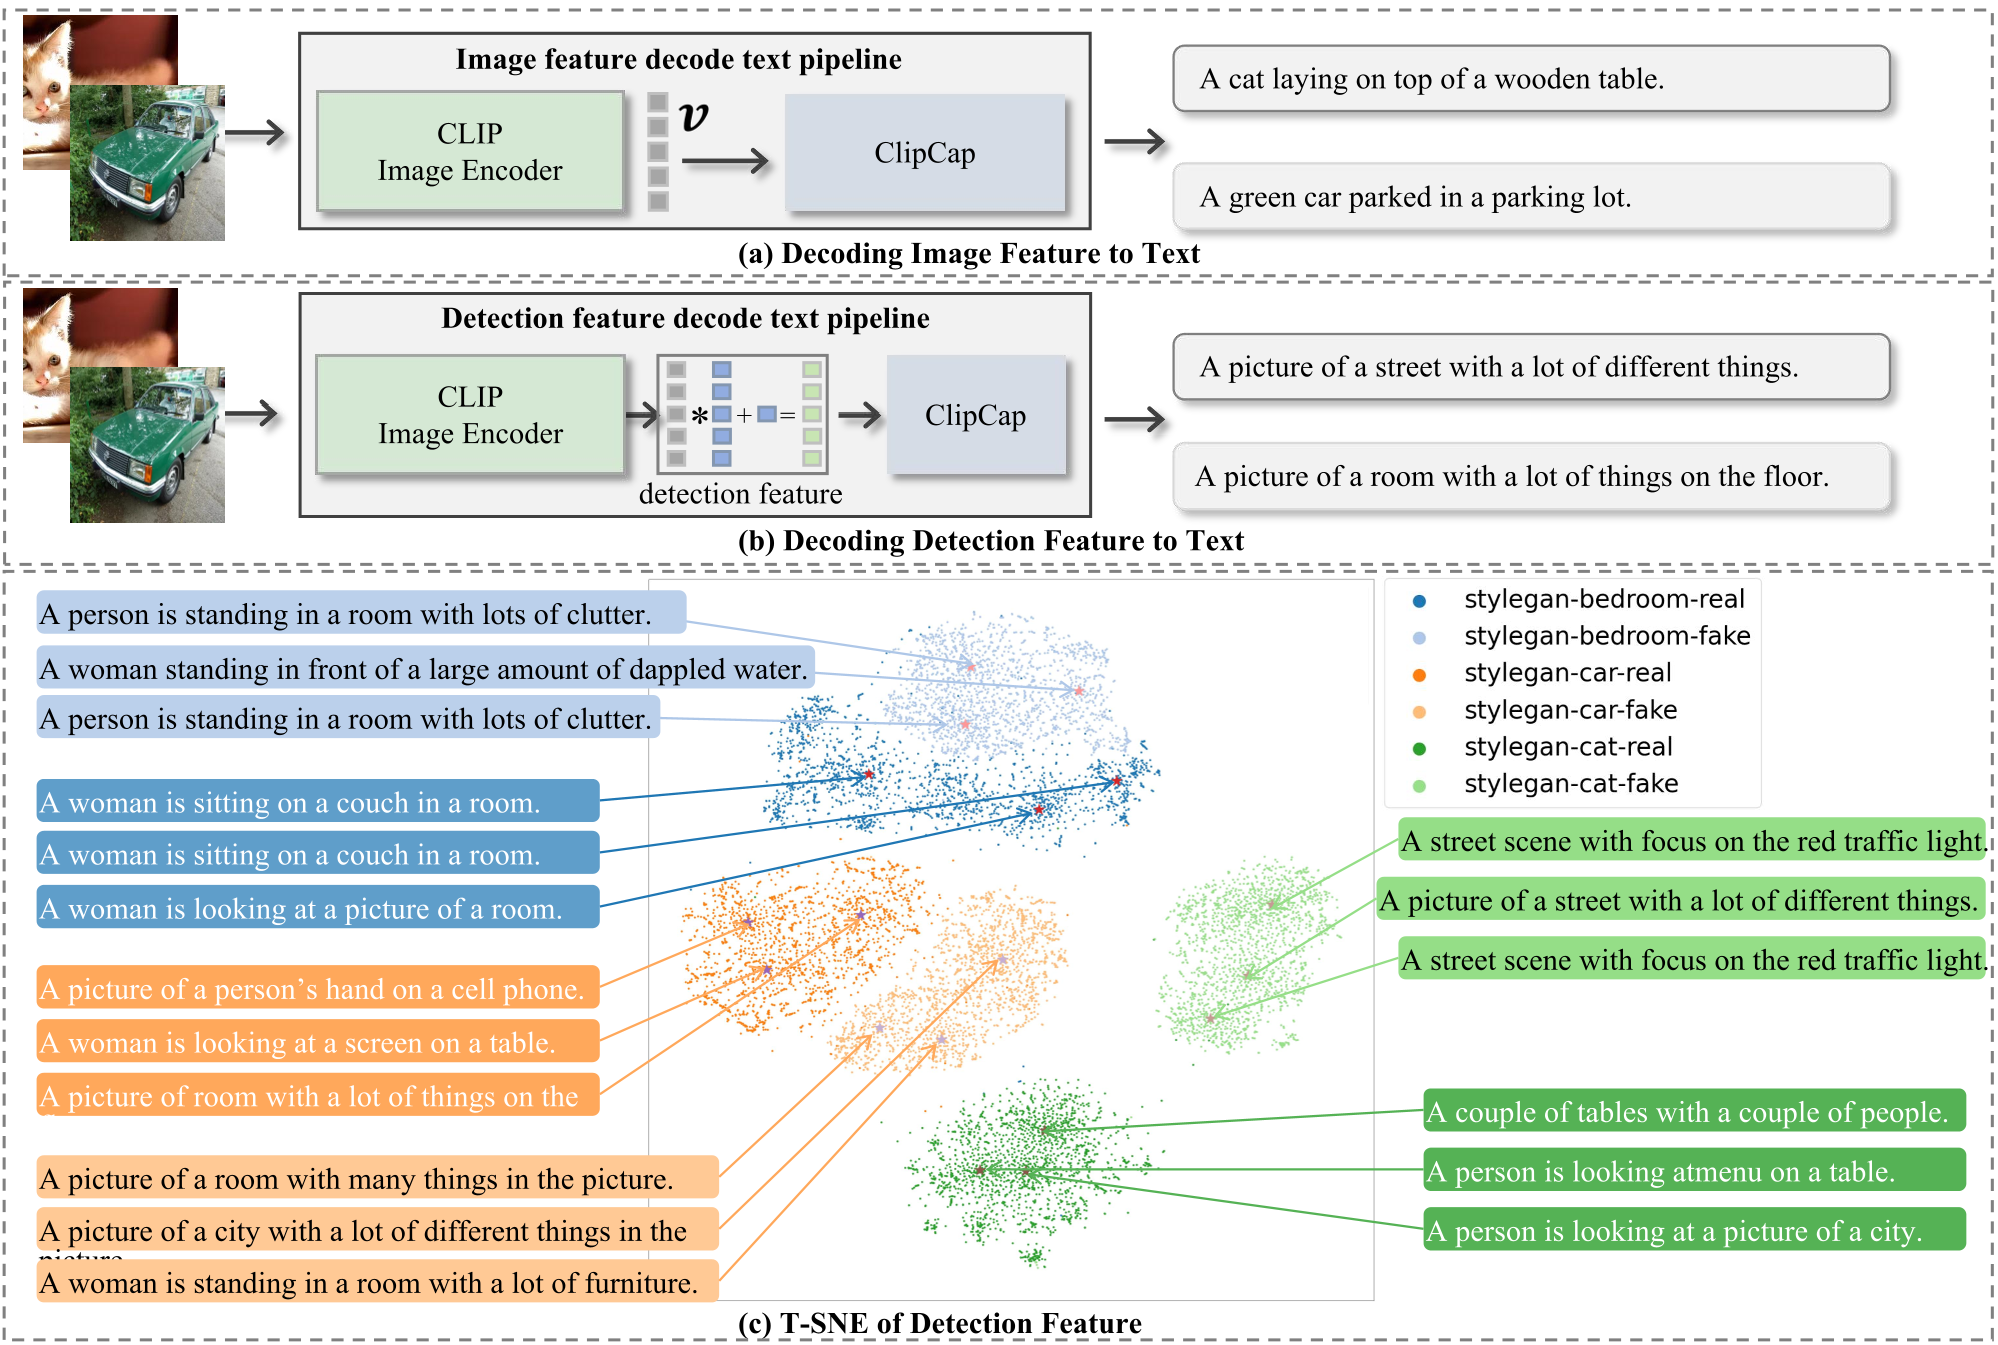 图 1:通过解码发现,检测特征中并不直接包含“真”或“假”的单词,而是通过词频差异体现出对不同生成源的敏感度。
2. 核心方法:C2P-CLIP (Category Common Prompt CLIP)
既然 CLIP 靠“概念匹配”来工作,那么如果我们主动把“真/假”的语义概念关联到图像特征中,其性能是否会爆发?
架构解析
C2P-CLIP 的流程分为三个阶段:
- 提示词增强 (Caption Enhancement):对每一张训练图,先用 ClipCap 生成原始描述,然后强行在后面挂载一个“类别通用提示词”。例如:
- 真图:
[Original Caption] + "Camera" - 假图:
[Original Caption] + "Deepfake"
- 真图:
- 概念注入 (Concept Injection):
- 冻结原有的 CLIP 参数。
- 在图像编码器中插入 LoRA 模块。
- 使用对比损失 (Contrastive Loss) 和 分类损失 (Classification Loss) 进行训练,强迫图像特征去向带有特定提示词的文本特征对齐。
- 纯净推理:由于 LoRA 的特性,测试阶段不需要文本编码器参与,也不增加额外的推理延时。
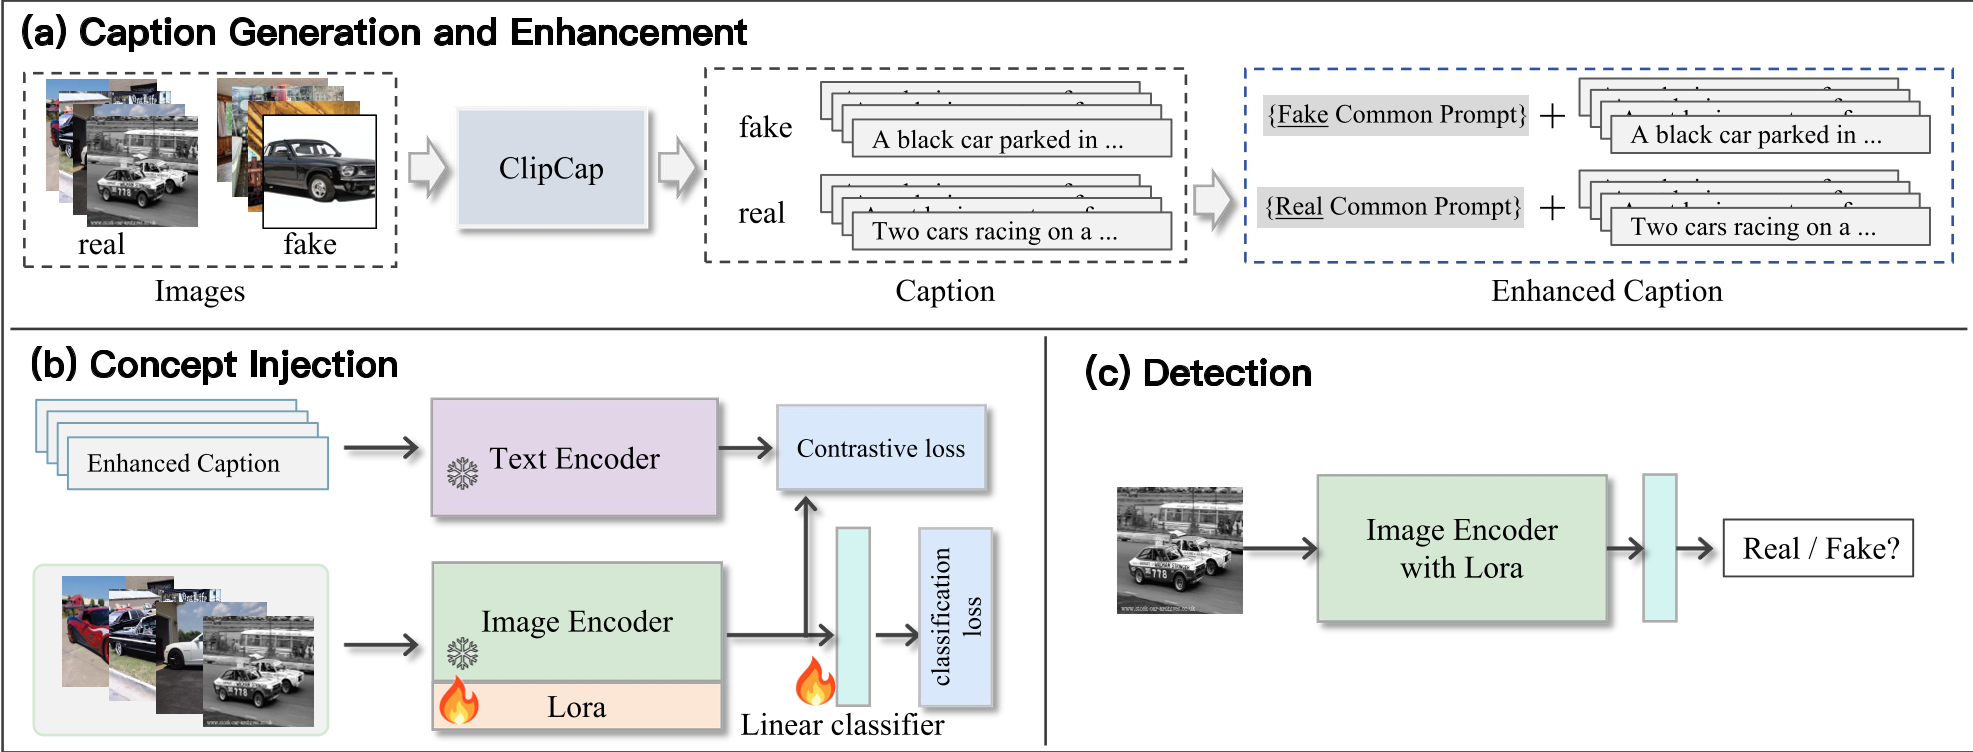 图 2:C2P-CLIP 训练与测试流程。
3. 实验与结果:全线碾压 SOTA
作者在 UniversalFakeDetect(主要包含 GAN)和 GenImage(主要包含 Diffusion)两大权威基准上进行了严苛测试。
- 泛化能力惊人:在只有 ProGAN 数据参与训练的情况下,模型在 StyleGAN、LDM、Dalle 等 19 个未见过的测试集上表现稳健。
- 量化提升:对比 UniFD,在 UniversalFakeDetect 上的平均准确率(mAcc)从 81.4% 提升到了 93.8%(使用 Ours-P2 提示词方案)。
- 无需复杂设计:相比于 FatFormer 等需要额外频率分析模块的方法,C2P-CLIP 结构更简单,且在 GenImage 数据集上高出对方约 7 个百分点。
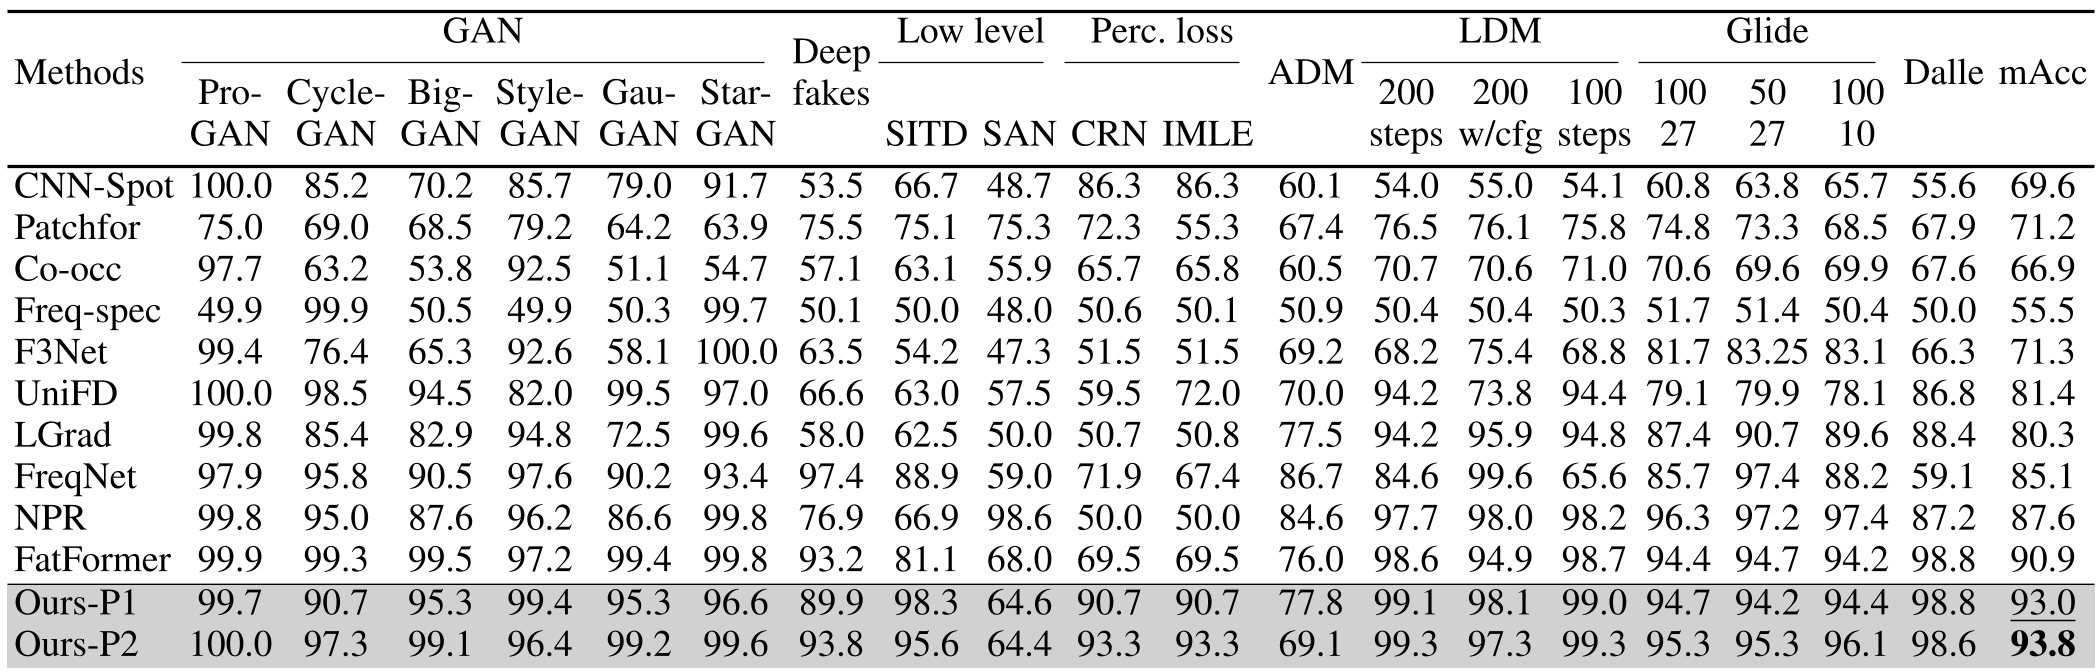 表 1:在 UniversalFakeDetect 上的详细对比,可以看到 C2P-CLIP 在各类模型上均有极高的 mAcc。
4. 深度洞察:为什么有效?
通过可视化分析(Logit Distribution),我们可以清晰地看到 C2P-CLIP 的魔力:
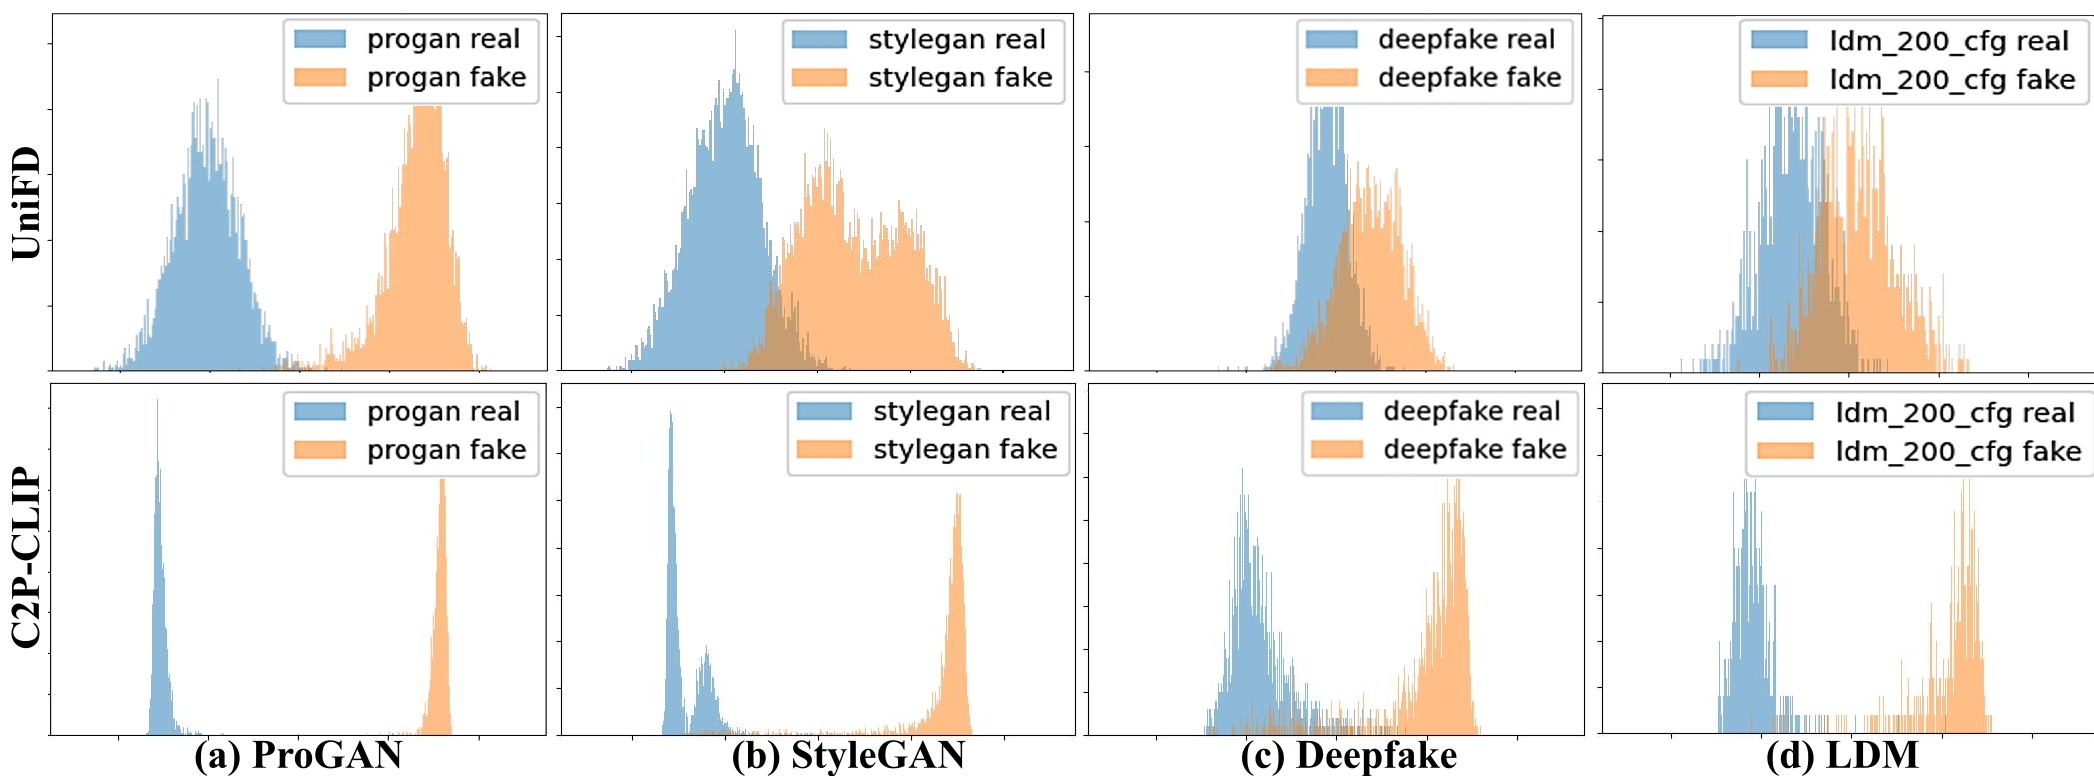 图 3:左图(UniFD)在未见模型上的真假图预测结果高度重叠;右图(C2P-CLIP)则能保持鲜明的类间边界。
总结 (Takeaway): C2P-CLIP 的成功证明了,对于判别任务,我们不一定非要死磕复杂的骨干网络设计。利用预训练多模态模型强大的语义空间,通过简单的提示词工程 (Prompt Engineering) 和 参数高效微调 (PEFT),就能将高级语义(真/假概念)跨模型地传递给图像编码器,从而实现以“不变应万变”的泛化效果。
局限性: 虽然词频分析提供了一个视角,但目前对文本描述如何完整地映射到伪造特征的逻辑解释还不够完美,这将是未来研究的一个方向。