
CAMixerSR:好钢用在刃上,只有细节才需要“注意力”
CAMixerSR: Only Details Need More “Attention”
本文提出了 CAMixerSR,一种集成内容感知路由与算子设计的图像超分辨率(SR)网络。核心方法 CAMixer 通过动态分配机制,对平滑区域执行轻量级卷积,仅对纹理复杂的区域应用可变形窗口自注意力(Deformable Window-Attention),在 2K-8K 高清超分任务中达到了 SOTA 的性能与效率平衡。
TL;DR
在超分辨率(SR)领域,处理 2K 到 8K 的高清图像一直是效率的“盲区”。字节跳动与南开大学的研究团队提出了 CAMixerSR,其核心哲学极为直接:并非所有像素都值得昂贵的 Self-attention。通过内容感知混合器(CAMixer),模型能自动识别画面中的“简单”平滑区(用卷积解决)和“硬核”纹理区(用注意力解决),在保持 SOTA 性能的同时,大幅压缩了计算开销。
痛点深挖:昂贵的“一视同仁”
目前的超分方案研究主要存在两条平行的“轨道”:
- 加速框架(如 ClassSR):将图片切成小块,简单的快丢给小模型,难的丢给大模型。缺陷在于切块太生硬,感受野受限。
- 轻量化设计(如 SwinIR):设计精巧的算子。缺陷在于对整张图的每一个 Token 都一视同仁地使用相同的计算逻辑,对于大量白云、蓝天等缺乏细节的区域,自注意力机制(Self-attention)完全是浪费。
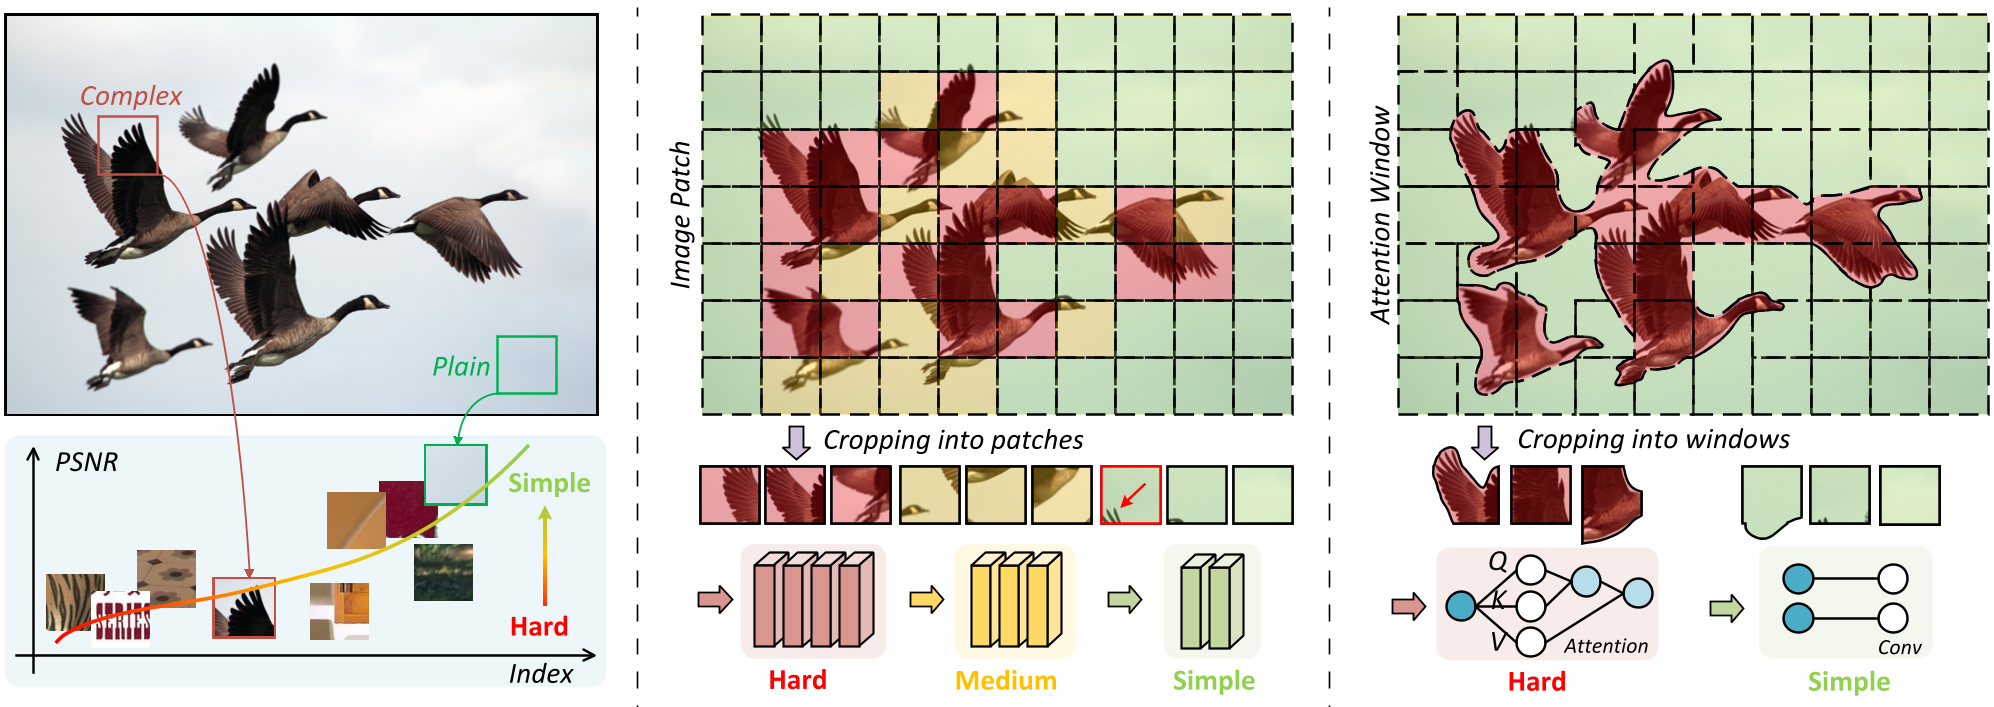 图 1:左侧展示了不同难度的图像区域;中间为传统分块路由,右侧为 CAMixer 在统一网络内按需分配算子。
方法论详解:内容感知混合器 (CAMixer)
CAMixerSR 的灵魂在于其 CAMixer 模块,它将“卷积”与“自注意力”有机结合。
1. 强大的预测器 (The Predictor)
不同于简单的分类器,CAMixer 的预测器结合了局部信息、全局信息和位置编码。它不仅仅输出一个“开关”信号,还会生成:
- Mask (m):决定哪些窗口进注意力分支,哪些进卷积分支。
- Offsets (Δp):用于对采样窗进行变形(Warping),让自注意力能捕捉到不在标准窗口内的关键纹理。
- Spatial/Channel Attentions:即使是在卷积分支里,也要给卷积加点“营养”,增强其表达能力。
2. 算子分流机制
模型根据预测的掩码分数对窗口进行排序。前 个复杂的窗口执行 Deformable Window-Attention,其余窗口则通过简单的卷积处理。这种动态性通过 Gumbel-Softmax 在训练时驱动,确保了优化方向与推理时的策略一致。
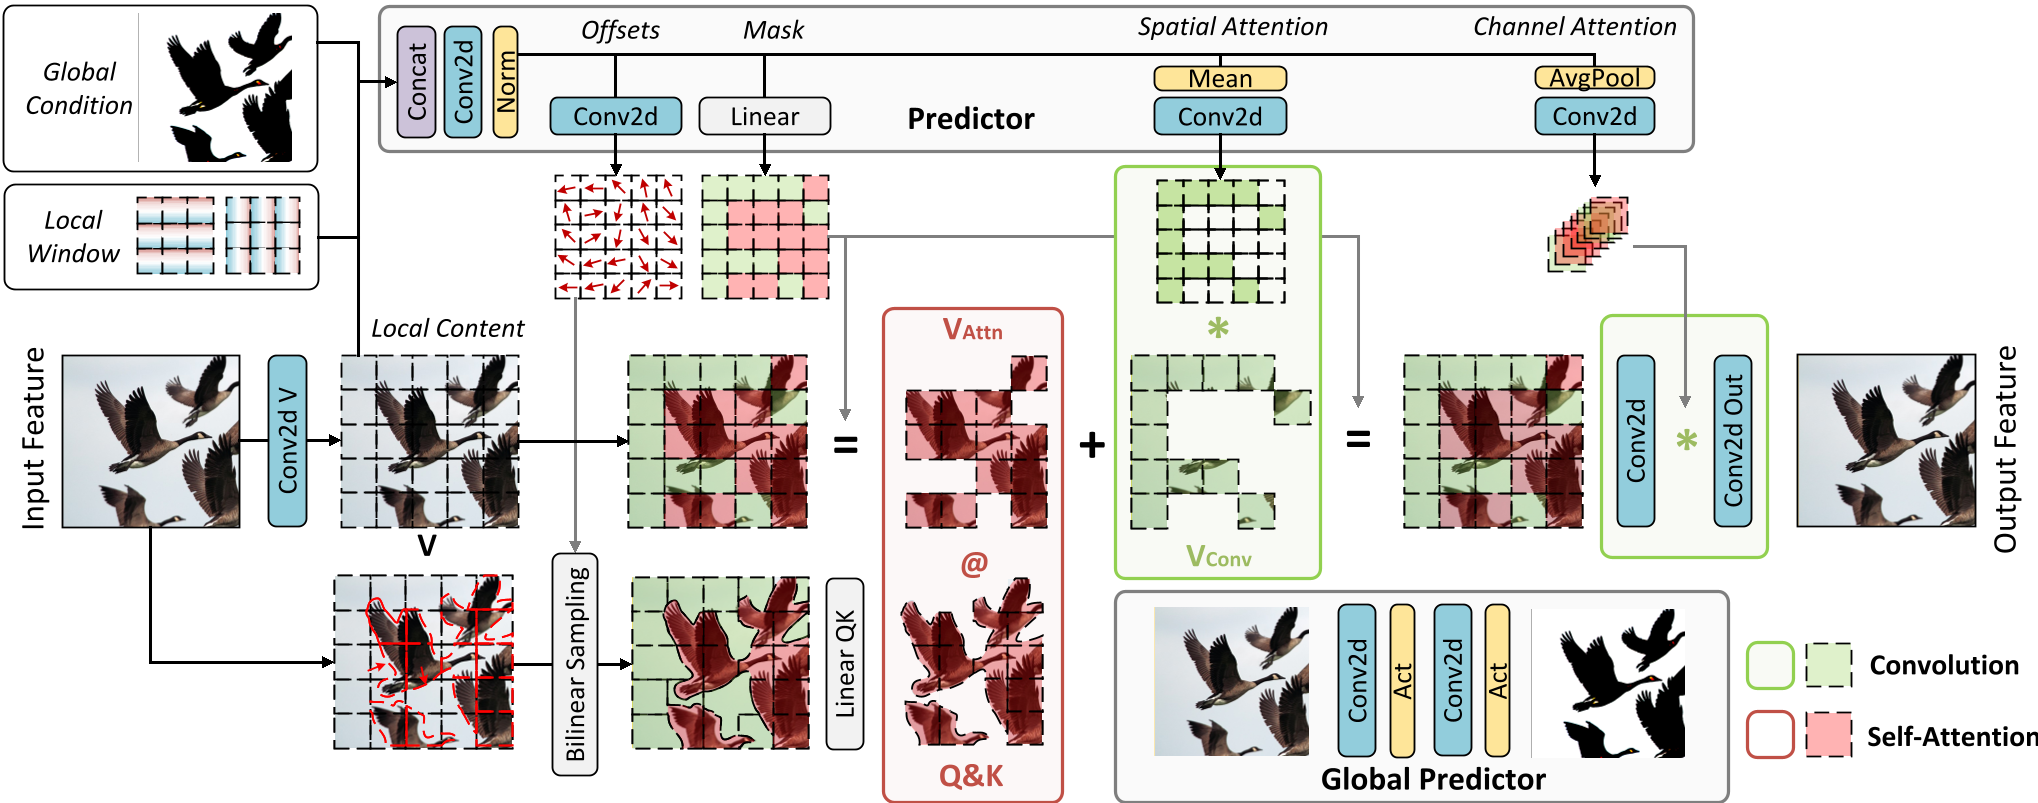 图 2:CAMixer 整体架构,包含预测器分支、自注意力分支和卷积分支。
实验与结果:算力与图像质量的平衡艺术
在 2K-8K 的大图超分测试中(如 Test8K 数据集),CAMixerSR 的表现令人惊艳:
- 碾压级对比:仅用 765K 的参数量,其 PSNR 表现就能硬刚拥有 15.6M 参数的 RCAN 模型。
- 效率对比:在相同配置下,CAMixerSR 将自注意力的计算比例 γ 设为 0.5 时,计算量比 γ=1.0(全注意力)降低了约 25%,而 PSNR 下降微乎其微(不到 0.02dB)。
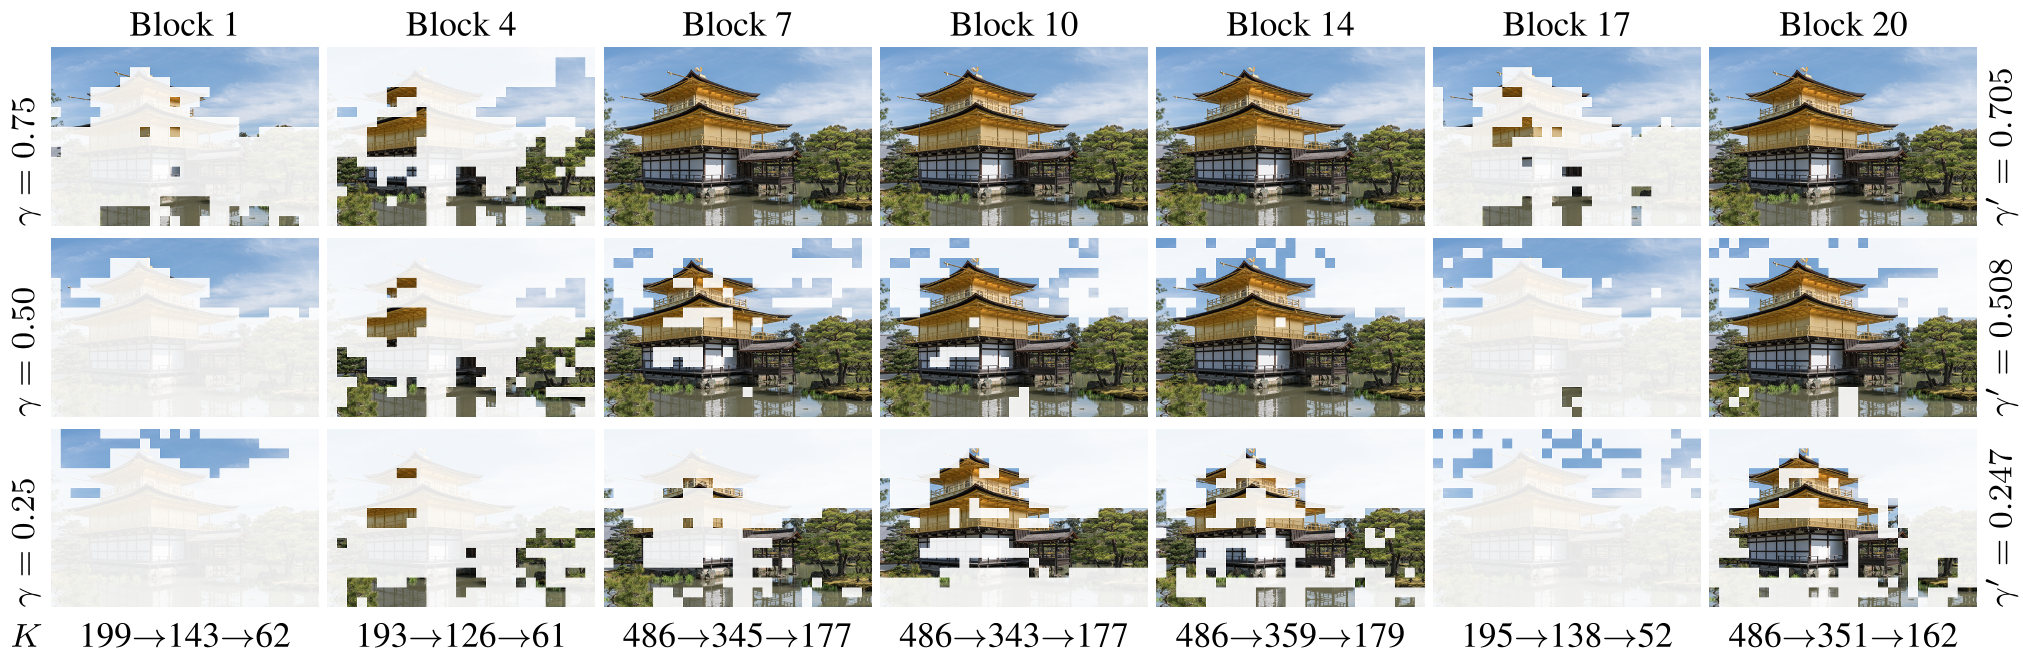 图 3:不同 Block 学习到的注意力分布。可以看到,建筑、物体边缘(复杂区)被自动分配了更多的注意力,而天空(简单区)则被掩码遮盖(由卷积处理)。
深度洞察与总结
CAMixerSR 成功地将“算法加速框架”的思想内化到了“算子设计”中。
- Takeaway:未来的视觉模型不应追求“全能力的统一算子”,而应探索“异构算子的动态协调”。
- 局限性:虽然计算量(FLOPs)显著下降,但动态路由带来的索引操作(Argsort 等)在某些非优化硬件上可能会带来额外的延迟(Latency)。
- 展望:该方案在移动端实时 4K / 8K 视频播放、全景视频超分等场景下具有极高的落地潜力。