
AI 能当医生吗?深度解析临床 LLM 的共情、可读性与医学对齐
Can "AI" Be a Doctor? A Study of Empathy, Readability, and Alignment in Clinical LLMs
本文对临床大语言模型(LLMs)在医疗互动中的共情能力、可读性和对齐性进行了多维度评估。通过对比通用模型与领域专业模型(如 Med-PaLM 2, GPT-5)在 MedQuAD 和 iCliniqQAs 数据集上的表现,研究指出 LLM 在协作重写(Collaborative Rewriting)模式下展现出最强的语义保真度与情感对齐能力。
TL;DR
随着 15 万临床医生开始使用 AI 辅助患者消息处理,AI 在医疗沟通中的“软实力”变得至关重要。本文通过对 GPT-5、Claude 3.5、Med-PaLM 2 等主流模型的深度测评发现:AI 在单纯生成答案时往往表现得“用力过猛”(情绪极性大、语言太晦涩),但在充当**协作重写者(Rephrase)**时,能显著提升沟通的可读性并提供超水平的情感关怀。
背景定位
这是临床 AI 领域首批大规模针对沟通质量而非单纯逻辑事实的实证研究。通过对比 NIH 官方解释(MedQuAD)和真实的医患咨询数据(iCliniqQAs),文章为 LLM 在医疗系统中的角色设定了基调:它是沟通的润滑剂,而非决策的主裁判。
痛点深挖:AI 为何说不好“人话”?
传统的医疗 LLM 研究沉迷于诊断准确率,却忽视了患者的心理需求。
- 语言的高墙:基础版的 GPT-5 生成的医疗文档复杂度高达美国大学研究生水平(FKGL 17.6),这对普通患者无异于天书。
- 情绪的失焦:相比医生的“临床中立性”,AI 往往在“极度负面”或“过度关怀”之间摆动,无法精准复刻临床上的Detached Concern(脱离的关注)。
核心机制:三维评估模型
作者构建了一个严密的量化体系来审核 AI 的表现:
- Semantic Fidelity (语义保真度):使用医学优化的 BioBERT 计算向量余弦相似度,确保 AI 没把药方改错。
- Readability (可读性):引入 FKGL(年级水平)和 GFI(受教育年限)指标。
- Affective Resonance (情感共鸣):利用细粒度分类器检测“关怀(Caring)”、“批准(Approval)”等 28 种情绪。
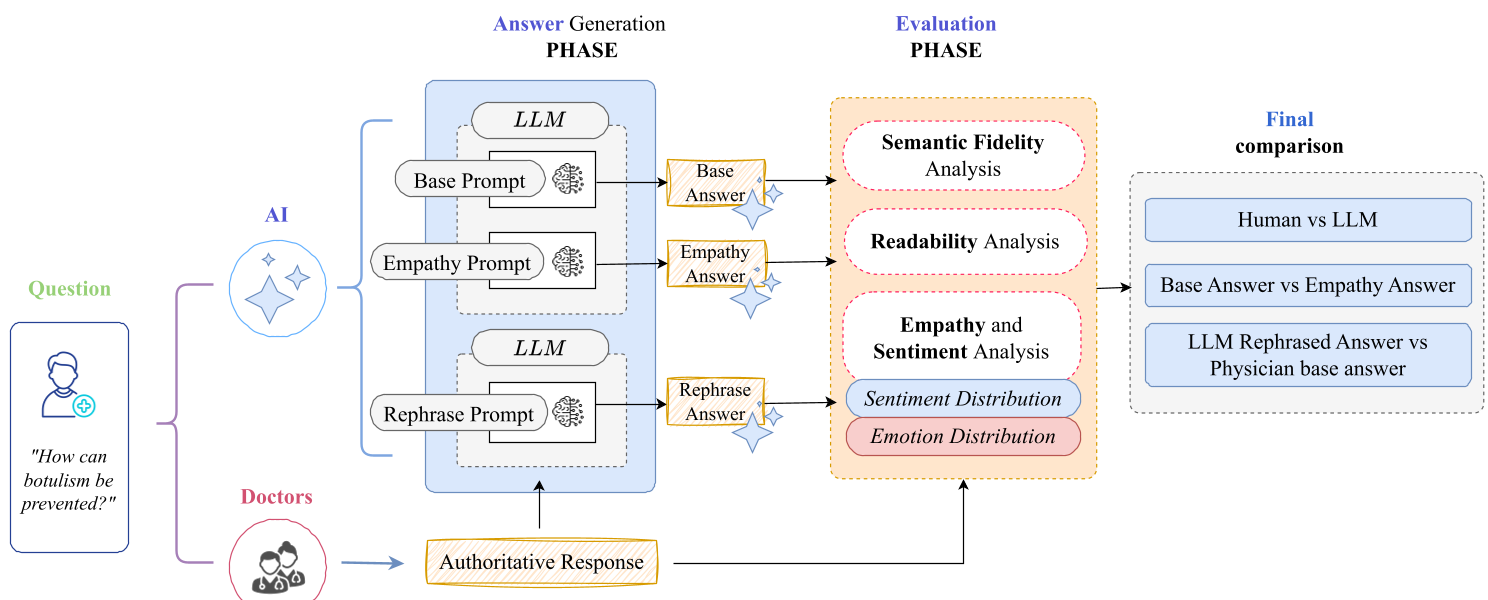 图 1:研究管线展示了从直接生成到协作重写的完整评估流程
关键发现:重写(Rephrase)才是王道
实验结果给出了一个明确的信号:给 AI 一个草稿让它改,效果远好于让它直接写。
1. 语义保真度的巅峰
无论是在严谨的 MedQuAD 数据集还是在随意的咨询对话中,**Rephrase(重写)**配置下的模型与医生原意的相似度最高(μ > 0.9)。相比之下,直接通过“Base Prompt”生成的答案有时会因安全机制而导致“拒绝回答(Safety Refusal)”。
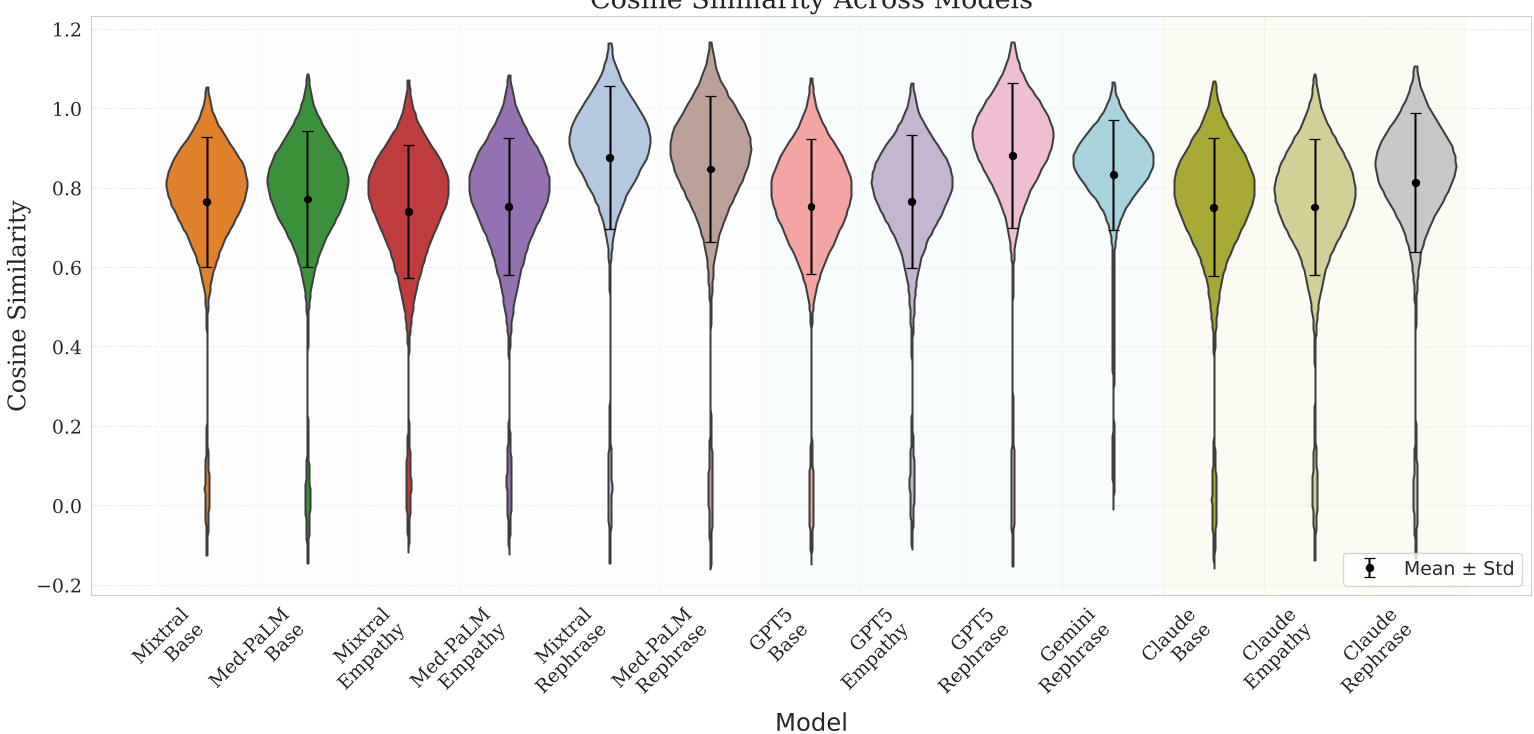 图 2:GPT-5 与 Med-PaLM 在不同配置下的语义对齐表现
2. 共情力溢出
有趣的是,研究发现 LLM 在“关怀”这一情绪指标上存在饱和倾向。在真实咨询中,模型几乎会把所有的输出都填充上支持性的语气,即使医生本人并没有那么“热情”。
3. 可读性的“大幅降维”
通过“共情提示(Empathy Prompt)”,GPT-5 的可读性得分大幅优化,将专业性极强的文字转化为了高中生即可理解的内容(FKGL 从 16.9 降至 10.0)。
专家 vs 患者:偏好的鸿沟
这是本文最有洞察力的部分:
- 专家评委:始终认为医生的原始回答在准确性和专业性上无法被超越。
- 患者评委:压倒性地偏好由 LLM 重写后的回答,认为其情感更温和、更易读、更值得信赖。
深度总结与局限性
结论 (Takeaway)
AI 模型最卓有成效的临床应用是作为沟通增强器。它能把医生生硬、专业的术语转化为患者听得懂、感受得到的暖心建议。
局限性与未来 (Future Work)
- 数据集限制:目前仅限于静态问答,未来需探讨多轮对话中的情绪稳定性。
- 文化偏差:研究基于英语环境,多语言及跨文化医疗沟通中的共情表现尚待探索。
- 重症风险:在涉及生命垂危等高风险决策(High-criticality)时,过度温和的 tone 可能会掩盖病情的严重性,这需要更精细的对齐策略。
资深编辑点评:这篇文章揭示了一个重要的产业趋势:在医疗健康领域,LLM 的第一波爆发点可能不是“AI 诊断”,而是“AI 导医”和“AI 随访助理”。技术上的 SOTA 不再仅仅是逻辑分,更是人情分。