
[ICLR 2025 投稿] 能力显著向量 CSV:打破验证损失与下游表现的“隔离墙”
Capability Salience Vector: Fine-grained Alignment of Loss and Capabilities for Downstream Task Scaling Law
本文提出了名为能力显著向量(Capability Salience Vector, CSV)的方法,旨在建立语言模型预训练验证损失(Validation Loss)与下游任务能力之间的精细化 Scaling Law。该方法通过为不同 Token 分配动态权重来提取“元能力”得分,在 50 多个开源模型及不同预训练分布的闭源模型上实现了 SOTA 级的性能预测。
TL;DR
在大模型训练中,我们常发现两个 Validation Loss 相同的模型,考试分数却天差地别。本文提出了一种名为 Capability Salience Vector (CSV) 的技术,通过给不同的 Token 损失打不同的“印象分”,成功将验证集损失与下游任务(如数学、编程、逻辑)精准挂钩。其预测误差(MSE)低至 1e-3,远超 Meta 在 Llama 3 报告中使用的基准方法。
核心定位
如果说传统的 Scaling Law 是“宏观经济学”(只看投入产出比),那么 CSV 就是“微观行为学”。它不认为所有被预测的 Token 都同等重要。相比于以往直接用 FLOPs 预测性能的方法,CSV 在数据分布发生偏移时依然稳健,是目前已知最精细的模型能力预测工具之一。
痛点深挖:为什么 FLOPs 和平均 Loss 不灵了?
作者通过实验发现两个残酷的事实:
- 数据分布的陷阱:即使计算量(FLOPs)相同,如果预训练数据比例不同,下游任务的表现会大相径庭(见下图)。
- 平均主义的黄昏:传统的验证损失是所有 Token 损失的算术平均,这假设了“预测‘the’这个词”和“预测‘解方程的关键步骤’”对模型能力的衡量价值是一样的。
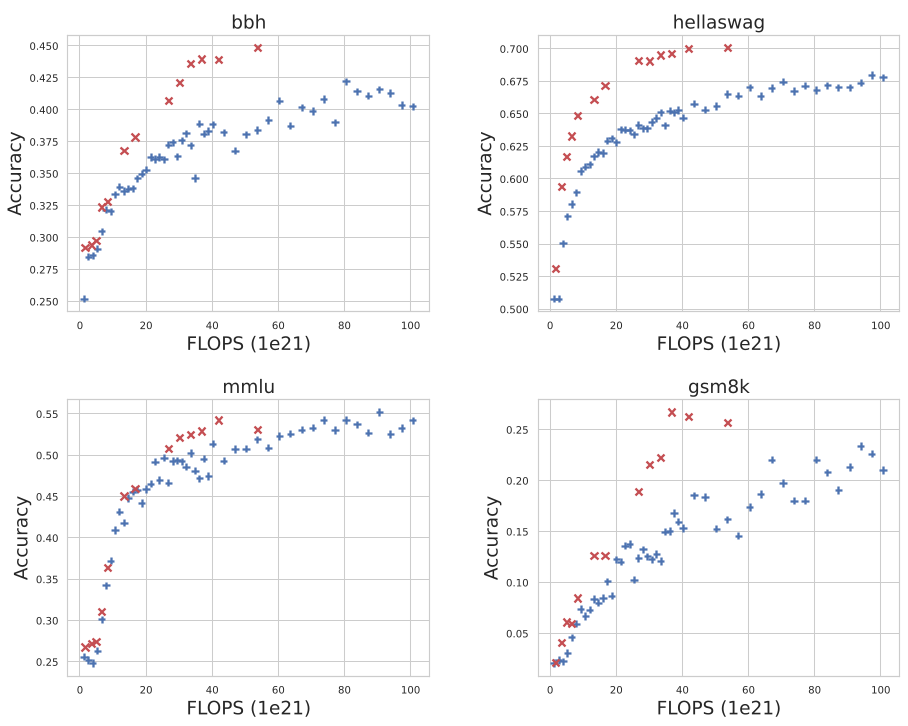 图 1:相同 FLOPs 下,不同数据分布(红蓝点)导致的任务表现显著差异。
技术详解:Capability Salience Vector (CSV)
1. 物理直觉:元能力分解
作者认为预测不同的 Token 片段需要不同的 Meta-capabilities。例如,预测代码 Token 需要逻辑推理能力,预测百科内容需要知识储备。CSV 的核心就是通过线性加权,从海量的验证损失中剥离出最能代表某种任务的“信号”。
2. 数学框架
模型的能力得分 定义为加权后的 Loss 平滑:
其中权重 由一个 frozen 的语言模型(如 InternLM2.5-1.8B)外挂一个可训练的线性头得出。最终通过一个 Sigmoidal Function 将能力得分映射到任务准确率 :
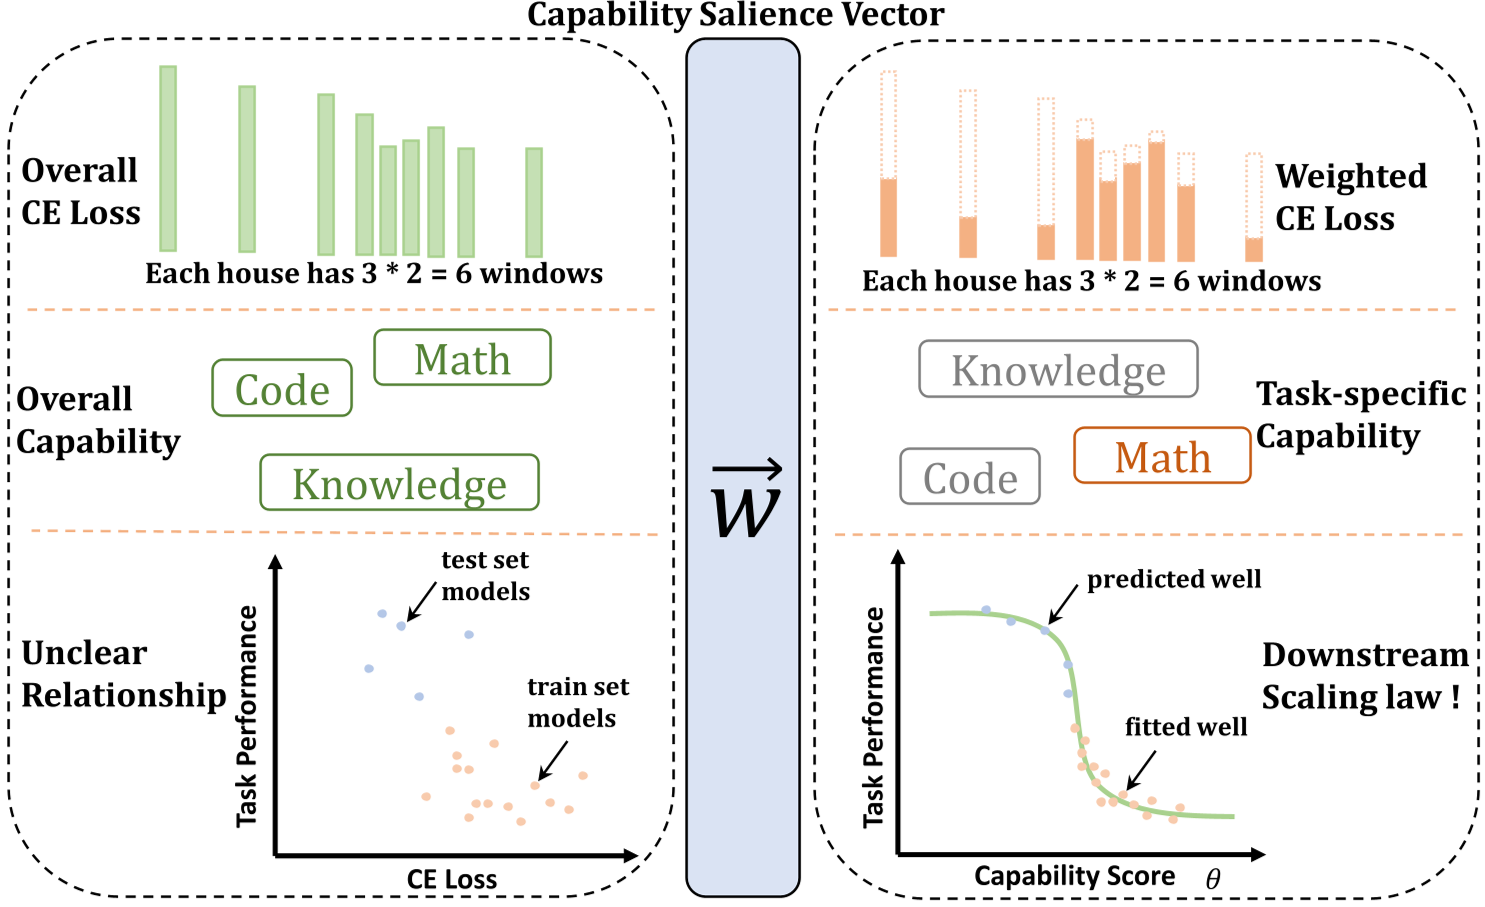 图 2:CSV 如何通过加权 Sum 将 Loss 转化为能力得分。
实验战绩:精准得令人吃惊
作者在 50 多个顶级开源模型(Llama-2/3, Qwen-2, InternLM-2.5 等)上进行了验证。
- 跨模型系列通用性:CSV 拟合的曲线能让不同家族的模型完美落在同一条规律线上。
- 预测精度:在 MMLU 和 BBH 上,CSV 的预测结果几乎与原始结果重合(见图 4)。
- 极端环境考验:即便在模型训练早期(前 50k steps),CSV 也能通过观察 Loss 的细微变化,预言模型在训练结束时的分数。
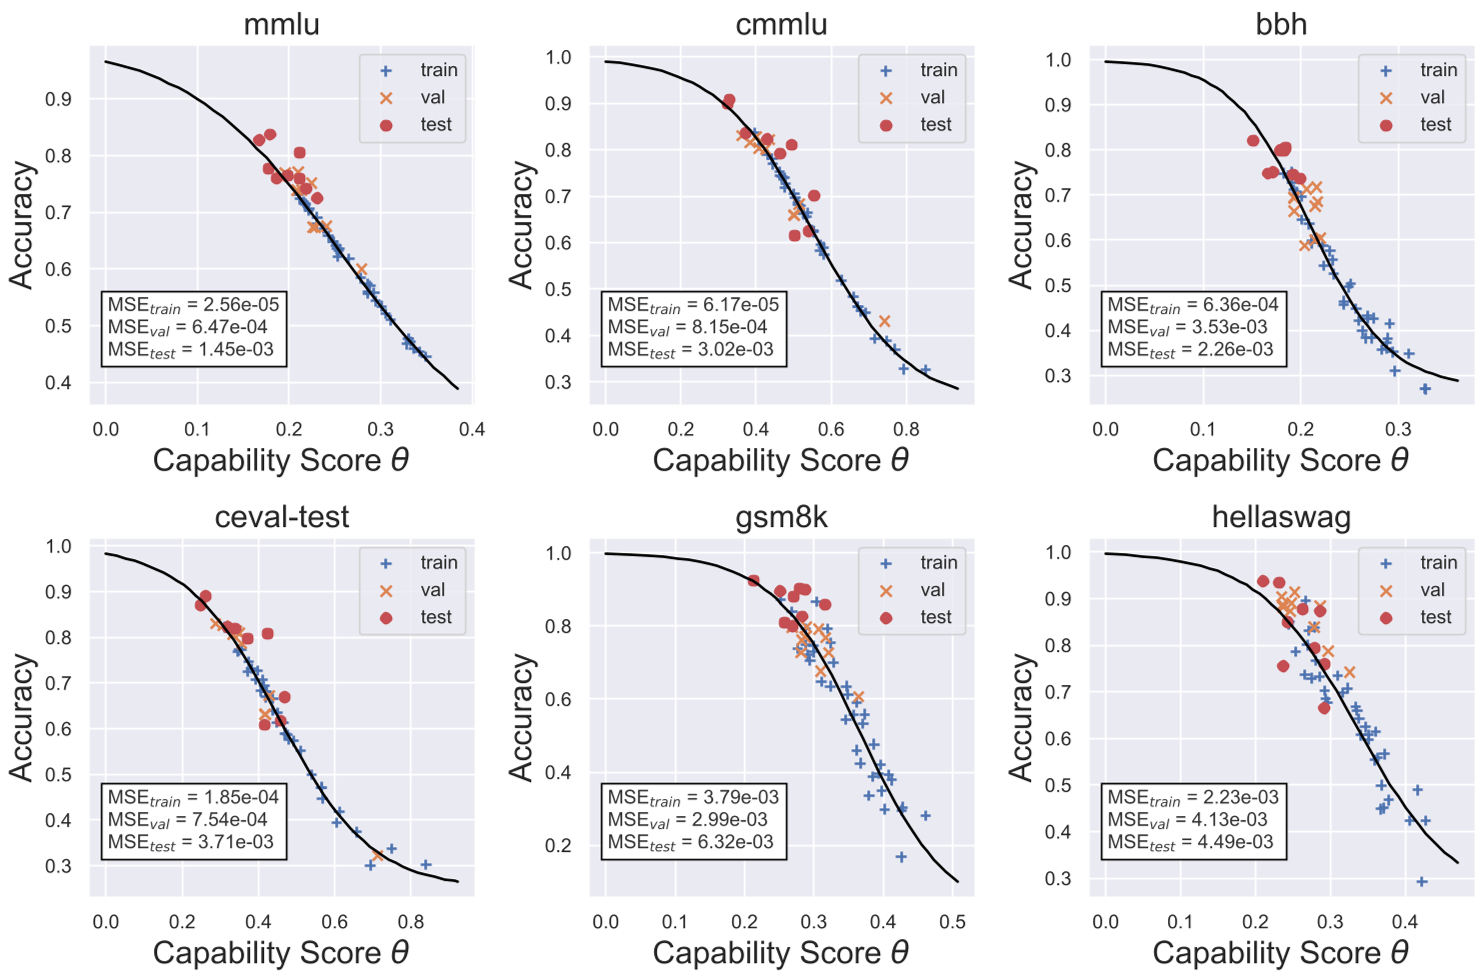 图 3:开源模型在 CSV 评分下的能力对齐,展现出极强的规律性。
深度洞察:模型到底在看哪些 Token?
通过对 的可视化(Case Study),我们能看到有趣的现象:在 BBH 推理任务中,CSV 赋予了那些涉及逻辑跳转、总结性步骤的 Token 极高的权重(图中深绿色部分)。这证明了 CSV 确实捕捉到了所谓的“元能力”相关信号。
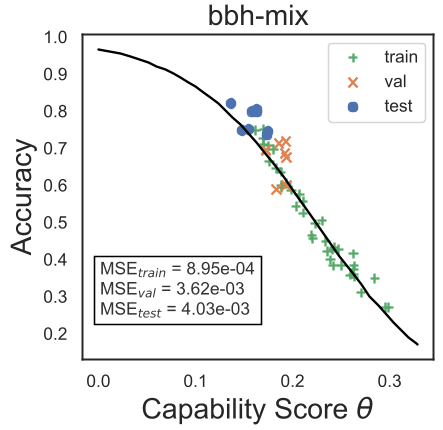 图 4:BBH 任务中,推理关键节点的 Token 被赋予了更高的显著性权重。
总结与启示
CSV 的成功告诉我们:Loss 的结构比其绝对值更重要。
- 对于开发者:你不再需要跑完整个基准测试才知道数据调优的效果,观察 CSV 权重的 Loss 变化即可预测成败。
- 对于研究者:这为解释 LLM 的“涌现能力”提供了一个量化视角——涌现或许只是某些特定 Token 的 Loss 跨越了 CSV 权重的阈值。
局限性:尽管有效,但目前优化 CSV 权重仍需一定的计算成本,且验证集文本的选择对结果有较大影响。未来如何通过更少的数据点(更优的样本采样)实现极速预测,将是更前沿的课题。