
Causal Concept Graphs:捕捉 LLM 潜在空间中的多步推理逻辑
Causal Concept Graphs in LLM Latent Space for Stepwise Reasoning
本文提出了因果概念图 (Causal Concept Graphs, CCG),这是一种通过集成任务条件化的稀疏自编码器 (SAE) 与基于 DAGMA 的微分结构学习,从语言模型潜在空间中提取可解释概念及其因果依赖关系的新框架。在 GPT-2 Medium 上的实验表明,该方法在 ARC-Challenge 等逻辑推理任务中成功恢复了稀疏且稳定的因果结构。
TL;DR
尽管我们已经能够利用稀疏自编码器 (SAE) 定位 LLM 中的语义特征,但这些特征如何像齿轮一样协作完成多步推理仍是一个黑箱。本文提出的 Causal Concept Graphs (CCG) 首次结合了稀疏特征提取与因果结构学习。通过在 GPT-2 Medium 上的验证,CCG 能够自动构建出逻辑严密的有向无环图 (DAG),其在预测激活干预效果的准确性上(CFS 分数)远超现有的 ROME 和 SAE 排序基线。
背景:从“语义定位”到“逻辑追踪”
在机械可解释性(Mechanistic Interpretability)领域,我们已经习惯了将模型比作一个巨大的词典。然而,面对“StrategyQA”或“LogiQA”这类复杂的推理任务,单一的概念激活无法解释决策的全过程。
作者指出,现有的方法存在两个主要痛点:
- 分布式推理的缺失:像 ROME 这样的模型编辑方法虽然强大,但它们针对的是单点事实(如“巴黎是大法国的首都”),而非复杂的组合逻辑。
- 虚假相关的干扰:单纯看哪个神经元或 SAE 特征激活最强是不够的,因为高激活的概念可能是推理链条中的“下游噪声”,而非掌握因果权力的“上游驱动者”。
核心方法论:两阶段的因果挖掘
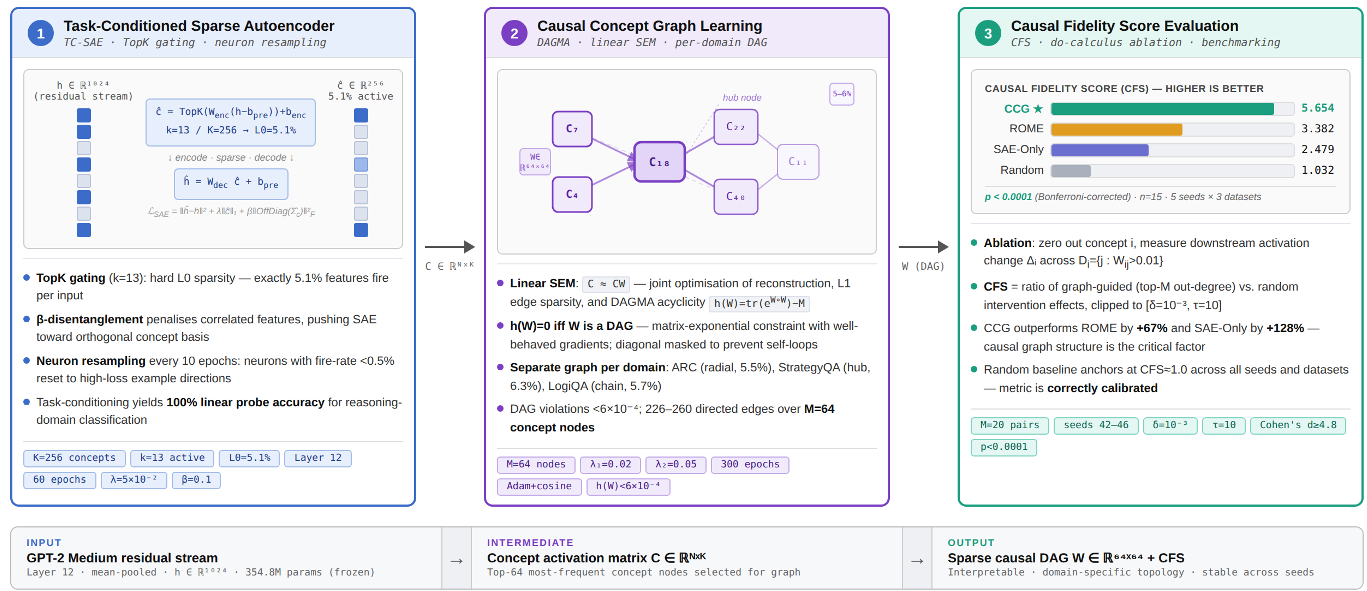
1. 任务条件化的稀疏自编码器 (Task-Conditioned SAE)
为了从海量的激活残差流中提取出纯净的推理概念,作者改进了常规的 SAE:
- TopK 门控:不同于传统的 L1 正则化(会产生幅度缩减),TopK 强制每层只开启 13 个最相关的概念(L0 激活率约 5.1%),确保了特征的单语义性和数值稳定性。
- 神经元重采样:解决了“死神经元”问题,确保每个提取出的概念维度都能有效参与模型表达。
2. 基于 DAGMA 的因果图学习
获得概念激活矩阵 后,CCG 面临最大的挑战:如何从这些并发的激活中理出先后顺序? 作者引入了由 Bello 等人提出的 DAGMA 算法。它利用矩阵指数的迹(Trace of Matrix Exponential)来将离散的图搜索问题转化为连续的梯度优化问题: 这个公式本质上是在计算图中是否存在闭环。当 时,我们就能获得一个完美的有向无环图(DAG),从而揭示概念间的流向。
实验与结果:因果保真度的降维打击
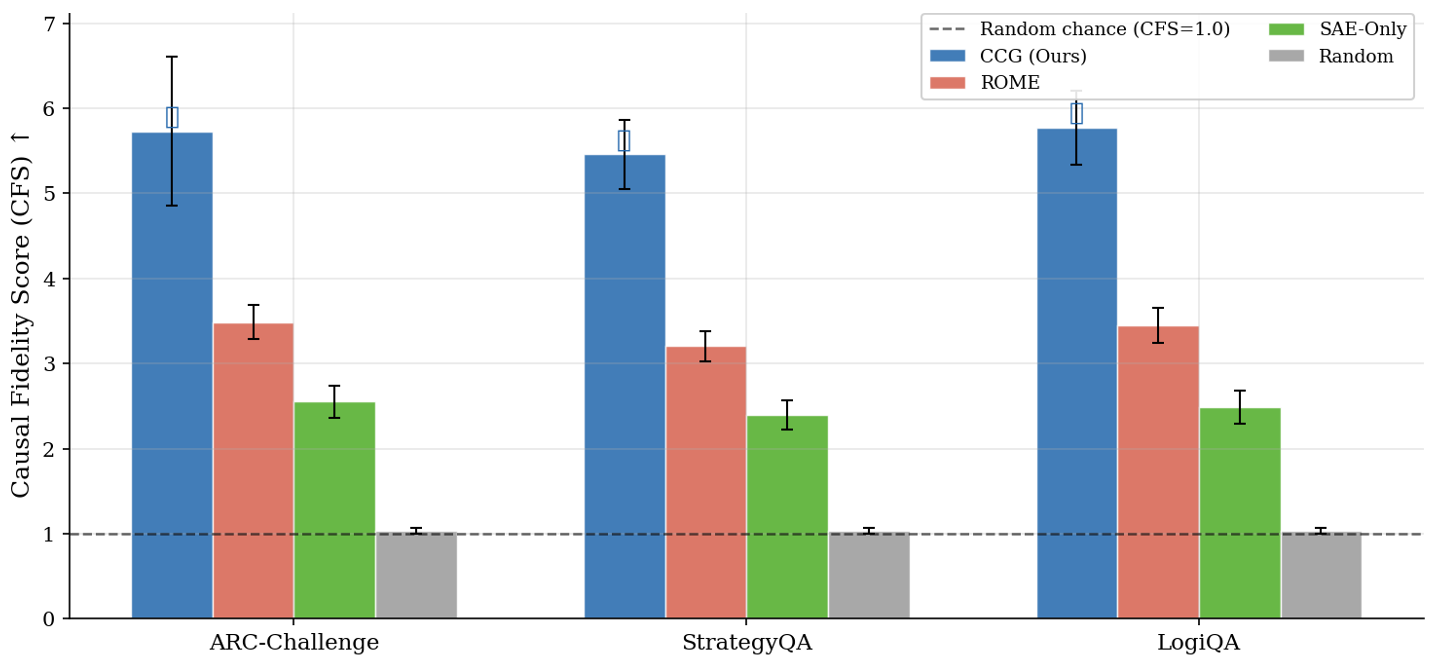
作者定义了一个关键指标:因果保真度分数 (Causal Fidelity Score, CFS)。其逻辑非常直观:如果我们预测概念 A 是概念 B 的因果上游,那么当我“抹除”概念 A 时,模型下游激活产生的震荡应当远大于抹除一个随机概念产生的震荡。
核心战绩
- 性能碾压:CCG 在多个推理数据集上的平均 CFS 达到 5.654,而 ROME 仅为 3.382。这意味着 CCG 识别出的“核心节点”对模型推理的影响力是随机节点的 5 倍以上。
- 稀疏拓扑:学习到的因果图极其精简(边缘密度仅 5-6%),却具有鲜明的领域特征。例如,在 LogiQA 中,图结构呈现出明显的“链式”推理特征;而在 StrategyQA 中,则出现了类似于“网关节点”的中心化枢纽结构。
消融实验揭示的真相
实验显示,层深度(Extraction Depth)对效果影响巨大。作者在第 12 层(L12)提取特征,发现这个深度是特征区分度与下游干预影响力的最佳平衡点。此外,如果移除 DAG 的无环约束,CFS 分数会显著下降 26%,这验证了因果层级结构在 LLM 推理中的真实存在性。
深度洞察:为什么这很重要?
CCG 的成功不仅仅是刷高了一个指标,它向我们揭示了 LLM 内部逻辑的一个本质:高激活不代表高影响力。 在复杂的推理链中,许多概念可能只是推理结果的“副作用”或附属品。CCG 通过因果介入(Intervention)的方式,强行剥离了这些伪相关,让我们可以像观察电路图一样观察 LLM 的思考过程。
局限性与未来展望
尽管 CCG 迈出了重要一步,但它仍基于线性结构方程模型(Linear SEM),而 Transformer 内部的交互显然更加非线性。未来的研究可以将非线性因果发现与多层跨层级的图建模相结合,从而捕捉更深度的“思维火花”。
总结
CCG 为 LLM 的诊断和审美提供了一套全新的透视工具。它告诉我们,理解 AI 的关键不在于它存储了多少事实,而在于它如何通过内部的因果逻辑,将这些事实串联成应对复杂挑战的推理链条。