
模仿学习的因果陷阱:为什么有时候“知之越多,行之越错”?
Causal Confusion in Imitation Learning
本文揭示了模仿学习中的“因果混淆”(Causal Confusion)现象,即模型错误地将由于动作产生的后果(如刹车灯亮)当作动作的原因。作者提出了通过图参数化策略(Graph-Parameterized Policy)结合目标干预(Targeted Intervention)的方法,从因果层面引导模型识别真正的动作诱因。
TL;DR
在模仿学习(Imitation Learning)中,简单的行为教导往往会适得其反。本文由阿姆斯特丹大学和 Berkeley AI Research 团队合作,揭示了一个深层痛点:因果混淆(Causal Confusion)。当模型获得过多信息时,它可能会将“结果”误认为“原因”。作者提出了一种结合因果图搜索与目标干预的方法,在极少额外代价的前提下,彻底解决了由于分布偏移导致的策略崩溃。
背景定位与痛点深挖
行为克隆(Behavioral Cloning)的核心假设是:如果我能完美地预测专家的动作,我就能像专家一样行动。但在复杂的时序决策中,这个假设是致命的。
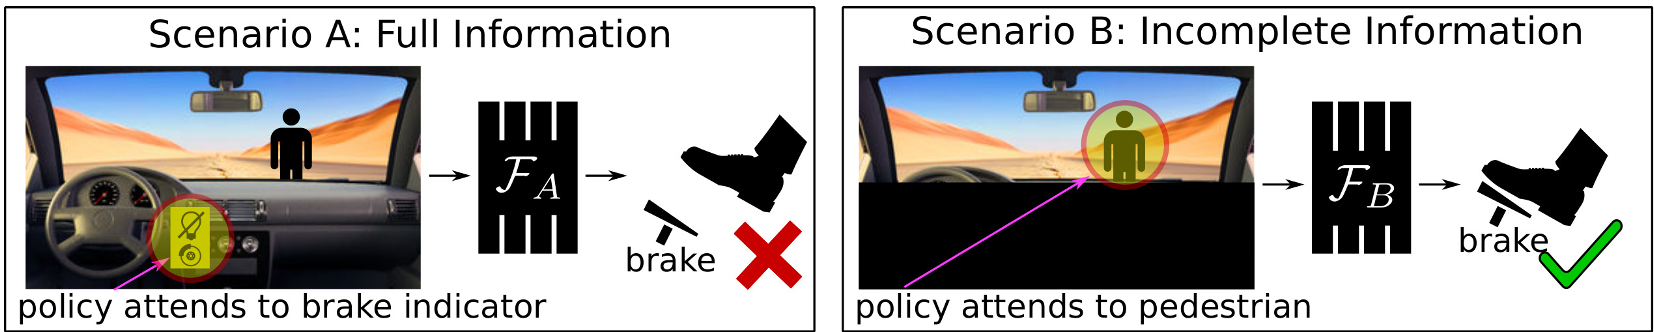
想象一个自动驾驶场景(图 1):
- 策略 A:能看到仪表盘和路面。
- 策略 B:只能看到路面。
直觉上 A 应该更好,但实验发现,策略 A 可能会观察到“刹车灯一亮,专家就踩刹车”,从而学到了 刹车灯 踩刹车。然而在闭环测试中,除非它执行刹车,否则灯不会亮。这种**因果误判(Causal Misidentification)**会导致灾难性的失败。
方法论详解:通过干预拆解真相
1. 因果图参数化策略 (Graph-Parameterized Policy)
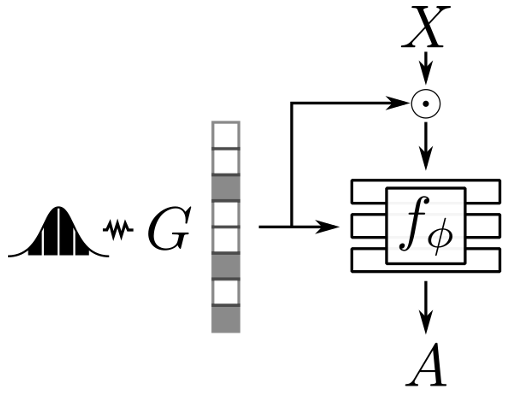
为了找到真正的因果变量,作者设计了一个通用的策略网络 。它不仅接收状态 ,还接收一个二进制掩码 (代表候因果图)。通过在训练期间随机采样 ,模型可以学会:如果在给定这些特征的情况下,专家的动作会是什么。
2. 目标干预 (Targeted Intervention)
训练完成后,我们拥有了一组候选策略,每一个策略都代表一种关于“什么才是因果”的假设。如何选出对的那一个?
- 策略执行模式 (Policy Execution):在环境中直接跑这些方案。如果是基于“刹车灯”决策的方案,它在现实中肯定跑不远。通过环境奖励(Return),我们可以反推哪个 才是真相。
- 专家查询模式 (Expert Query):当不同 下的策略预测不一致(Disagreement)时,去问专家。这比盲目的训练数据扩增高效得多。
实验与结果:降维打击般的效率
作者在经典的控制任务(如 MountainCar, Hopper)和 Atari 游戏中进行了验证。结果显示,原本因为加入干扰信息(如上一时刻动作)而导致性能崩溃的行为克隆模型,在经过几轮干预后,能够迅速识别出哪些是垃圾特征。
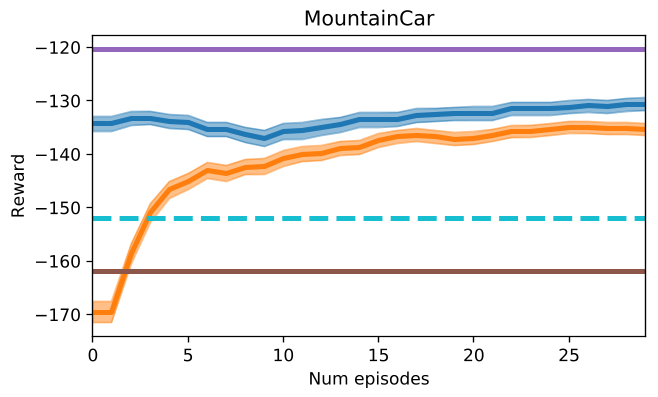
- 对比 DAgger:DAgger 需要数万次的专家查询才能缓解分布偏移,而本文的方法只需要几十次。
- 对比 GAIL:GAIL 虽然能缓解混淆,但在样本效率上完全被本方法碾压(1500 次 vs 数十次交互)。
深度洞察:关于解耦(Disentanglement)的思考
本文的一个隐含前提是状态特征是解耦的(Disentangled)。对于图像输入,作者使用了 -VAE 来预处理特征。实验证明,如果特征是纠缠在一起的(例如旋转过的状态向量),因果搜索的效果会大幅下降,因为模型无法单纯通过“剔除某个维度”来切断伪因果联系。
总结与局限性
《Causal Confusion in Imitation Learning》不仅在技术上提供了一个解决分布偏移的新策略,更在哲学层面上给 AI 研究者敲了警钟:预测性能(Validation Loss)不等于策略质量。
其局限性在于:目前的因果发现仍依赖于解耦表征的质量。对于极度复杂的视觉场景,如何自动定义干预的原子单位依旧是一个挑战。
Takeaway: 未来鲁棒的模仿学习系统,必须具备对环境进行“主动科学实验”(因果干预)的能力,而不仅仅是做一名安静的旁听生。