
Causal Forcing++:攻克实时交互视频生成的“最后一公里”
Causal Forcing++: Scalable Few-Step Autoregressive Diffusion Distillation for Real-Time Interactive Video Generation
本文提出了 Causal Forcing++,这是一种可扩展的自回归(AR)扩散蒸馏框架,旨在实现实时交互式视频生成。通过引入因果一致性蒸馏(Causal CD),该方法首次在单帧 2 步推理的极端设置下,实现了超越 SOTA 的生成质量与物理一致性。
TL;DR
清华大学、生数科技与人民大学的研究团队发布了 Causal Forcing++,将自回归视频扩散模型的推理推向了极端的 单帧 1-2 步 时代。通过全新的 因果一致性蒸馏(Causal CD),该模型在显著降低延迟(-50%)和训练成本(-4x)的同时,刷新了交互式视频生成的性能记录。
1. 痛点:为什么实时视频生成这么难?
当前的视频生成模型正从“内容工具”转向“交互式世界模型”(如 Sora, Genie)。然而,实现类似电子游戏的实时交互需要极低的延迟和流式输出。
目前的自回归 (AR) 扩散模型虽然能生成长视频,但面临两个瓶颈:
- 架构错位:很多方法用双向(Bidirectional)教师模型去初始化自回归学生模型,导致学生在推理时因为看不见“未来”而产生严重的模糊和伪影。
- 扩展性瓶颈:现有的 SOTA 方法(如 Causal Forcing)需要预生成数万条预测轨迹并存储,这在处理大规模数据(如 80K+ 视频)时简直是存储和算力的噩梦。
2. 核心直觉:从全局回归到局部一致
作者发现,初始化少步数(Few-step)学生模型的本质是学习教师模型的 流映射 (Flow Map)。
以往的 ODE 蒸馏(Causal ODE Distillation)强迫学生一次性从高噪声跳跃到清晰图像,这就像让学生直接背诵高考满分作文;而 Causal Consistency Distillation (Causal CD) 则是让学生学习如何从 时间步推导到相邻的 时间步,保持局部逻辑的一致性。
关键架构:Causal Forcing++ 管线
 图 1: Causal Forcing++ 与前代方法的对比。核心改进在于 Stage 2 的 Causal CD 初始化。
这种方法的物理直觉非常精妙:由于 非常小,优化误差更低,且无需预计算轨迹,实现了 “边练边学” (Online Supervision)。
3. 方法论详解:为何不选 Score Distillation?
论文深入探讨了一个引人深思的问题:为什么在图像领域大火的 DMD (Score Distillation) 在视频 AR 蒸馏中表现不如 CD?
- Mode-Seeking vs Mode-Covering:DMD 倾向于寻找分布的峰值(模式寻求),这虽然能产生很锐利的图像,但在自回归过程中,一点微小的历史误差(History Drift)就会让模型陷入错误模式,导致视频后期景象崩溃。
- 抗漂移能力:Causal CD 学习的是分布覆盖(Forward KL),对历史累积误差更具鲁棒性。
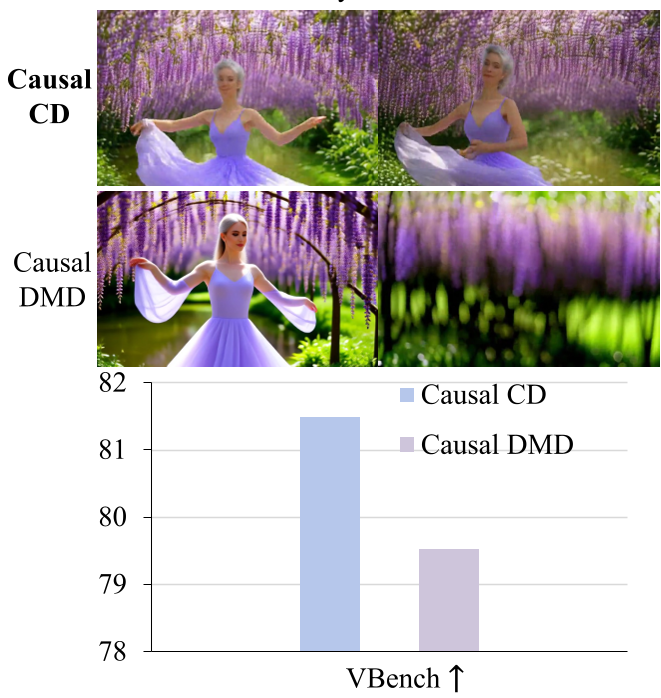 图 2: 实验证明,Causal DMD(右)虽然前几帧很清晰,但后期会发生严重的场景漂移;而 Causal CD(中)保持了极佳的稳定性。
4. 实验战绩:更快、更稳、更强
研究团队在 Wan2.1-1.3B 基础上进行了实验。结果显示,Causal Forcing++ 在极其苛刻的 2-Step Frame-wise 模式下,依然在 VBench 和 VisionReward 等多项指标上碾压了传统的 4-Step Chunk-wise 方法。
| 指标 | Self Forcing | Causal Forcing | Ours (2-step) |
|---|---|---|---|
| VBench Total | 83.74 | 84.04 | 84.14 |
| 首帧延迟 (Latency) | 0.60s | 0.60s | 0.27s |
| 训练成本 (GPU Hours) | 5000 | 11600 | 2900 |
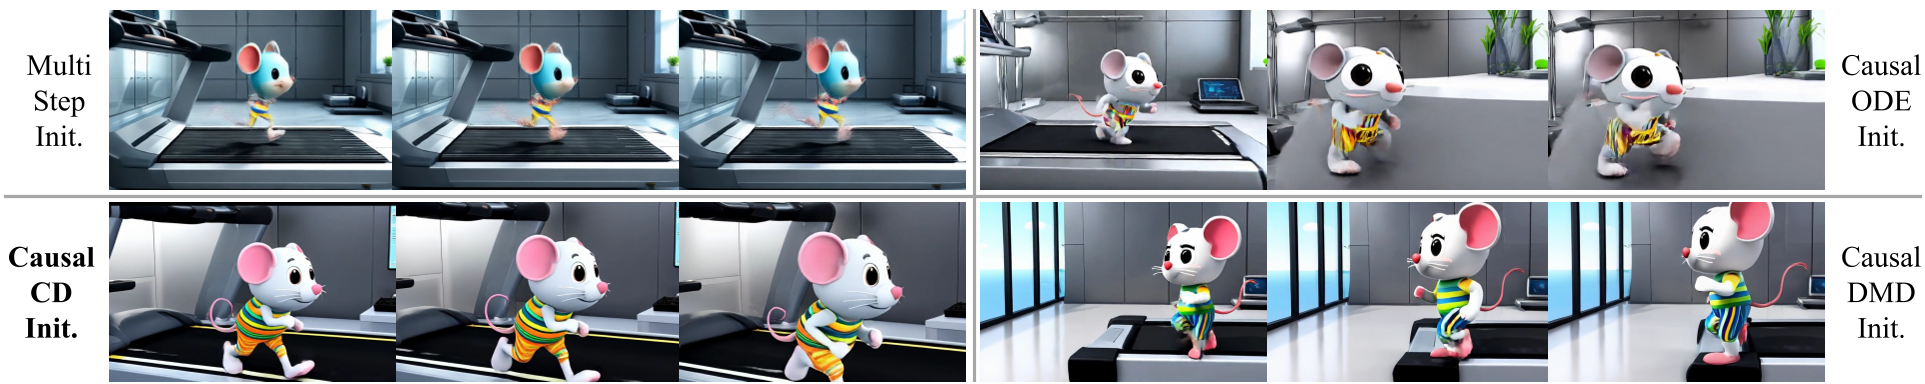 图 3: 不同初始化方法在 1-step 模式下的最终生成效果。可以看到 Causal CD 最好地平衡了动态度和视觉质量。
5. 展望:动作控制的世界模型
除了纯文本驱动,Causal Forcing++ 还可以轻松扩展到 动作控制 (Action-conditioned) 领域。通过注入相机姿态(Camera Pose),模型可以变身为一个实时的虚拟环境模拟器。
总结
Causal Forcing++ 的意义在于,它通过“正确且高效”的初始化,弥补了自回归扩散模型中长期存在的训练-推理偏差(Exposure Bias)。它告诉我们:在处理复杂的时序生成时,局部逻辑的一致性比全局结果的堆砌更重要。