
CoRAG:让 RAG 像 o1 一样“深度思考”,在迭代检索中突破多步推理瓶颈
Chain-of-Retrieval Augmented Generation
本文提出了 CoRAG (Chain-of-Retrieval Augmented Generation),这是一种模仿 o1 思路、让模型在生成最终答案前进行逐步检索与推理的 RAG 框架。该方法在多步推理任务中表现卓越,在 KILT 基准测试及多个多跳问答(Multi-hop QA)任务上刷新了 SOTA 纪录。
TL;DR
微软与人大联合推出的 CoRAG (Chain-of-Retrieval Augmented Generation) 将“慢思考”逻辑引入了 RAG 领域。它不再满足于一次性的搜索,而是通过自动构建的检索链进行多轮迭代、子查询分解和自我纠正。实验证明,该方法在处理复杂逻辑任务时,仅凭 8B 模型便能碾压许多参数量更大的基线。
背景定位:从 Linear RAG 到 Agentic RAG
当前的 RAG 系统大多是“一锤子买卖”:拿到问题 -> 检索文档 -> 生成答案。这种模式在处理诸如“某某摔跤手所在的队伍是什么?”这类问题时,若检索器第一步没找对人名(Rehwoldt),后续生成必错无疑。CoRAG 的出现,标志着 RAG 正在从简单的“插件模式”进化为具有规划能力的 Agent 模式。
核心动机:检索质量的“天花板”
作者敏锐地指出,检索器的精度受限于双编码器(Bi-encoder)的表达能力,且复杂问题的所需信息往往隐藏在多个步骤之后。与其追求完美的单一检索器,不如让 Generator 学会动态重构查询。这种“发现线索 -> 调整搜索 -> 最终汇总”的过程更符合人类解决复杂知识问题的直觉。
方法论:CoRAG 的三大支柱
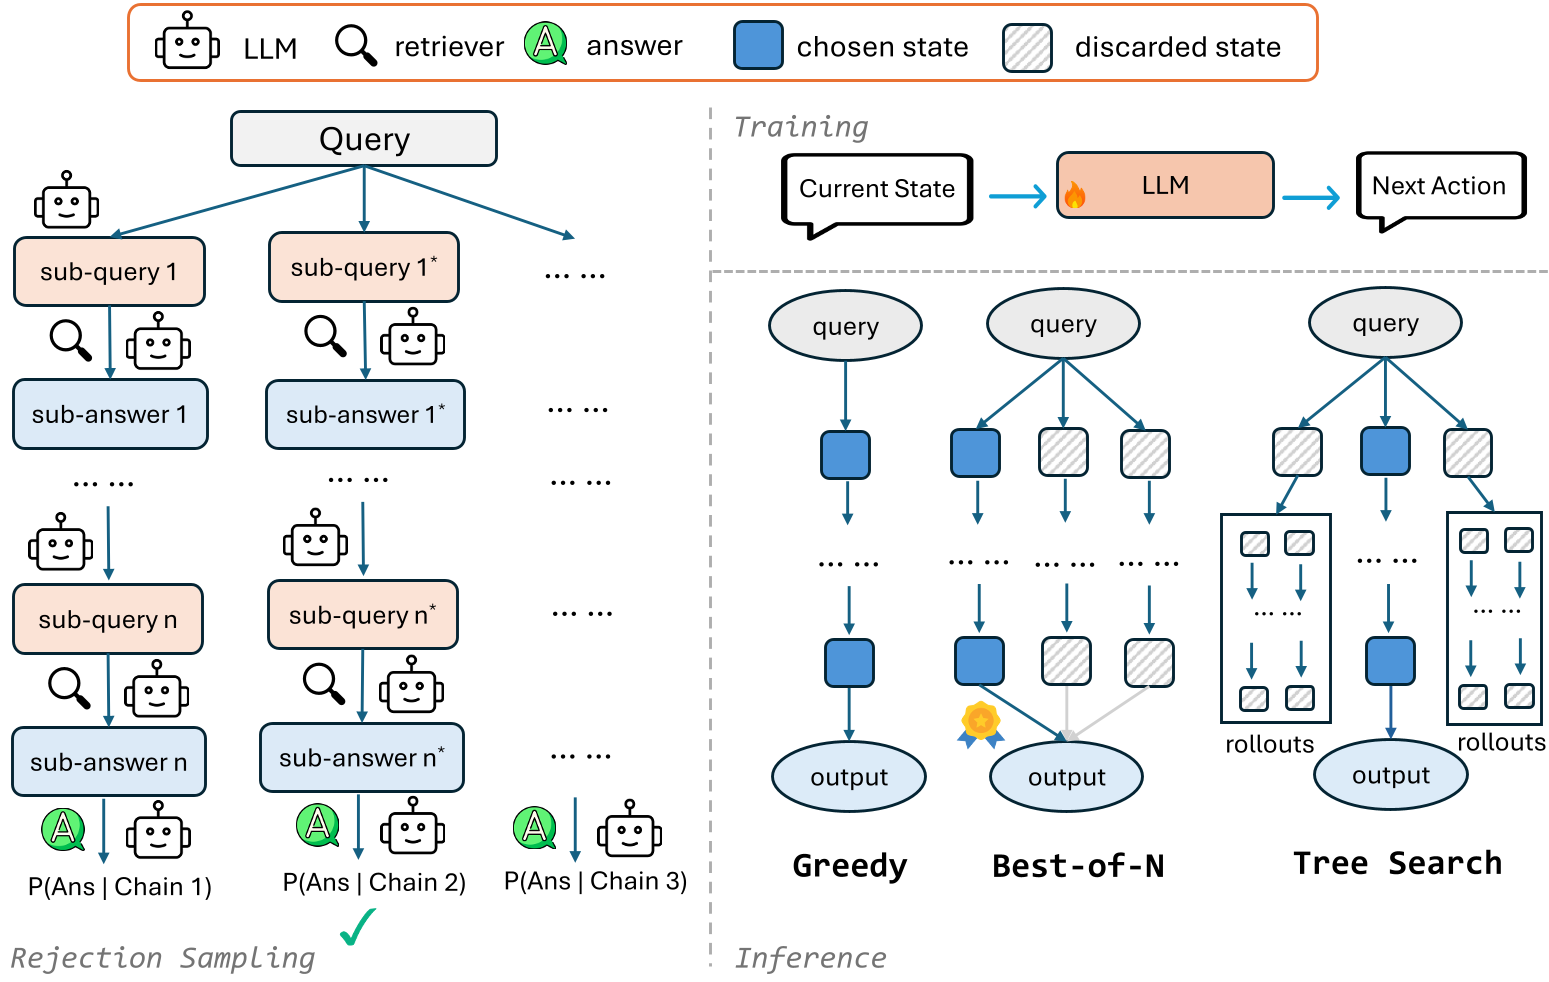
1. 数据的“炼金术”:拒绝采样构建检索链
由于现有数据集大多只有 Q&A 对,缺乏中间过程。作者利用 Llama-3.1-8B 通过 Rejection Sampling 自动合成检索路径。只有那些能让模型最终以高概率命中正确答案的路径才会被保留,用于后续的微调。
2. 模型训练:多任务协同
CoRAG 模型在微调阶段被要求同时学习三个能力:
- 预测下一个子查询:决定接下来搜索什么。
- 生成子答案:从当前检索结果中提取局部知识。
- 生成最终答案:通过检索链汇总全局信息。
3. 推理时缩放 (Test-time Scaling)
这是 CoRAG 最具前瞻性的部分。类似于 OpenAI o1,CoRAG 允许在推理时通过不同的策略来换取性能:
- Greedy Decoding: 追求速度,每步选概率最高的路径。
- Best-of-N: 采样 N 条路径,选“相关性最高”的一条。
- Tree Search: 构建搜索树,通过分叉和回溯探索最佳答案。
实验战果:全面的 SOTA 碾压
在著名的 KILT 知识密集型任务榜单上,CoRAG-8B 的表现令人侧目:
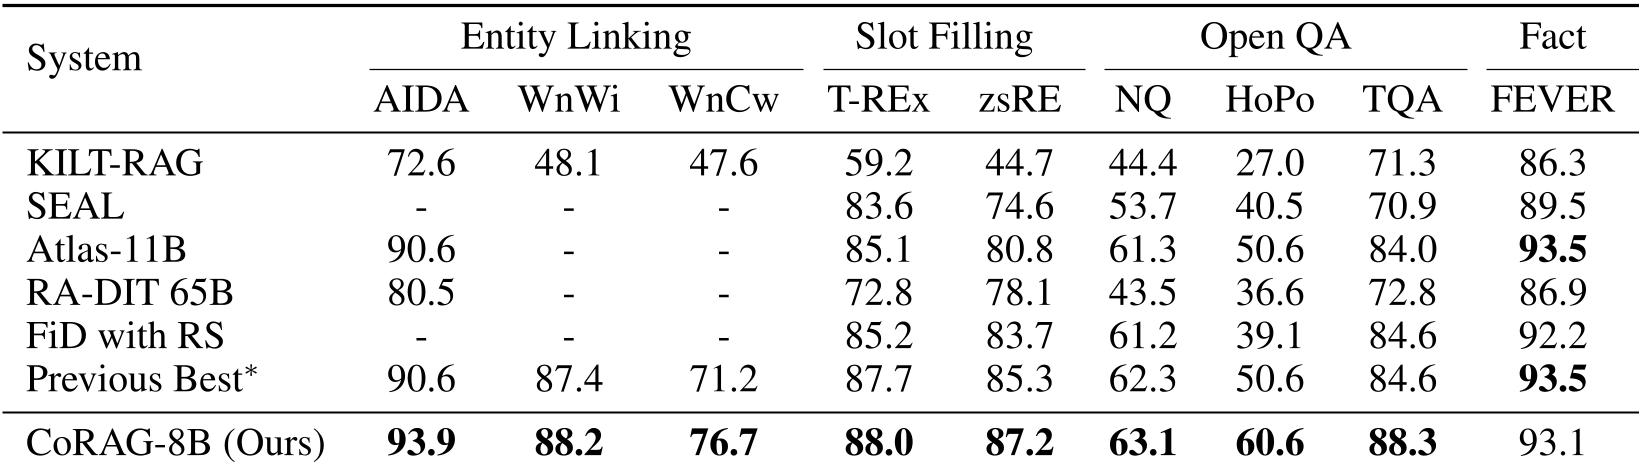
- 多跳问答: 在 MuSiQue 和 2WikiMultihopQA 等任务上,EM 分数相比直接检索提升了 10-40% 不等。
- 缩放法则: 实验显示,token 消耗量与性能之间存在明显的正相关。这意味着我们终于可以通过“加钱(加算力)”来让 RAG 模型变得更聪明。
深度洞察:什么时候需要“检索链”?
有趣的是,论文发现 CoRAG 并非在所有场景下都无敌。对于单跳问题(如 NQ 数据集),单次检索已经足够,检索链反而可能带来性能稀释或无谓的开销。
结论:模型的复杂度应与问题的复杂性自适应。 作者为此提出了 Learning to Stop 机制,让模型自己判断“信息够了吗?”,实现了效率与精度的动态平衡。
总结与局限
CoRAG 的价值在于它提供了一套完整的“数据合成-训练-推理缩放”闭环方案。
- 局限性:多轮检索带来的高延迟和高 Token 成本在生产环境仍需优化;目前对非 Wikipedia 类型的数据源支持尚待验证。
- 展望:当 RAG 拥有了思维链(CoT),它将不仅仅是知识的搬运工,而是真正能够自主拆解、验证和解决问题的知识专家。
本文为学术前沿解读,原文参考:Chain-of-Retrieval Augmented Generation EM (Wang et al., 2024)