
CHIMERA:揭穿视觉语言模型在示意图理解中的“刷分”真相
Chimera: Diagnosing Shortcut Learning in Visual-Language Understanding
本文推出了 CHIMERA,一个包含 7,500 个高质量 Wikipedia 示意图的深度评估基准。该基准通过语义三元组(Semantic Triples)和多层级问题,系统评估了 15 种主流 Vision-Language Models (VLMs) 在实体识别、关系理解、知识对齐和视觉推理方面的表现,揭示了模型普遍存在的“走捷径”现象。
TL;DR
别被 Vision-Language Models (VLMs) 在图表基准测试中的高分欺骗了!由 ETH Zurich 和 Google DeepMind 合作完成的研究 CHIMERA 指出:当前顶尖模型(如 Qwen2.5-VL, LLaMA-3.2-Vision)在处理示意图(Diagrams)时的强劲表现,相当一部分来自于走捷径 (Shortcut Learning)。模型往往不是在“看图说话”,而是在“背图说知识”或“通过问题猜答案”。
1. 动机:当 AI 变成“做题家”
示意图(如电路图、生物转化流程图)是人类传达复杂逻辑的高级视觉语言。虽然各大 SOTA 模型在 ChartQA 等榜单上屡创新高,但研究者开始怀疑:模型是真的看懂了图中的箭头和拓扑结构,还是仅仅因为它在预训练时见过这张 Wikipedia 里的图?或者它只是在利用 LLM 强大的常识来强行“预测”答案?
为了拆穿这种伪装,研究团队引入了符号学(Semiotics)中的 Semiosis 理论过程,将理解拆解为:实体识别 (ER) 关系理解 (RU) 知识对齐 (KG) 视觉推理 (VR)。
2. 诊断方法:模态解耦与一致性检查
CHIMERA 的精妙之处在于它不仅提供原图,还将每张图背后代表的知识结构化为语义三元组 (Semantic Triples)。
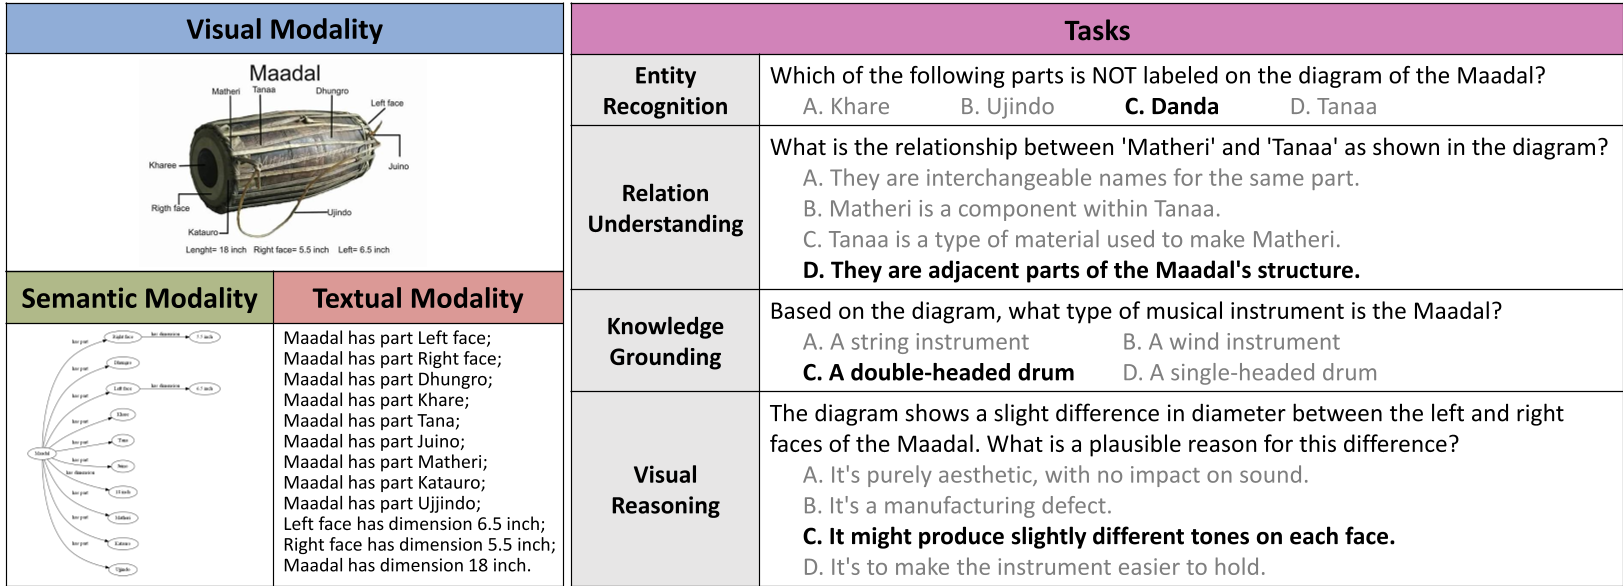 图 1:CHIMERA 的三模态设计:视觉(左上)、语义(左下)与文本(中)对等存在。
这种设计使研究者可以进行三项“压力测试”:
- 视觉记忆测试:比较原图和更干净、排版更优化的语义图。如果模型在杂乱的原图上得分更高,说明它在“背图”。
- 知识召回测试:比较简单任务(识别图里有什么)和难任务(根据图做推理)。如果模型识别不出实体却能做对推理,说明它在调取后台知识库。
- 聪明汉斯测试:给模型一张“空白图”,只让它看问题。
3. 核心发现:三大捷径无处不在
捷径 A:视觉记忆 (Visual-memorization)
实验发现,模型在视觉模态上的表现(80.6%)竟然略好于更结构化的语义模态(76.1%)。这在物理直觉上是不合理的——明明语义模态已经过滤了视觉噪声。这表明模型对 Wikipedia 常见的视觉样式有一定的记忆效应。
捷径 B:知识召回 (Knowledge-recall)
最反直觉的发现是:模型在最简单的“实体识别”任务上表现最差。例如,在分析一个散点图时(见图 6),LLaMA-90B 甚至认不出这是散点图(认成了折线图),却能准确说出数据的趋势。
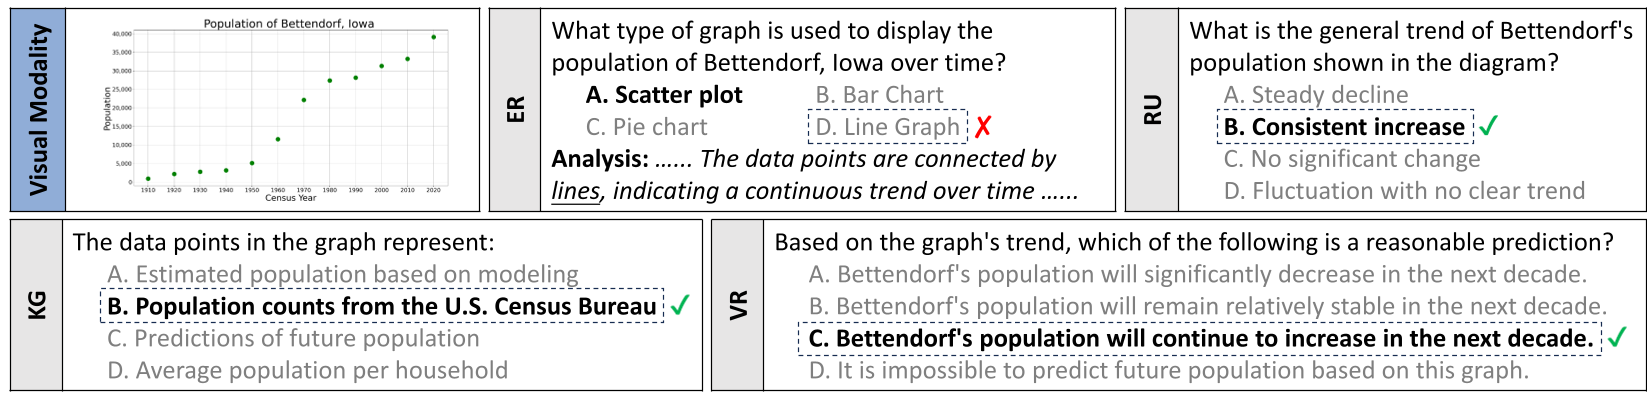 图 2:模型虽然“眼瞎”认错图表类型,却能靠“脑补”答对复杂的趋势预测。
捷径 C:语言先验 (Clever-Hans)
这是最严重的漏洞。研究者通过“空白图像”实验发现,像 Qwen2.5-VL-3B 这样的模型,即便不看图,单凭问题和选项的文本关联,也能在实体识别中获得显著高于随机猜测的分数。
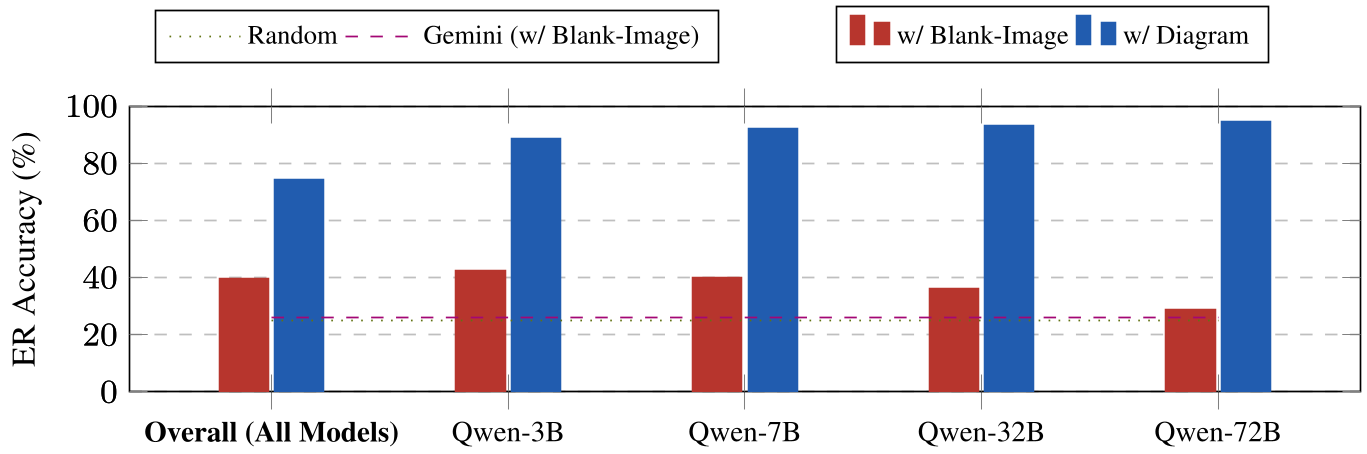 图 3:Normal 与 Blank-image 设置下的对比,显示了模型对文本模式的极度依赖。
4. 深度洞察与总结
CHIMERA 的出现为 VLM 的评估敲响了警钟。
- 规模并非万能药:虽然 72B 或 90B 的大模型比小模型更不易受“聪明汉斯”效应影响,但它们在“知识召回”上的弊端反而可能因为后台知识太丰富而加剧。
- 真理解的鸿沟:目前的 VLMs 依然更像是一个“带有视觉补丁的 LLM”,而非真正的多模态推理机。
结论 (Takeaway): 真正的多模态理解不仅需要识别像素,更需要将像素与符号逻辑严密对应。CHIMERA 证明了,如果我们不加甄别地使用现有数据集,我们可能只是在训练更加精明的“投机者”,而非具有智慧的观察者。对于未来的 VLM 研究,如何抑制语言先验并增强视觉接地的准确性,仍是通往 AGI 的必经之路。