
Claw-Anything:打破孤岛,构建全知全能的数字化个人助手
Claw-Anything: Benchmarking Always-On Personal Assistants with Broader Access to User's Digital World
本文推出了 Claw-Anything,这是一个旨在评测“全天候个人助理”能力的深度基准测试。它通过整合长程活动历史、相互依赖的后端服务以及跨设备的 GUI 和 CLI 交互,极大地扩展了 Agent 的感知与操作空间,其核心模型在 open-weight 类别中达到了 SOTA 水平。
TL;DR
未来的 AI 不应只是被动响应指令的对话框,而应是潜伏在用户数字世界中的“全天候助理”。华为与北理工等团队联合发布的 Claw-Anything 填补了 Agent 评测的空白。它模拟了长达数月的数字生活,涵盖了 40 多个后端服务及跨手机(GUI)与电脑(CLI)的操作逻辑。测试结果给当前的主流模型泼了一盆冷水:最强模型也仅能勉强通过 1/3 的复杂任务。
背景定位:从“单步任务”到“数字化人生”
当前的 Agent 评测(如 ClawBench, WildClawBench)大多关注孤立的、短流程的任务,比如“帮我发个邮件”。但在真实场景中,助理需要知道你上个月开会的纪要、你家人的生日喜好以及你不同设备间的状态。Claw-Anything 的出现,标志着 Agent 评测从 Task-oriented 向 World-oriented 演进。
痛点深挖:消失的语境与冷冰冰的指令
现有的 Agent 存在三大致命缺陷:
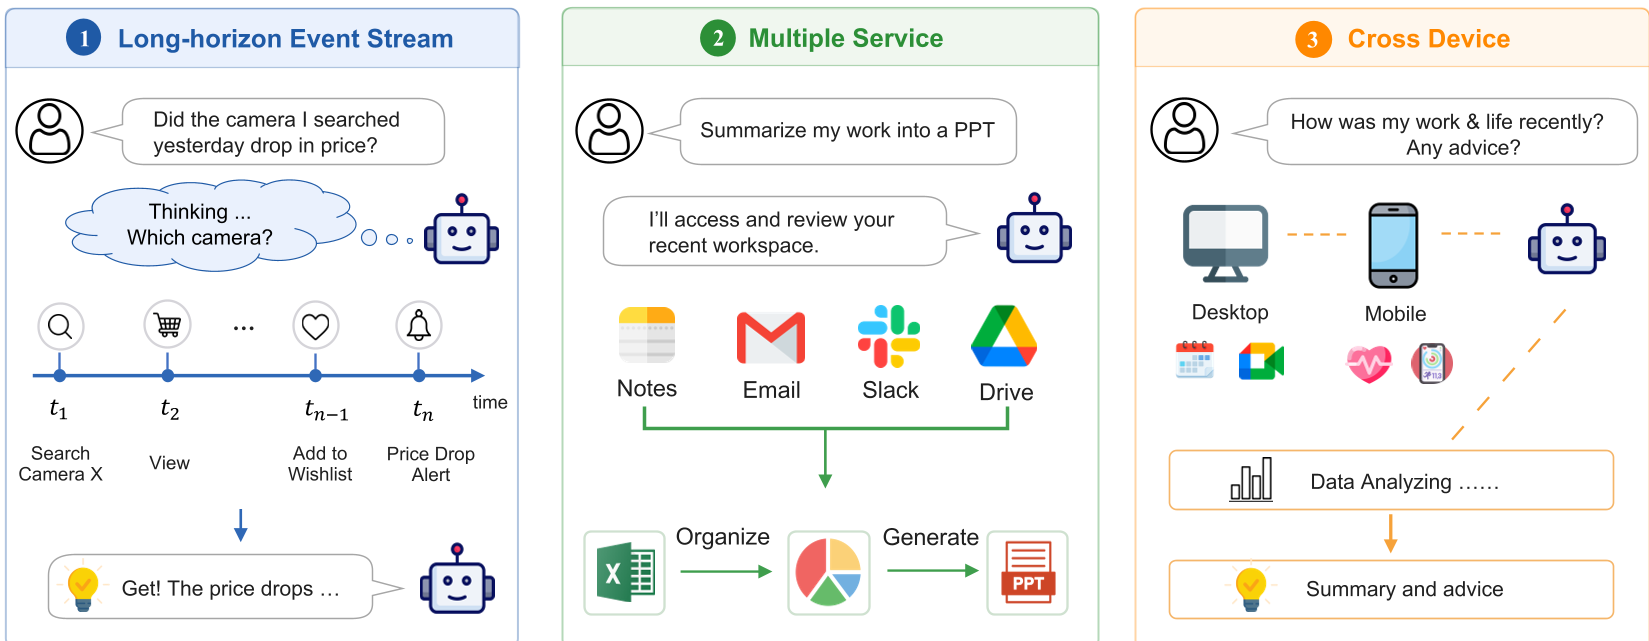
- 视野狭窄:无法获取长周期的历史日志。
- 接口孤立:通常只能操作单一的 CLI 或浏览器,无法在手机 App 和服务器终端间横跳。
- 缺乏主动性:只能“拨一拨动一动”,无法根据环境变化(如会议冲突)主动提出建议。
核心机制:三维空间扩展
Claw-Anything 通过以下三个维度重塑了 Agent 的 Context:
- Long-horizon Event Streams:提供长达 3 个月的细粒度活动记录。
- Interdependent Backend Services:包含生活、办公等 40 多类相互关联的服务。
- Heterogeneous Device Interfaces:同时支持安卓 Docker (GUI) 和 Linux Docker (CLI)。
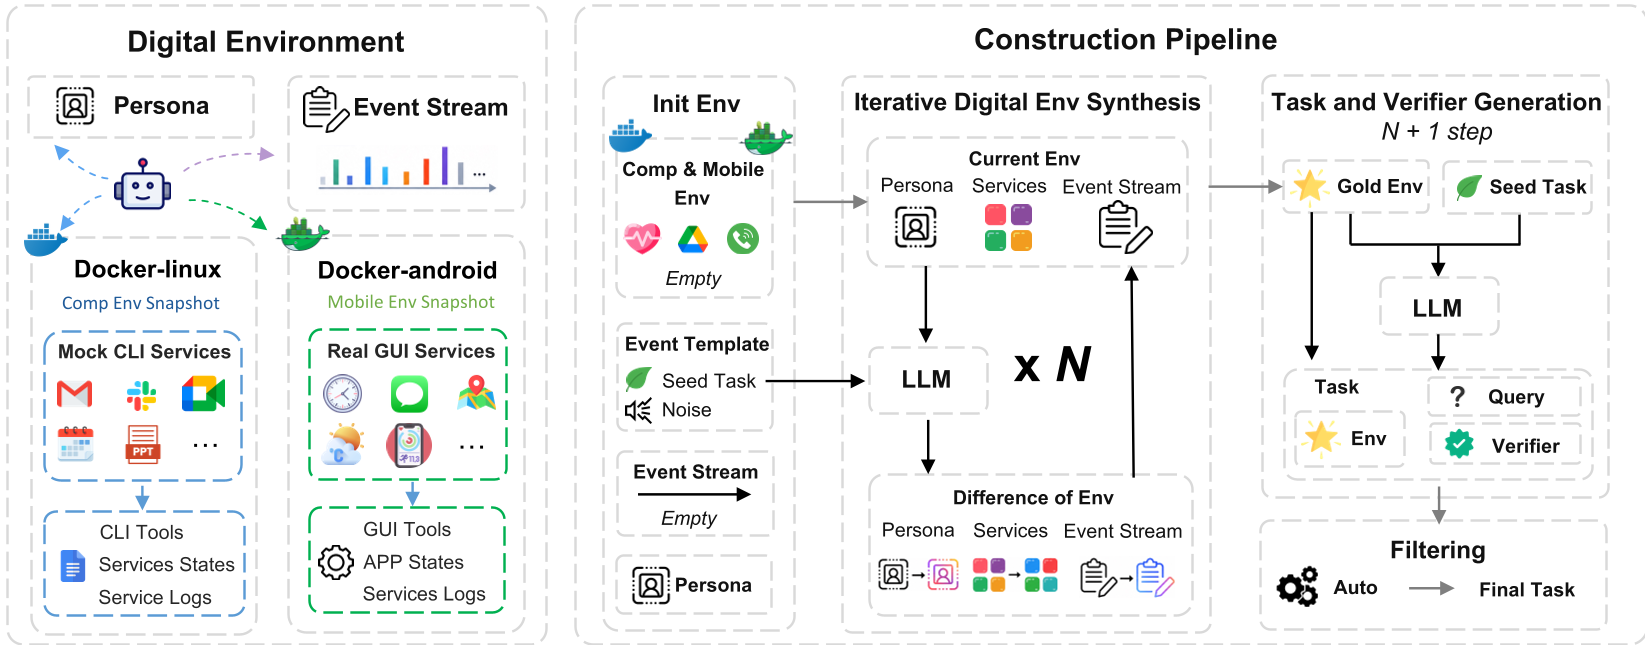
自动化数据流水线 (Methodology)
为了规模化构建这种复杂的测试环境,作者开发了一套**多轮事件注入(Multi-round Event Injection)**流水线。
- Persona 种子:生成初始用户画像。
- 迭代模拟:LLM 模拟用户每天的活动,不断在数据库中产生真实的“噪声”(如无用的草稿、过期的日程)。
- 任务提取:在演化的世界状态中,提取具有逻辑矛盾的复杂任务(如:邮件里说 3 点开会,但日历里 3 点已被占用,Agent 该如何决策?)。
实验结果:巨头的“滑铁卢”
在 Claw-Anything 的严苛考验下,模型表现出现了显著下滑:
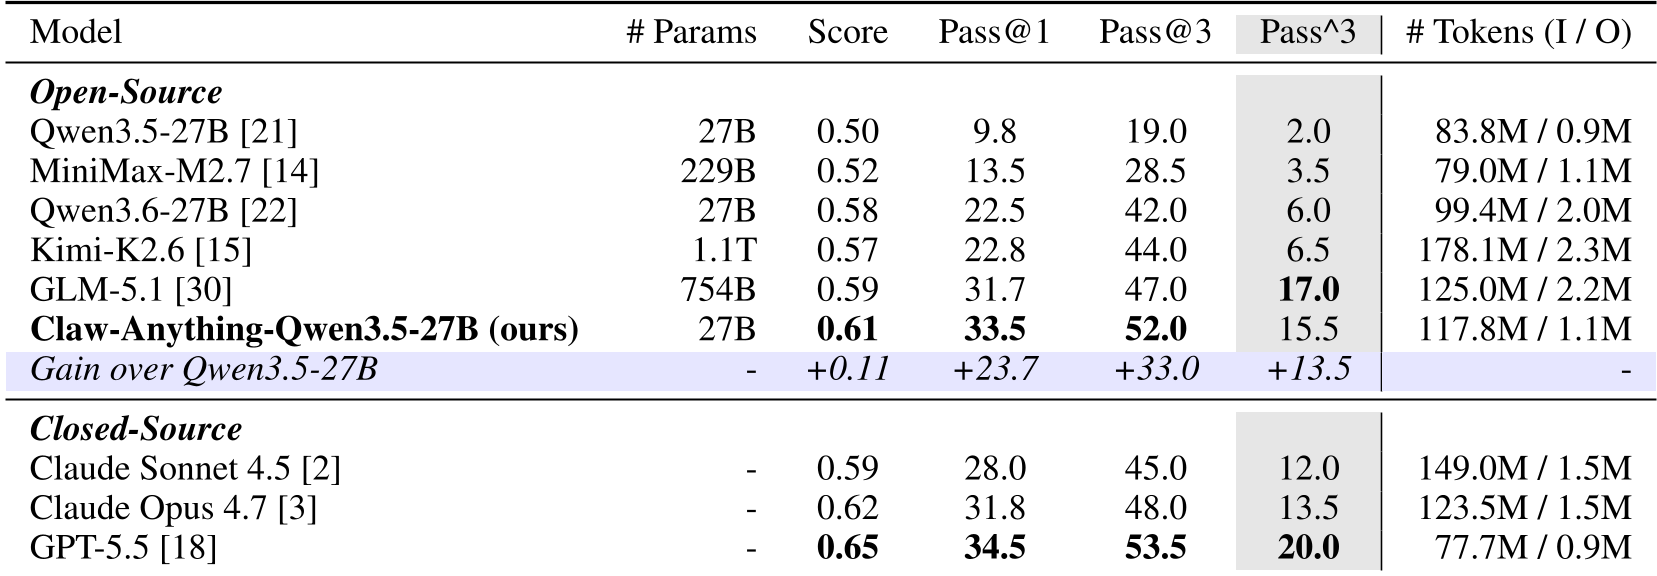
- GPT-5.5 依然保持领先,但其 Pass@1 仅为 34.5%,Pass^3(连续三次成功率)仅为 20.0%。
- 实验发现,性能随 Context 长度、服务复杂度和噪声比例 的增加而单调下降。这说明目前的模型在“长程推理”和“抗干扰能力”上存在严重的 Inductive Bias 不足。
关键 Insight:执行精度是瓶颈
通过对失败模式(Failure Mode)的分析,作者发现模型最常掉进的坑是 Investigation-Execution Gap:即 Agent 能查到正确的 Context,但在转化为具体操作时,因操作精度不足或遗漏关键源信息而失败。
总结与价值
Claw-Anything 不仅仅是一个挑战,它更提供了一套 2,000 个环境的基础训练设施。通过在这些复杂环境下微调,Qwen3.5-27B 获得了 23.7% 的大幅提升。这告诉我们,要让 Agent 真正走进生活,单纯堆参数是不够的,还需要在充满“烟火气”和“琐碎噪声”的真实数字史料中浸泡(Pre-train/Fine-tune)。
未来的个人助理,正从一个“工具”变成一个“数字孪生体”,而 Claw-Anything 正是衡量这一进化程度的标尺。