
CMTM:稠密 Token 调制与掩码学习,定义无监督视频分割新高度
CMTM: Cross-Modal Token Modulation for Unsupervised Video Object Segmentation
本文提出了 CMTM (Cross-Modality Token Modulation),一种用于无监督视频目标分割 (UVOS) 的新型跨模态令牌调制框架。该方法通过稠密 Transformer 块 (Dense Transformer Blocks) 同步强化外观与运动特征的交互,并在 DAVIS 2016 等多个主流基准测试中达到 SOTA 性能。
核心速览
TL;DR:针对无监督视频目标分割 (UVOS) 中外观与运动特征融合不充分的痛点,延世大学的研究团队提出了 CMTM (Cross-Modality Token Modulation)。该方法通过 Dense Transformer Block 实现了深度的像素级模态交互,并创新性地引入了 Token Masking 训练策略,强制模型学习更具判别力的特征表示。
背景定位:本项目属于 UVOS 领域中基于“双流架构”的 SOTA 刷榜之作。它不仅在精度上超越了现有的算法(如 FakeFlow, GSA-Net),更在理论上证明了“增加模型复杂度”必须与“辅助引导任务”相结合才能发挥最大效力。
痛点深挖:为什么双流融合总是“貌合神离”?
传统的无监督视频分割主要依赖 RGB 图像(外观)和 光流图(运动)。目前的痛点在于:
- 模态内表示不纯净:编码器提取的特征往往包含大量背景噪声,缺乏对显著物体语义的聚焦。
- 模态间交互流于表面:很多工作只是简单地将两个特征图进行 Concatenate 或加权,没有建立起像素级的深层依赖关系,导致运动信息无法有效修正外观偏差。
方法论详解:CMTM 的核心机理
1. 稠密 Transformer 块 (Dense Transformer Block)
CMTM 抛弃了简单的融合逻辑。它将外观 Token () 和运动 Token () 拼接在一起,输入到一个共享的 Self-Attention 层中。
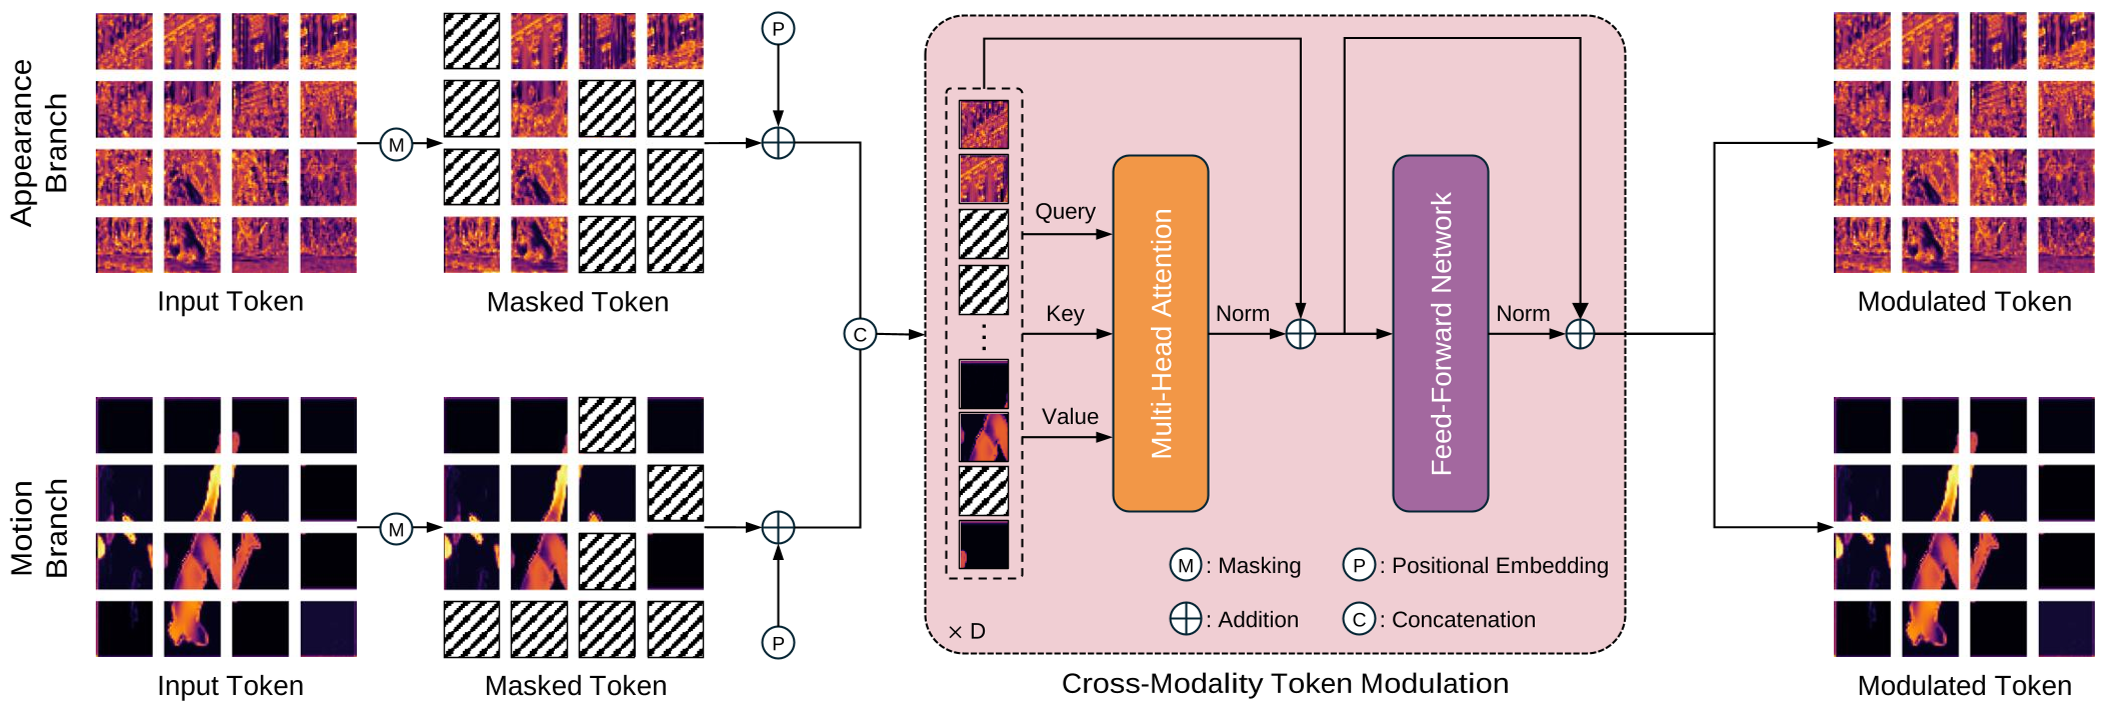
其数学直觉非常清晰:通过一个统一的注意力矩阵,模型不仅在做外观特征的自增强 (),还在利用运动信息去调制外观表示 ()。这种对称的结构确保了两者的深度耦合。
2. Token Masking:让模型学会“脑补”
这是本文最精彩的设计。作者发现,直接堆砌 Transformer 块会导致模型过拟合,对噪声过于敏感。
- 策略:在训练阶段,按比例(推荐 0.4)随机遮盖外观和运动的 Token。
- 直觉:如果模型能从残留的少量运动脉络和部分外观碎片中还原出完整的物体轮廓,说明它真正理解了物体的语义,而不是在背诵像素。这种方式强迫模型关注全局上下文。
实验与结果
SOTA 对比
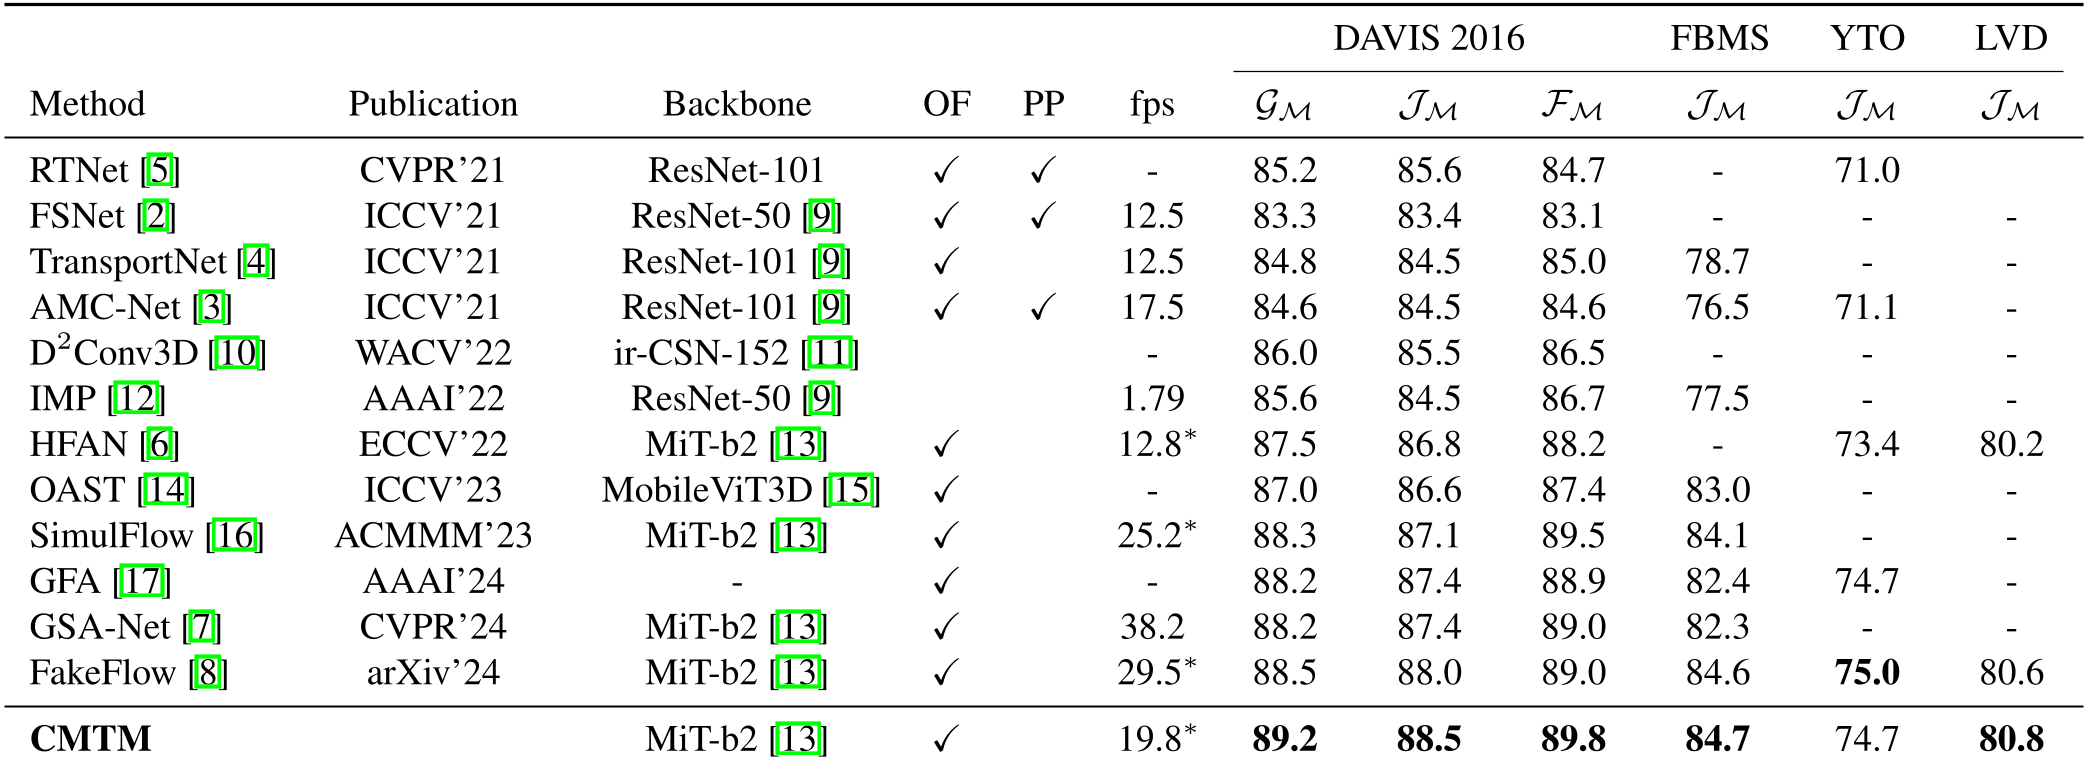
在主流的视频分割基准上,CMTM 展现了统治力。如下表所示,即便在使用轻量级 backbone(MiT-b0)的情况下,它的表现依然坚挺,而在 MiT-b2 上则刷新了记录。
特征可视化
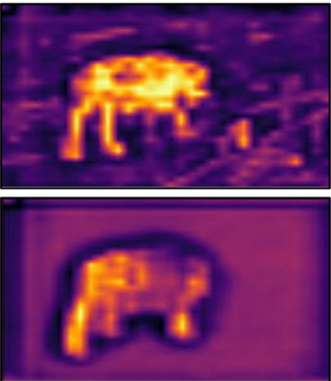
通过可视化对比可以发现,CMTM 处理后的特征图(Feature Map)边界更加清晰,能够显著抑制背景杂波,使解码器能精准地勾勒出物体边缘。
深度洞察与总结
Takeaway:CMTM 的成功证明了,在处理像视频这种具有高度冗余性和模态差异的任务时,稠密交互 (Dense Interaction) 与 破坏性学习 (Masked Learning) 是相辅相成的。
- 局限性:由于引入了稠密的 Token 级别计算,在极高分辨率视频下的计算开销(FLOPs)会略高于简单的加权融合模型。
- 未来展望:这种 Token 调制的思想可以很自然地迁移到其他多模态领域,例如音频-视频同步、或者医疗影像中不同序列(MRI/CT)的配准与分割中。
CMTM 不仅仅是一个更强的算法,它为如何优雅地处理“多源信息互补”提供了一个标准的范式。