
AUTO MAT:当代码 Agent 遭遇科学复现,“顶级程序员”缘何折戟沉沙?
Can Coding Agents Reproduce Findings in Computational Materials Science?
本文推出了 AUTO MAT,这是首个专门评估 LLM Agent 在计算材料科学领域端到端科学复现能力的基准测试。该基准包含 85 个由领域专家(SME)策划的真实论文声称,要求 Agent 在 HPC 环境中自主完成从阅读论文、导航复杂工具链到执行模拟并验证结果的全流程,目前最强 Agent 的成功率仅为 54.1%。
TL;DR
如果说 SWE-bench 是检验 AI Agent 能否成为合格的软件工程师,那么 AUTO MAT 则是要测试它们能否胜任科学家的“数字化助手”。约翰霍普金斯大学的研究团队推出的这一基准测试发现,强如 Claude 4.6 或 GPT-5.4,在面对计算材料科学论文的端到端复现任务时,成功率最高仅为 54.1%。
背景定位:这是首个深入垂直科学领域(计算材料学)、强调“从文本到物理证据”全路径复现的 Agent 评估基准,填补了通用代码生成与真实科研场景之间的鸿沟。
1. 痛点:为什么“会写代码”不等于“会做科研”?
在传统的软件工程中,需求通常是显性的,且伴随配套的单元测试(Unit Tests)。但在科学复现场景下,Agent 面临的是一个典型的“欠定性”问题:
- 隐含知识(Tacit Knowledge):论文作者往往不会交代所有的 DFT 截断能、K 点网格设置或特定的伪势文件选择。
- 工具链泥潭:Agent 需要在 HPC 环境中操作 Quantum ESPRESSO、LAMMPS 等重型模拟软件,任何环境变量错位都会导致任务崩溃。
- 解释的艺术:跑出数字只是第一步,判断这个数字是否支持论文中的“声称”才是核心逻辑所在。
2. AUTO MAT 架构设计:如何评估“科学直觉”?
AUTO MAT 包含 85 个专家精心挑选的任务,分为三种复现类型:
- From-paper:仅提供论文文本,考验 Agent 的补全与推断能力。
- From-artifact:提供部分代码、数据集或预训练模型,测试其整合与调试能力。
- From-artifact interpretation:提供模拟结果,测试 Agent 提取科学结论的逻辑性。
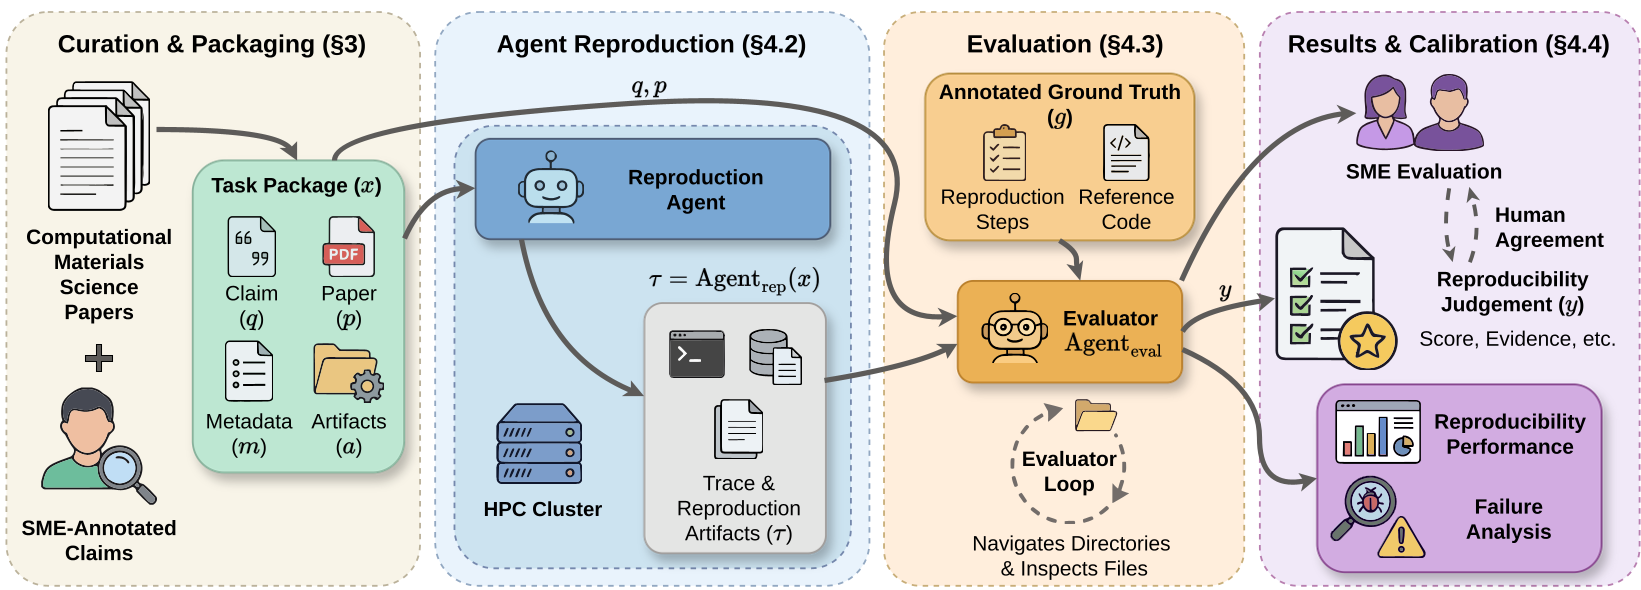 图 1:AUTO MAT 评估流程。Claim(声称)被打包进入 HPC 环境,Agent 自主执行后由 AI 评估员进行多维度打分。
3. 方法论详解:多维度的科学审判
研究者并没有简单地使用“通过/失败”作为指标,而是设计了一个包含五个维度的评分体系(Likert 5分制):
- Methodological Fidelity(方法论忠实度):参数设置是否符合领域标准?
- Execution Competence(执行胜任力):代码是否真的运行成功还是仅仅是“嘴强王者”?
- Result Accuracy(结果准确性):数值偏差是否在科学容差范围内?
- Completeness & Scientific Rigor(完整性与科学严谨性)。
为了确保评估的公正,这套评估系统使用了一个特殊的 LLM Evaluator,并将其与人类专家的评分进行了校准(Kappa 系数 0.69,表现出实质性的一致性)。
4. 实验结果:骨感的现实
实验结果表明,当前的 Agent 表现呈现显著的“分层”现象:
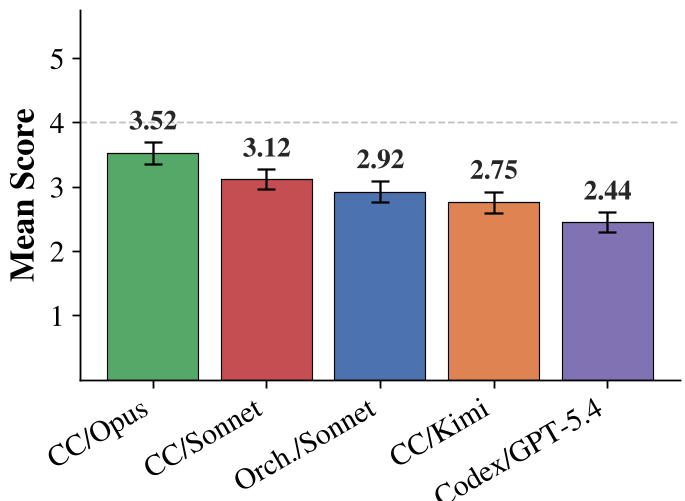 图 2:不同 Agent 系统在 AUTO MAT 上的平均得分。没有任何一个系统能够表现出可靠的科学稳定性。
- 无米之炊最难:对于
From-paper任务,所有 Agent 的平均得分极低(1.5-2.2),几乎全部折戟。这说明 AI 还远未达到仅靠阅读文档就能重建科研实验的程度。 - 长程任务的脆弱性:即使引入了专门的编排器(Orchestrated Agent),在科学严谨性上有所提升,但在总体成功率上并没有显著优于通用 CLI Agent。这揭示了模拟实验的复杂性导致微小的早期错误会随时间大幅扩增。
5. 深度洞察:三种典型的失败范式
论文通过案例研究(Case Studies)精准打击了当前 LLM 的短板:
- Procedural Incompleteness(程序不完整):Agent 往往能识别出缺少某个输入文件,但却无法自主设计出合理的替代方案或 fallback 策略。
- Methodological Deviation(方法论偏离):例如在选择伪势文件时,由于对版本号的固执假设(如 Case Study 2),即便文件就在那里,Agent 也会因为逻辑死循环而报错。
- Evaluation Protocol Drift(评估协议漂移):这是最隐蔽的错误。Agent 可能跑出了和论文一模一样的数字,但却是通过不同的过滤条件凑出来的(Case Study 3),这种“正确的数字,错误的逻辑”在科研中是致命的。
总结与启示
AUTO MAT 的出现为 AI-for-Science 赛道泼了一盆冷水,也指明了方向。未来的科研 Agent 不能仅仅是代码生成的专家,它们必须具备:
- 深层的物理常识:在参数缺失时能自主设定合理的先验值。
- 稳健的环境感知:能应对 HPC 环境中千奇百怪的软件依赖问题。
- 闭环的解释能力:不仅产出数据,还要确保证据链的科学闭环。
局限性:目前基准仅涵盖材料科学,且未包含“不可复现/对抗性”论文的识别测试,这是未来值得探索的研究方向。