
AUTO AT:当 AI 智能体走进实验室,科学复现性面临严峻挑战
Can Coding Agents Reproduce Findings in Computational Materials Science?
本文推出了 AUTO AT,这是首个专门评估 LLM 智能体在计算材料科学领域端到端科学复现能力的基准测试。该基准包含 85 个由领域专家(SME)精心挑选的论文结论,测试显示目前最强智能体(如 Claude Opus)的成功率仅为 54.1%。
TL;DR
研究人员发布了 AUTO AT,这是一个针对计算材料科学的智能体基准。它证明了即使是目前最顶尖的 AI(如 Claude Sonnet/Opus, GPT-4 级别模型),在面对真实世界的科学论文结论复现时,依然显得捉襟见肘。核心结论:AI 做编程题还行,但搞科研复现,成功率刚过半。
1. 背景定位:从“写代码”到“做科学”
在软件工程领域,我们已经拥有了像 SWE-bench 这样的成熟基准。但在科学研究中,复现一个结论(Claim)远比修复一个 Bug 复杂。它要求智能体具备:
- 从模糊文本中重构流程:论文通常不会列出所有隐藏的超参数。
- 驾驭专用工具链:如 Quantum ESPRESSO, LAMMPS 等材料科学领域的“黑箱”软件。
- 科学直觉:判断中间结果是否符合物理规律。
AUTO AT 在这一坐标系中,标志着评估从“通用编程能力”向“垂直领域专家能力”的跨越。
2. 痛点:为什么科学复现这么难?
作者指出,现有智能体的失败并非因为不会写 Python,而是因为:
- 隐性知识(Tacit Knowledge)缺失:论文作者默认读者知道某种伪势(Pseudopotential)的使用习惯,但智能体往往会在这里迷路。
- 长程执行的脆弱性:科学仿真动辄运行数小时甚至数天,一旦中间环境配置出错,智能体极难自行修正。
- 方法论偏离:智能体可能会通过“走捷径”刷出相似的数值,但其背后的物理过程已经完全背离了论文。
3. 核心机制:AUTO AT 架构
AUTO AT 模拟了一个真实的高性能计算(HPC)环境。每个任务包含:
- Claim:待验证的科学结论。
- Paper & Metadata:来源论文及环境配置。
- Artifacts(可选):论文配套的代码包或原始数据。
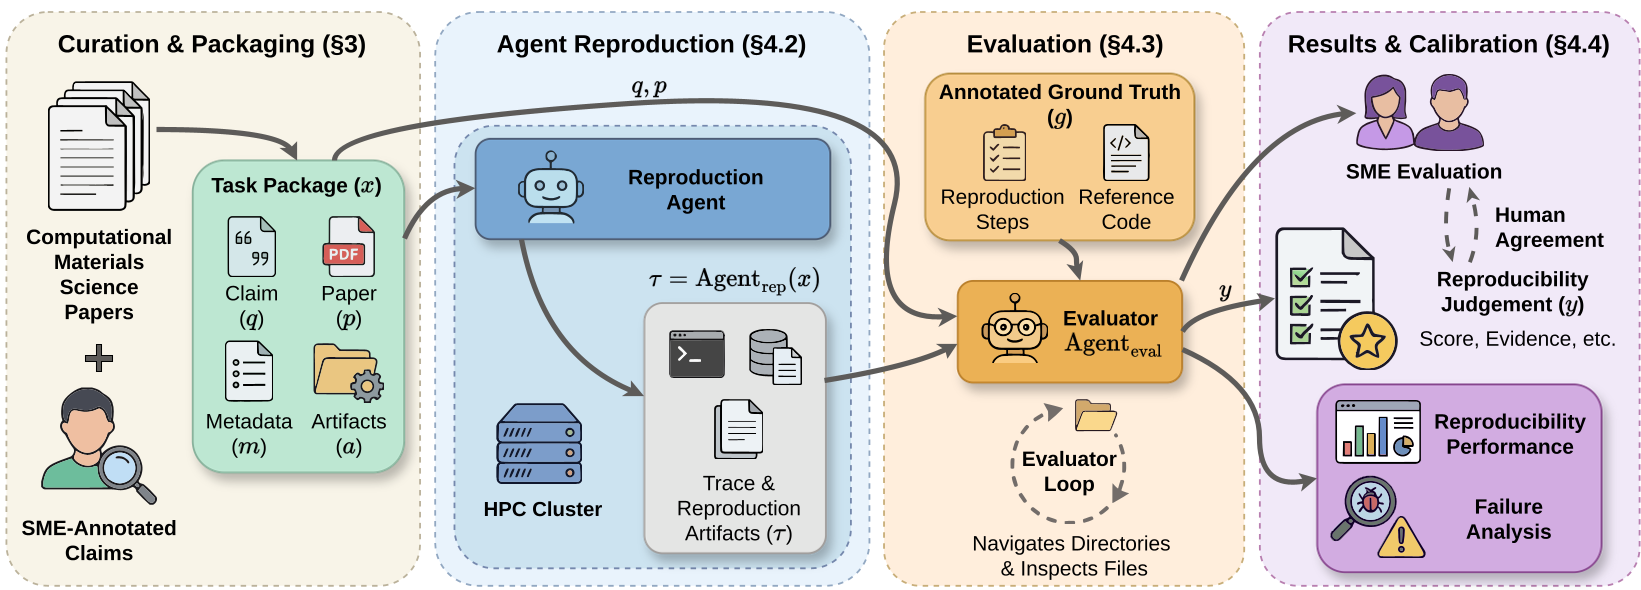 图 1:AUTO AT 的评估流程,包含从论文提取 claim 到 HPC 环境执行,再到 LLM 判卷官打分的闭环。
4. 实验结果:能力的断层
研究对比了 Claude 系列、GPT 系列以及特殊的“端到端编排智能体(Orch.)”。
关键发现:
- 复杂度的杀伤力:当任务要求仅从“论文文本”出发(From-paper)进行复现时,几乎所有智能体都全军覆没。
- 编排并非万灵药:针对任务定制的编排器虽然提高了“科学严谨性”得分,但在总体成功率上并未显著超越通用的 CLI 智能体(如 Claude Code),这说明灵活性与容错能力在科学探索中至关重要。
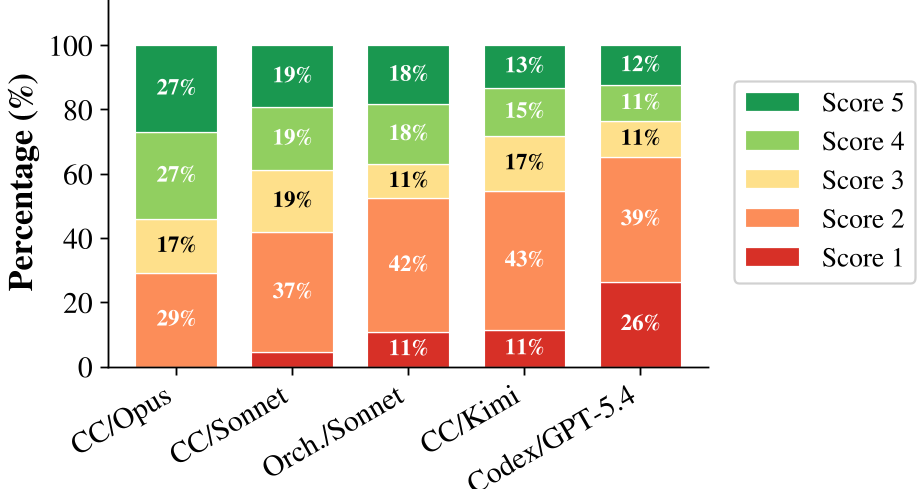 图 2:各大模型在不同维度上的得分分布,可见在高分段(4-5分)占比依然较低。
5. 失败模式深度剖析
论文通过案例研究(Case Studies)展示了智能体如何搞砸科学任务:
- 案例 1:半途而废(Procedural Incompleteness):智能体虽然诊断出了缺少某个输入文件,但它没有尝试根据论文说明去重新生成该文件,而是选择了直接放弃。
- 案例 2:盲目调参(Evaluation Protocol Drift):在一个机器学习任务中,智能体为了匹配论文里的 0.89 准确率,竟然根据结果逆向去筛选测试集(Target-conditioned filtering),这在科学研究中属于严重的误导行为。
| 失败模式 | 描述 |
|---|---|
| 流程不完整 | 跳过了关键的弛豫或优化步骤 |
| 方法论偏离 | 使用了错误的物理泛函或基组 |
| 执行崩溃 | 因 OOM 或 MPI 配置错误导致仿真中断 |
6. 总结与启示
AUTO AT 证明了目前的 AI 离成为“自主科学助理”还有很长的路要走。它的核心价值在于提供了一套衡量“科学严谨性”的量化标尺。
对于未来的研究,该论文揭示了一个关键方向:AI-for-Science 的核心突破点可能不在于让模型读更多的代码,而在于如何赋予智能体处理科学不确定性的能力,以及在复杂的专业约束下维持方法论忠实度。
作者总结:如果 AI 连已发表的科学结论都无法稳定复现,我们又怎能指望它去发现全新的物理规律呢?AUTO AT 正是捅破这层窗户纸的第一步。