
CoLT:让 AI 学会“默念”——多模态模型的高效潜思维推理
CoLT: Teaching Multi-Modal Models to Think with Chain of Latent Thoughts
本文提出了 CoLT (Chain of Latent Thoughts),一种教多模态大模型(MLLM)在连续潜空间中进行推理的新型框架。该方法通过 3 个潜向量(Latent Thoughts)替代冗长的文本推理链,在 8 个多模态基准测试中超越了现有 SOTA。
TL;DR
在追求模型“深度思考”的时代,DeepSeek-R1 等长文本 CoT 模型虽然强大,却面临着严重的推理成本问题。本文介绍的 CoLT (Chain of Latent Thoughts) 另辟蹊径:它让多模态模型不再通过冗长的文字“自言自语”,而是通过 3 个高浓缩的潜向量(Latent Thoughts)完成逻辑推演。结果不仅在推理速度上实现了 22.6 倍 的飞跃,准确率甚至反超了文本 CoT。
痛点深挖:文字推理的“效率陷阱”
目前的 Chain-of-Thought (CoT) 范式存在三个天然缺陷:
- 慢:生成数千个 token 极其耗时,是推理的主要负载。
- 僵化:一旦某个中间步骤被解码为具体的词汇,其丰富的语义分布就会塌缩,增加容错成本。
- 误差累积:前文的一点笔误可能导致后续推理全盘皆错。
虽然已有一些“隐式推理”的研究,但它们在多模态场景下往往需要昂贵的辅助图片标注,或者因为缺乏约束导致生成的潜向量完全是“乱码”,训练极其不稳定。
核心逻辑:CoLT 的三维监督机制
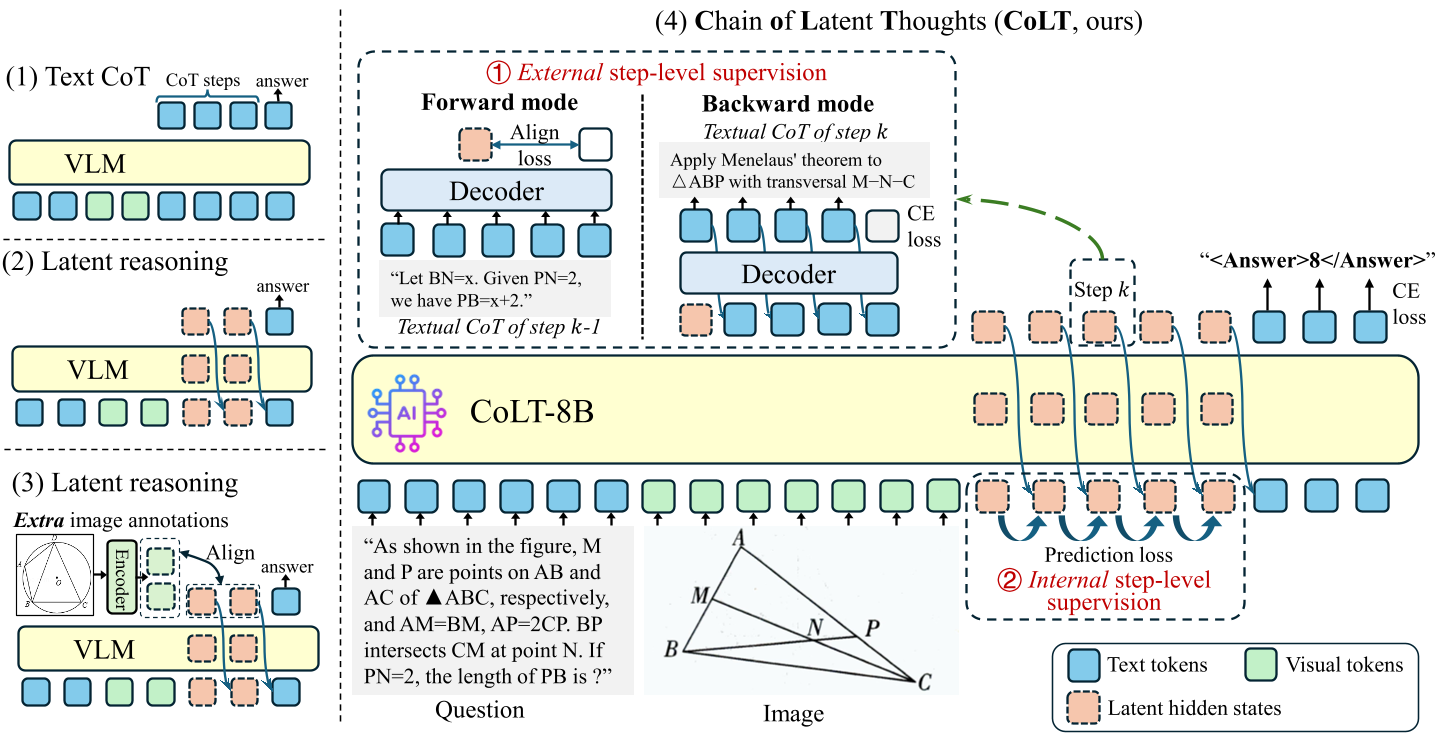
CoLT 的核心直觉在于:既然不想写出文字,那就得保证模型在心里想的东西“有据可依”。 为了约束这 3 个潜向量,作者设计了一个精妙的监督网络(仅在训练时存在):
1. 架构解析 (Methodology)
CoLT 并没有在词表中增加新 token,而是直接提取 Transformer 最后一层的隐藏状态。其训练受三个信号共同控制:
- Forward Decoding (前向监督):强制当前的潜向量必须能被解码出下一阶段的推理文本。
- Backward Decoding (后向对齐):将已有的文本推理步骤反向映射回潜空间,要求潜向量与其对齐,锚定语义中心。
- Internal Consistency (内部连贯):通过一个轻量级 MLP 预测下一跳的思维状态,模拟逻辑推进。
实验与结果:快且稳
在实验中,CoLT 展现出了惊人的效率和不俗的跨领域能力。
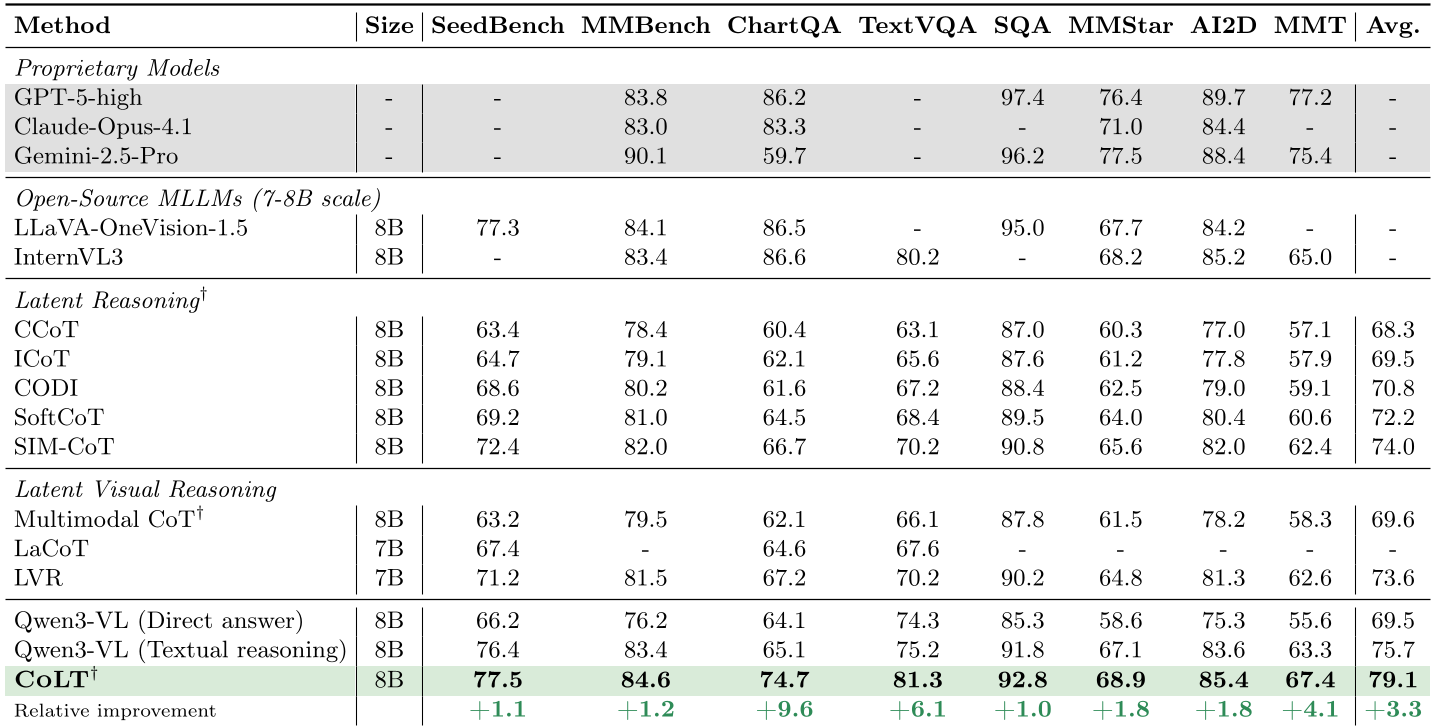
- 性能反超:在 SeedBench, MMBench 等 8 个主流测试集中,CoLT 不仅秒杀了之前的潜推理方法(如 SIM-CoT),平均分甚至比传统的“文本 CoT”高出 3.4%。在更加复杂的 ChartQA(图表问答)上,提升更是高达 9.6%。
- 极致效率:文本 CoT 平均需要 140+ 个 token 来“思考”,而 CoLT 仅需 3 个。这直接带来了 10 倍以上 的端到端推理提速。
鲁棒性分析
有趣的是,CoLT 在输入噪声(如模糊图像、输入拼写错误)的情况下表现得比文本 CoT 稳健得多。这是因为潜向量是连续的分布,而文本是离散的,连续空间对扰动有更好的防御性,避免了“一步错步步错”的连锁反应。
深度洞察:为什么 3 个步骤就够了?
论文消融实验显示,并非思维步数越多越好。当 时效果最佳。这暗示了在连续的高维空间中,信息的密度远超自然语言。一个 4096 维的向量可能包含了数十个自然语言单词才能承载的信息量。
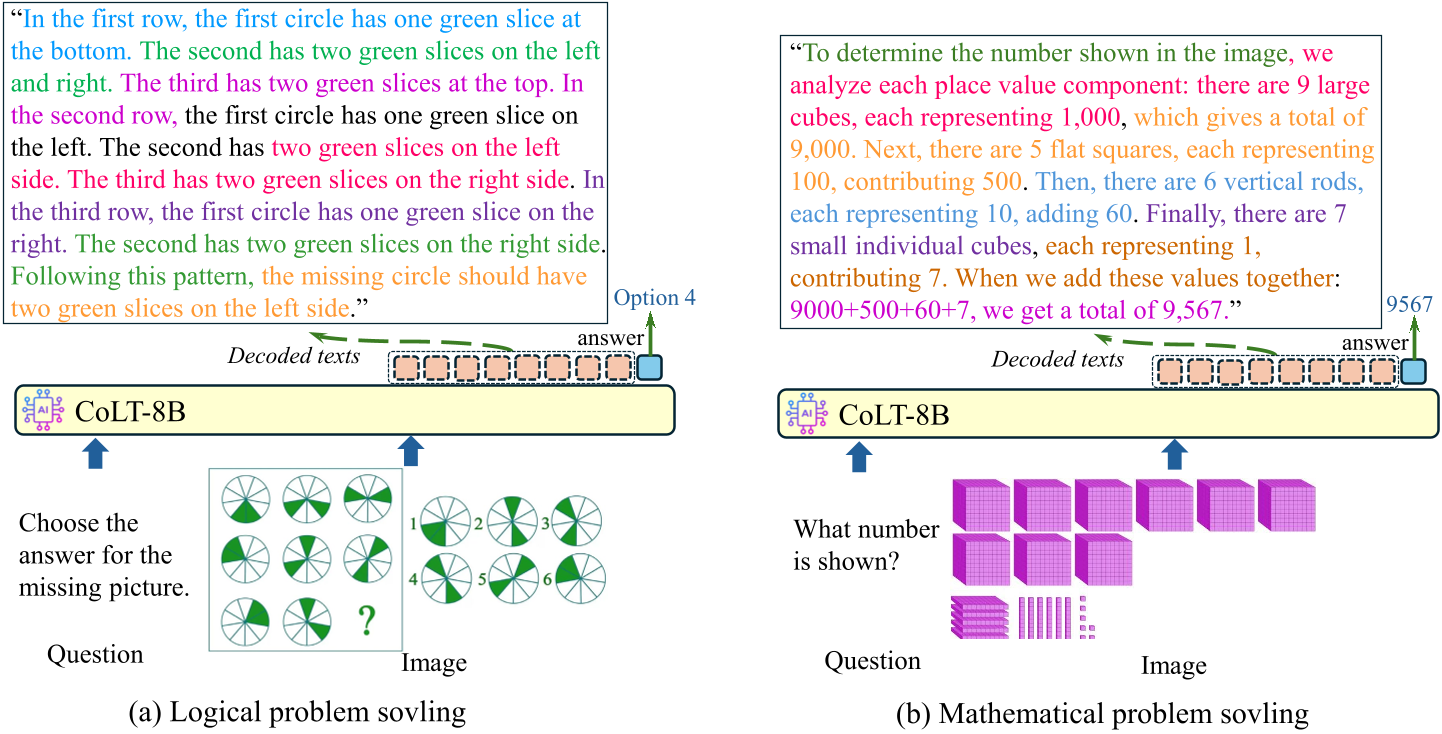 上图显示,通过外部解码器还原出的潜思维确实包含了分步骤的逻辑推导(如 row-by-row 扫描图表)。
总结与展望
CoLT 成功证明了 “隐式思维” 在多模态推理中的巨大潜力。它去除了繁琐的文本解码开销,但在训练时保留了文本的语义引导。
局限性:目前 CoLT 的步数(K)是固定的。未来的方向应该是“自适应思考”,即对于简单问题,模型“一闪念”即可(K=1),而对于高考数学题,则需要进行深度潜思考(K=10+)。
这种“在潜空间中思考”的能力,或许是通往高效嵌入式 AI 和实时交互式智能的关键钥匙。