
共同方法偏差的机制与补救:Podsakoff 综述如何把问卷研究从统计修补转向设计决策
Common method biases in behavioral research: A critical review of the literature and recommended remedies.
本文是对行为科学研究中共同方法偏差的系统综述,研究对象是同一测量来源、题项形式、题项情境和测量情境造成的系统性测量误差。作者梳理了偏差来源、认知响应机制、程序控制和统计控制方法,并给出按研究情境选择补救策略的决策框架。论文的核心证据显示,典型测量的共同方法方差约 26.3%,未控制共同方法方差时平均解释方差约 35%,控制后约 11%。
核心速览
本文研究对象是行为科学中的 common method variance,即由测量方法本身而非构念造成的系统性方差。作者 Podsakoff、MacKenzie、Lee 和 Podsakoff 并未提出一个新算法,而是把分散在 multitrait-multimethod、confirmatory factor analysis、Harman 单因素检验、标记变量法、社会称许性控制和负向情绪性控制中的知识整合成一套偏差来源分类、认知过程映射和情境化控制策略框架。其最重要的结论是:共同方法偏差既能人为夸大也能人为压低构念间关系,研究者和评审者不能只依赖一个统计检验,而应根据变量来源、测量情境、偏差可识别性和偏差可测量性选择程序控制与统计控制的组合。
从学术坐标看,这篇工作的价值不在刷新某个效应量,而在建立一个长期可用的“方法偏差治理体系”。它把共同方法问题从“有没有通过 Harman 测试”推进到“偏差在哪个响应阶段发生、哪种统计模型能在项目层面建模、哪种情境只能靠研究设计预防”。这使它成为后续问卷研究、实验中介分析、组织行为测量和数字调查设计中反复引用的框架性文献。
问题与动机
行为研究大量依赖自我报告,而自我报告的危险并不只是随机噪声,而是系统性偏差。论文指出,如果构念 A 和构念 B 的测量共享同一方法,例如同一评价者、同一时间、同一问卷情境、同一量表格式,那么观察到的 A 与 B 相关就至少部分可能来自方法本身。这种系统性误差会提供一条替代解释:变量相关并非理论关系,而是方法协变。更严重的是,这种误差方向不固定,既可以造成 Type I error,把原本无关的构念推成相关,也可以造成 Type II error,把真实关系压低。
论文用期刊综述数据说明问题不是边缘现象。正文引用 Sackett 和 Larson 对三个期刊 1977、1982 和 1987 年研究的回顾发现,51% 的研究使用自我报告作为主要或唯一数据,39% 的研究全部数据来自同一测量情境。由于常见研究设计恰好满足“同一来源、同一情境、相似题项”的条件,共同方法方差容易成为研究结果的重要替代解释。现有文献虽然长期讨论该方法问题,但论文认为缺少一个同时覆盖偏差量级、来源、认知机制和控制技术的综合框架,这正是它写作动机所在。
核心章节:从偏差量级到机制分类,再到控制策略匹配
一、偏差量级:共同方法方差如何通过测量误差改写观察相关
论文把共同方法偏差的后果首先形式化为真实构念相关如何被测量结构改写。其出发点是 Cote 和 Buckley 的 multitrait-multimethod 估计,以及一个用于计算观察相关的公式:
其中 是两个观察测量 和 之间的相关, 和 分别是两个测量中来自真实构念的方差比例, 和 是方法方差比例, 是构念层面真实相关, 是方法间真实相关。这个式子在论文中的作用是把观察相关拆成构念协变和方法协变两部分:第一项说明真实构念相关只有部分能穿过测量误差被观察到,第二项说明即使真实构念相关为零,只要测量方法彼此相关,观察相关也会不为零。若令 且 ,方法项消失,式子退化为只受构念方差影响的测量衰减;若 但方法相关非零,观察相关仍会出现,这正是论文强调的“替代解释”。论文同时提醒,Table 1 的计算忽略 Trait 与 Method 的交互,因此它刻画的是加性假设下的偏差量级,而不是所有可能机制。
论文基于 Cote 和 Buckley 的 70 项 multitrait-multimethod 研究估计,典型研究测量中约 26.3% 的方差可能来自共同方法偏差,且不同领域差异明显:营销最低约 15.8%,教育最高约 30.5%;态度构念方法方差约 40.7%,工作绩效与满意约 22.5%。Table 1 进一步展示观察相关如何偏离真实相关:
| 构念配对 | 真实相关 1.00 | 真实相关 0.50 | 真实相关 0.00 |
|---|---|---|---|
| 态度 与 态度 | 0.52 | 0.38 | 0.23 |
| 态度 与 人格 | 0.52 | 0.35 | 0.17 |
| 能力 与 能力 | 0.54 | 0.34 | 0.14 |
| 工作绩效与满意 与 工作绩效与满意 | 0.54 | 0.31 | 0.07 |
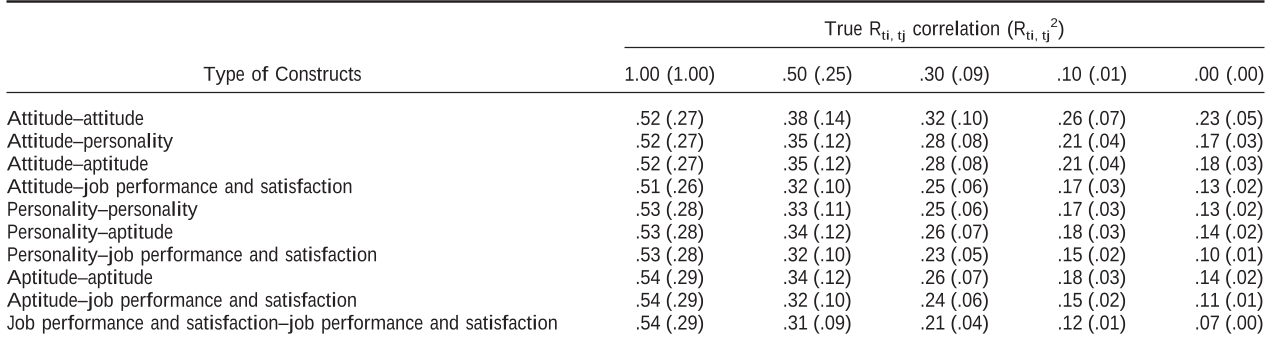
这张表的两个极端值特别值得追问。第一列说明即使两个态度构念真实相关为 1.00,观察相关也只有 0.52,真实关系被测量误差压低;最后一列说明即使两个态度构念真实相关为 0.00,观察相关也可达到 0.23,方法相关制造了虚假联系。论文据此指出,方法效应何时膨胀、何时压低,取决于方法间相关与去掉方法效应后构念间相关的相对大小:当方法间相关高于后者时,观察关系被膨胀;当方法间相关低于后者时,观察关系被压低。这个判断比“共同方法方差总是夸大相关”的粗糙直觉更准确,也解释了为什么 marker variable 方法只假设膨胀会失效。
二、来源与机制:四类方法效应如何嵌入回答问卷的认知过程
论文的第二块重心是把偏差来源从笼统的“self-report bias”拆成四类:共同来源或评价者效应、题项特征效应、题项情境效应、测量情境效应。共同来源效应包括一致性动机、隐含理论和虚假相关、社会称许性、宽大偏差、默许偏差、正负情绪倾向和短暂情绪状态。题项特征效应包括题项社会称许性、题项模糊性、共同量表格式、共同锚点、反向计分题。题项情境效应包括题项启动、题项嵌入性、情境诱发情绪、量表长度和构念间混排。测量情境效应包括同时间、同地点、同媒介。这样的分类使方法偏差不再只是统计模型里的“共同因子”,而是一组可操作的研究设计风险。
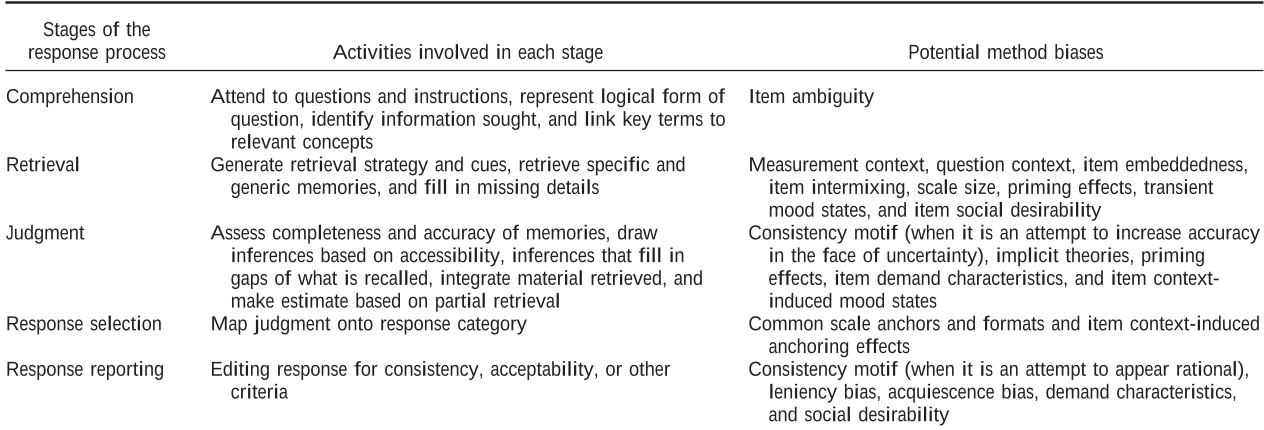
作者进一步把这些来源映射到回答过程的五个阶段:理解、提取、判断、选择响应、报告响应。Table 3 显示,题项模糊性主要发生在理解阶段;共同测量情境、题项情境、题项嵌入、题项混排、量表长度、启动效应、短暂情绪和题项社会称许性主要影响提取;一致性动机、隐含理论、题项需求特征、情境诱发情绪主要影响判断;共同锚点和格式主要影响选择响应;社会称许性、宽大偏差、默许偏差和一致性动机又出现在报告阶段的自我编辑。这个映射的重要性在于:不同偏差发生在不同认知环节,因此不同控制方法只能解决局部问题。例如,改变量表锚点可以减少响应选择阶段的一致性偏置,却难以消除提取阶段因共同情境线索导致的记忆检索偏置;匿名化可以减少社会称许性和评价焦虑,却难以消除隐含理论对判断的污染。
论文还用具体研究说明这些机制不是抽象修辞。关于宽大偏差,Schriesheim 等人的研究发现它会在领导体贴行为与员工满意度、群体生产力和凝聚力感知之间造成虚假相关,但在领导定规行为与相同效标之间不明显,说明偏差与题项评价效价有关。关于情绪倾向,Brief 等人报告负向情绪性会放大工作压力与不满意、抑郁等变量之间的关系,Williams 和 Anderson 则发现加入正向情绪性后结构方程模型拟合更好;但 Chen 和 Spector、Jex 和 Spector 又未发现稳定支持。这些相互不一致的发现共同说明:偏差大小和方向高度依赖研究情境、构念类型和测量方式,不能用单一统计检验一刀切。
三、控制策略:程序预防、统计补救和情境匹配
论文的核心贡献之一是把控制手段分为程序 remedies 和统计 remedies,并给出适用边界。程序控制的关键是切断预测变量与效标变量之间的共享方法连接。不同来源测量可以消除评价者一致性动机、隐含理论、社会称许、情绪和默许等同一心智造成的偏置;时间、地点、心理或方法分离可以减少共同提取线索和响应编辑;匿名化和降低评价焦虑可以减少社会称许性;平衡题项顺序可以缓解启动和题项嵌入;改进题项、减少模糊性、改变量表格式和锚点可以减少理解与响应选择阶段的偏差。论文同时强调这些方法有代价:多源数据需要身份匹配,可能损害匿名性;时间滞后如果与理论过程不匹配,会掩盖真实关系;改变量表锚点可能改变构念含义,牺牲效度来降低方法方差。
统计控制则被论文按能力差异排列。Harman 单因素检验最常见,但论文批评它本质上只是诊断,不能部分去除方法效应,也没有统一阈值;变量越多,越可能出现多个因子,因此该测试随变量数增加反而不保守。偏相关方法包括控制社会称许性、负向或正向情绪性、marker variable、一般因子得分。Marker variable 的优点是易于实施,但缺点很强:它无法控制隐含理论和一致性动机等最有力偏差来源,因为这些心理机制与无关标记变量的相关未必同构;它通常假设方法因子对所有变量影响相同,假设方法方差只会膨胀不会压低相关,并忽略测量误差。一般因子偏相关同样可能把真实构念协变一起偏去。
论文更看重 latent variable 方法,因为它们能在测量层面而非构念层面建模方法效应,并能估计测量误差。直接测量方法因子适用于已知偏差源且有有效量表的场景,例如社会称许性;未测量共同方法因子适合无法事先识别偏差源的场景,但不能说明偏差原因,且在指标较少时可能欠识别。multitrait-multimethod 和多个具体方法因子能同时处理多种来源,识别条件更苛刻;correlated uniqueness 更易收敛,但方法效应被约束为正交,且 trait 方差估计可能偏倚;direct product 可以处理 trait 与 method 的乘积交互,但论文不推荐广泛使用,因为 trait 与 method 交互的概念机制尚不清楚,已有证据显示它们通常不强。
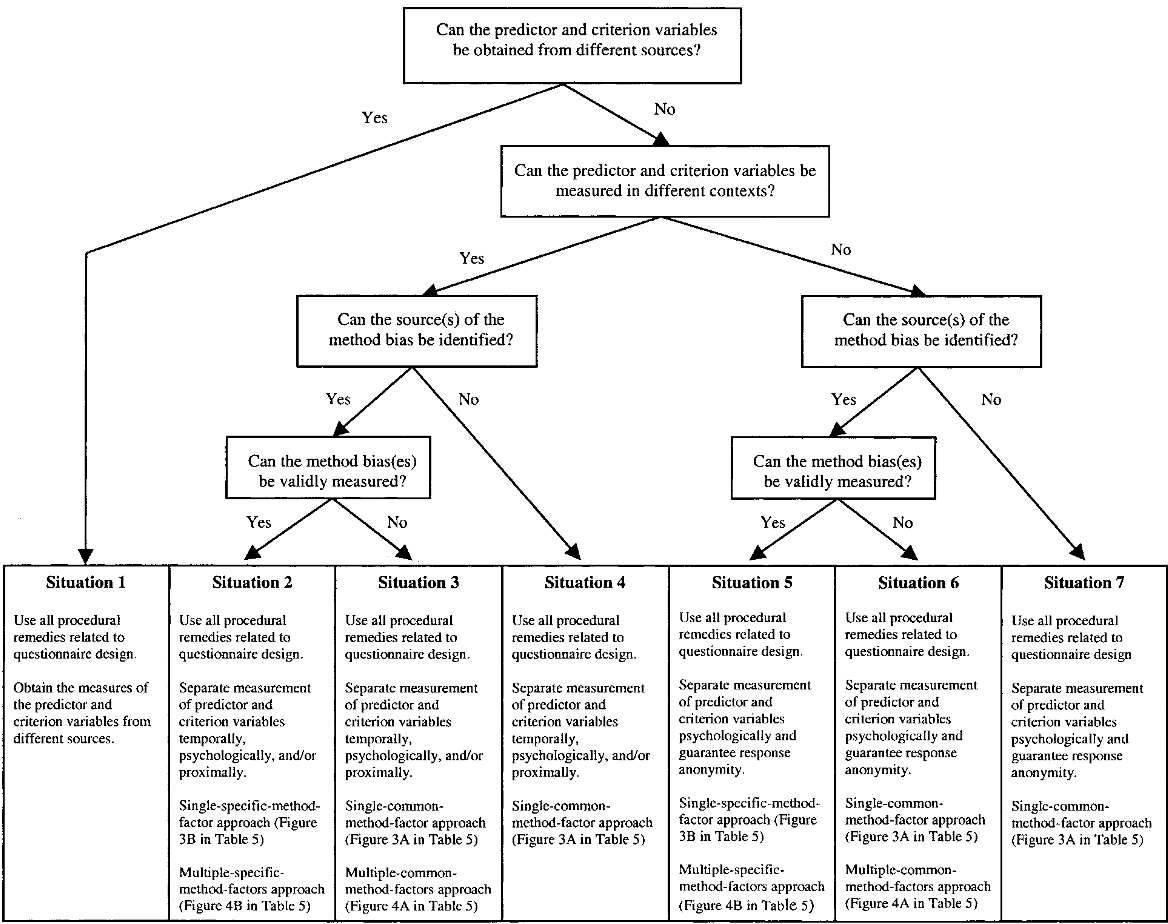
Table 5 和 Figure 1 的组合构成真正可操作的方法:先问四个问题,能否用不同来源,能否用不同情境,能否识别偏差源,能否有效测量偏差源。能换来源就优先换来源;同源但能换情境,就用时间、地点、心理或方法分离,并配合具体方法因子;不能换情境但能识别并测量偏差源,就用直接测量 latent method factor;不能识别偏差源,就用未测量共同方法因子或更复杂的多方法因子。论文还特别提醒实验中介分析和 formative 指标。实验研究虽然操纵自变量,但中介变量与因变量仍可能同源同时间测量;formative 构念的方法偏差不应只在项目层面建模,而应上升到构念层面,但这类模型可能识别不足,因此程序控制更关键。
实验与证据
这篇论文本身是综述和框架性分析,不提出新的主实验。它的证据基础主要来自三类文献:meta-analytic multitrait-multimethod 估计、控制与未控制共同方法方差的关系比较、以及具体偏差机制的实证研究。论文引用的核心数字如下:
| 证据类型 | 数值 | 含义 |
|---|---|---|
| 典型测量的共同方法方差 | 26.3% | Cote 和 Buckley 跨 70 项 multitrait-multimethod 研究的平均估计 |
| 营销领域方法方差 | 15.8% | 不同领域差异的下限 |
| 教育领域方法方差 | 30.5% | 不同领域差异的上限 |
| 态度构念方法方差 | 40.7% | 态度类测量中方法方差高 |
| 工作绩效与满意方法方差 | 22.5% | 绩效与满意类测量的平均方法方差 |
| 未控制共同方法方差时解释方差 | 约 35% | 多项比较研究控制前后结果差异 |
| 控制共同方法方差后解释方差 | 约 11% | 方法方差被处理后关系显著下降 |
| 真实相关 1.00 时观察相关 | 0.52 | Table 1 中态度 与 态度构念配对 |
| 真实相关 0.00 时观察相关 | 0.23 | Table 1 中态度 与 态度构念配对 |
| 使用自我报告的研究比例 | 51% | Sackett 和 Larson 对三个期刊研究的回顾 |
| 全数据来自同一测量情境的研究比例 | 39% | Sackett 和 Larson 对三个期刊研究的回顾 |
这些数字说明论文结论不是纯修辞。Cote 和 Buckley 的 meta-analytic 估计提供偏差量的平均水位;Table 1 把偏差量转化为真实相关到观察相关的映射;控制前后解释方差比较显示共同方法方差可以显著改变效应量;期刊综述显示高风险设计在实践中非常普遍。论文也承认偏差幅度会随情境变化,并指出方法效应方向可为正也可为负,因此单一阈值检验无法承担“方法偏差不存在”的证明责任。
证据质量需要分层评价。较强的部分是来源分类和响应过程映射:它建立在大量测量理论、问卷方法学和社会认知文献上,逻辑自洽且可操作。较弱的部分是控制策略比较:论文主要根据已有文献和模型假设进行判断,没有自己运行大规模模拟或实证实验来证明某个统计方法在特定样本量、因子结构和缺失程度下的优劣。例如,论文指出 multitrait-multimethod 模型可能欠识别、correlated uniqueness 更容易收敛、direct product 交互通常不强,但这些判断更多来自引用文献,而非同一数据集上的系统 benchmark。另一个证据缺口是 Table 1 明确忽略 trait 与 method 交互,而论文后续又承认交互可能使简单加性模型不完整,这使偏差量级的精确外推存在限制。
深度洞察与总结
这篇工作的真正贡献是把共同方法偏差从“统计检查清单”改造成“研究设计诊断系统”。它最重要的洞见有三点。第一,方法偏差不是单一潜在因子,而是一组发生在理解、提取、判断、响应选择、报告等环节的认知与设计产物;因此不同控制手段只覆盖不同机制。第二,Harman 单因素检验、marker variable 等常用做法之所以长期流行,是因为它们操作成本低,但论文清楚说明它们容易误把诊断当控制,把局部代理当全部方法方差。第三,最可靠的补救顺序是预防优先、统计次之;当程序控制不可行时,才根据偏差能否识别、能否有效测量来选择 latent factor、specific method factor 或 common method factor。
局限性也很具体。首先,论文没有提出一个可直接计算统一偏差指数的方法,也没有提供基于新数据的模拟实验来比较各统计策略的样本量边界和模型选择误差。其次,它把统计模型放在 confirmatory factor analysis 框架内讨论,对 item response theory、贝叶斯潜变量模型或机器学习式题项响应过程建模没有展开;这些现代工具在在线平台和大规模问卷中可能更有用。再次,对于 formative 构念,论文指出构念层面建模可能识别不足,但没有给出可操作的替代估计策略,只能强调程序控制。最后,论文引用的领域和构念估计主要来自传统组织行为、营销、教育和心理测量语境,是否能直接迁移到数字痕迹数据、行为日志、平台评分和大语言模型自动生成量表,需要进一步验证。
未来研究最值得推进的方向不是继续增加共同方法因子,而是把设计、测量和统计连成可检验的因果链条。具体而言,可以用生成模型模拟不同题项顺序、锚点格式、启动效应和评价者一致性下的项目响应矩阵,比较 marker variable、single common method factor、multiple specific method factor、direct product 在膨胀和压低真实相关时的偏差;在平台问卷研究中做 randomized item context 实验,检验题项嵌入和情境诱发情绪是否如 Table 3 所示改变提取与判断;在 formative 构念中研究跨指标与跨构念识别策略,使构念层面方法误差能够被稳健估计。Podsakoff 等的这篇综述提供的不是终点答案,而是一张把行为科学测量误差拉回研究设计中心的路线图。