
药物活性预测新视角:分子指纹的“各司其职”与融合之道
Comparative analysis of molecular fingerpirnts toward improvement of drug activity prediction
本文针对药物活性预测中的化合物表征问题,对常用的 8 种分子指纹(如 ECFP, MACCS, 2DPF 等)进行了系统性的比较分析。研究发现,虽然不同指纹的预测性能(AUC)差异较小,但它们捕捉到的分子特征具有显著的互补性,通过组合多种指纹可以有效提升模型精度。
TL;DR
在 AI 驱动的主动创药领域,如何将复杂的化学分子转化为计算机可理解的向量(Fingerprints)是模型成功的关键。本文通过对多种主流分子指纹的深度对比发现:没有最好的指纹,只有最互补的组合。研究证明,不同算法生成的分子指纹在化学空间中捕捉到的信息具有极强的正交性,通过合理的组合(Concatenation),预测性能(AUC)可获得显著提升。
痛点深挖:为何 SOTA 指纹也有天花板?
在基于配体的高通量虚拟筛选(LBVS)中,我们习惯于追求像 ECFP4 这种公认的表现优异的指纹。然而,实际研究中经常发现,针对某些特定靶点,老旧的 MACCS key 甚至物理化学描述符的表现反而更好。
作者的核心直觉(Insight)是: 既然每种指纹的生成逻辑不同(有的基于字典结构,有的基于路径拓扑,有的基于药效团),那么它们必然在过滤分子的过程中产生了“信息盲区”。如果这些盲区是互补的,那么“多机融合”理论上就能突破单一指纹的性能天花板。
方法论详解:拆解特征空间的神秘面纱
1. 相似度量:不仅仅是相关系数
作者通过计算不同指纹在相同化合物集合上的 Tanimoto 系数,并转化为 Spearman 秩相关,来定义指纹间的“亲疏关系”。结果令人惊讶:除了同族的 ECFP4 和 ECFP6 外,大多数指纹间的相关性极低。
2. t-SNE 降维:视觉化捕捉差异
为了直观展示这种差异,作者引入了 t-SNE (t-distributed Stochastic Neighbor Embedding)。
 上图展示了不同指纹在二维空间中的分布。我们可以清晰地看到,Daylight 指纹(红色)与 ECFP 系(蓝色/绿色)几乎占据了完全不同的流行流形(Manifold)区域,这有力地证明了它们捕捉的是分子的不同物理化学属性。
3. 特征重要度筛选
为了排除噪声干扰,作者利用 RandomForest 的 Gini 系数(Gini Importance) 提取了每个指纹中最关键的位点。实验发现,即便只保留最关键的特征,指纹间的相关性依然没有显著提高,这说明指纹间的“分歧”源自本质的表征逻辑,而非随机噪声。
实验与结果:1 + 1 > 2 的验证
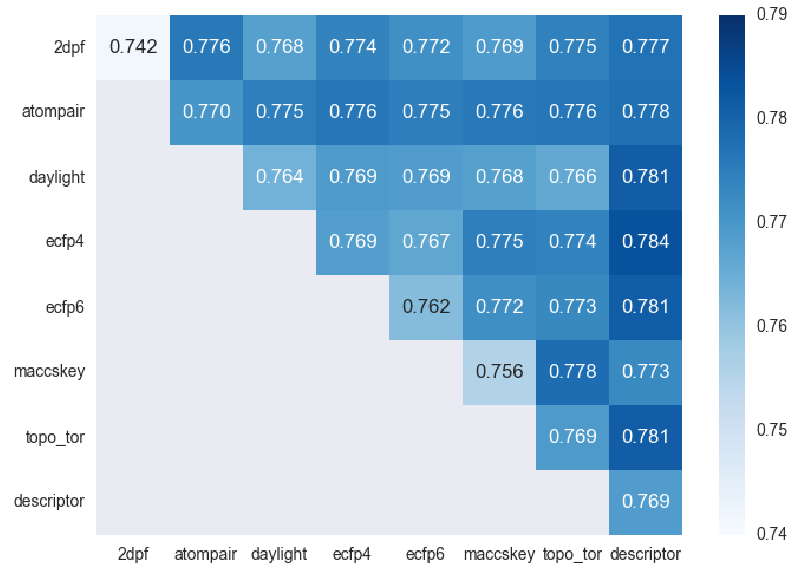
作者在 PubChem 的多个靶点数据集(如 AID1915, AID504607)上对比了单指纹与双指纹拼接的效果。
 实验关键发现:指纹间的相似度与 AUC 的增益呈明显的负相关(Pearson Correlation: -0.595)。这意味着两个指纹越不相似,它们组合后的潜力就越大。
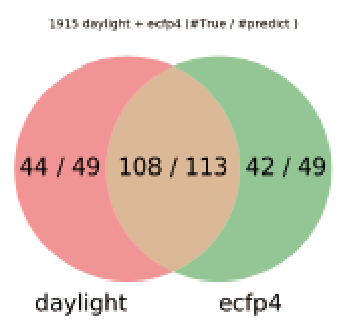
预测结果的“多样性”: 通过对预测分数 Top 20% 的化合物进行维恩图(Venn Diagram)分析,作者发现不同指纹锁定的高潜力化合物并不重合。这种预测结果的低重合度提示我们,在虚拟筛选中,使用多模型/多特征并行筛选,能极大提高发现新型活性分子的概率。
深度洞察与总结
核心价值 (Takeaway)
本文虽然没有提出一种全新的算法架构,但它在模型的可解释性与特征工程策略上给出了非常务实的建议。它打破了“追求单一完美表征”的迷思。
局限性 (Limitations)
- 维度灾难 (Curse of Dimensionality):虽然拼接指纹提升了性能,但特征规模翻倍会增加计算开销,且在小样本数据集上容易导致过拟合。
- 黑盒融合:简单的特征拼接(Concatenation)属于“浅层融合”,未来可以探索基于 Attention 机制的深度融合。
未来展望
对于工业界的研究员来说,这项研究意味着:与其纠结使用 ECFP4 还是 ECFP6,不如尝试将 拓扑信息(Atom Pair) 与 属性描述符(Chemical Descriptors) 进行集成。下一步的研究方向应该是如何通过 Autoencoder 或更高级的 Embedding 技术,在保留这种互补性的同时实现特征降维。