
Composer:自动化探索混合 LLM 架构,让 Llama 3.2 成为过去式
Composer: A Search Framework for Hybrid Neural Architecture Design
本文提出了 Composer,这是一个自动化的混合神经网络架构搜索(HNAS)框架,旨在发现超越传统 Transformer 结构的混合大语言模型。通过在小尺度(百万参数级)进行搜索并利用 Stretch 和 Stack 策略进行千倍比例外推,该框架发现了 Composite 系列架构,在 350M 到 8B 规模上性能均优于 Llama 3.2。
TL;DR
Meta(FAIR)的研究团队近日发布了 Composer 框架,首次系统性地解决了“如何自动设计混合 LLM 架构”的问题。通过该框架发现的 Composite 架构放弃了 Transformer 传统的 Attention 与 MLP 1:1 交替的陈旧套路,转而采用一种更高效的 1:2 混合比例。实验证明,该架构在性能上全面超越 Llama 3.2 的同时,推理速度提升了 33%,缓存占用减少了约 40%。
1. 痛点:Transformer 结构是唯一的真理吗?
长期以来,Transformer 架构(Attention 接 MLP)被视为 LLM 的金科玉律。虽然近期出现了 Mamba-2 或 Jamba 等工作尝试引入外部算子,但这些尝试大多基于“专家直觉”手动调整。
面对动辄 32 层、甚至 72 层的深度,组合爆炸使得人工设计变得力不从心。最难的一点在于:“不仅比例重要,交替的模式也重要”。如果简单的 1:1 不是最优,那么 2 个 Attention 接 4 个 MLP 是否更好?这些问题在以往缺乏系统性的解答工具。
2. 核心机理:Transformer 的“缩骨功”与“倍化术”
Composer 的核心贡献在于建立了一套从“微观搜索”到“宏观外推”的科学流程。
A. 搜索引擎 (HNAS Engine)
为了避免在几亿种组合中迷失,Composer 采用了One-Shot Search(利用贝叶斯优化)以及增量搜索,重点在于寻找 Attention 算子与 MLP 算子的排列组合。
B. 评估与外推 (Evaluator & Extrapolator)
这是本文最具学术洞察力的部分。作者发现直接按照 Chinchilla Scaling Law 缩减 web 数据集并不奏效。相反,使用 MAD (Synthetic token-manipulation tasks) 这种合成任务数据集能提供更纯净的性能信号。
在获得 6 层或 16 层的最优微缩模型后,Composer 提出了两种外推策略:
- Stacking (堆叠):将搜索到的小块像积木一样叠起来。
- Stretching (拉伸):保持比例和序位,等比例增加每一组算子的厚度。
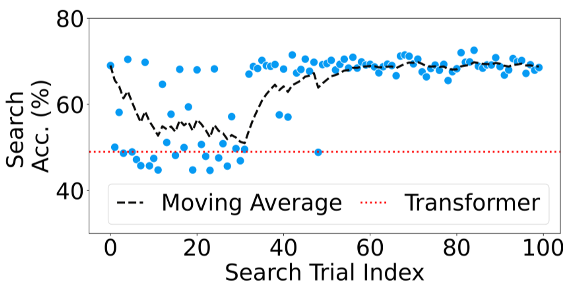 图 1:Composer 的端到端流程:从百万级参数搜索到十亿级参数模型部署
3. 实验战绩:全方位的降维打击
通过实验发现,最好的架构配置通常呈现出 1:2 的 Attention-to-MLP 比例。
性能与效率:
- 验证损失 (Validation Loss):在 350M 至 8B 所有尺度上,Composite 模型均显著低于 Llama 3.2。
- 吞吐量与延迟:得益于计算密集度更高的 MLP 取代了昂贵的 Attention 层,训练速度提升 1.25x。在推理端,KV Cache 的减小意味着能处理更长、更复杂的任务。
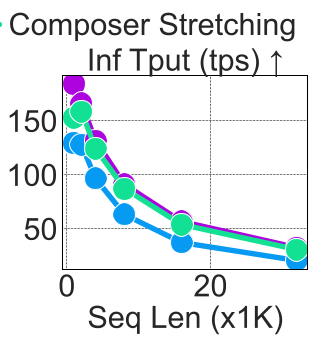 图 2:不同规模下的验证损失对比,Composite 模型展现出极强的鲁棒性
下游任务表现:
在 ARC, HellaSwag, PIQA 等经典榜单上,Composite 架构在固定 FLOPs 预算下平均提升了 2% 以上 的准确率。
4. 深度洞察:为什么 1:2 更好?
作者通过消融实验给出了直觉解释:
- Contextual First:高表现模型往往以若干层 Attention 开头,用于深层上下文建模。
- MLP Refinement:末端增加 MLP 比例能更有效地进行特征提炼与投影。
- Inductive Bias:传统的 1:1 比例可能存在过度关注(Over-attending),多出的 MLP 层提供了非线性转换能力,而减轻了计算瓶颈。
5. 总结与展望
Composer 证明了神经网络架构搜索(NAS)在大模型时代依然大有可为。它不仅发现了一组比标准 Transformer 更好的静态比例,更提供了一个可扩展的框架。未来,我们可以将 Mamba, RWKV 甚至卷积层作为 Primitives 丢进 Composer,让它自动进化出更加极致的混合架构。
局限性:目前搜索任务主要集中在自然语言理解,对于长文本推理和复杂数学任务的适应性仍需进一步验证。
Takeaway:未来的 LLM 赛道,架构设计将从“玄学”走向“搜索自动化”。