
DPO 全景综述:从 RLHF 的“平替”到对齐算法的标准答案
A Comprehensive Survey of Direct Preference Optimization: Datasets, Theories, Variants, and Applications
本文是关于直接偏好优化(Direct Preference Optimization, DPO)的综合性综述,系统探讨了其理论基础、变体方法、偏好数据集及在 LLM、多模态和智能体领域的应用。DPO 作为 RLHF 的非强化学习替代方案,已成为 Llama 3 和 Qwen2 等 SOTA 模型的标配对齐技术。
TL;DR
在大型语言模型(LLM)的对齐时代,DPO(Direct Preference Optimization)正迅速取代传统的 RLHF 成为事实上的标准。本文深入解析了 DPO 的兴起逻辑:它通过数学上的巧妙转换,将复杂的强化学习问题降维打击成简单的分类问题。我们不仅会剖析其背后的“隐式奖励”机制,还将探讨它在 Llama 3 等顶级模型中的实战表现,以及它目前面临的“对齐税”与“泛化难题”。
背景定位:这是一篇横跨理论基础演进到大规模工业应用的深度 SURVEY,标志着对齐技术从“玄学调优”向量化、标准化迈进。
1. 为什么要抛弃 PPO?DPO 的上位之路
传统的 RLHF(以 PPO 算法为核心)一直被学术界诟病为“炼金术”。它需要同时维护策略模型、参考模型、奖励模型和价值模型,内存消耗巨大且超参数极其敏感。
DPO 的直觉(Insight):如果目标是让模型生成的回答符合人类偏好,我们为什么不直接让模型学会区分“好”回答和“坏”回答,而要绕道去训练一个中间态的奖励模型?
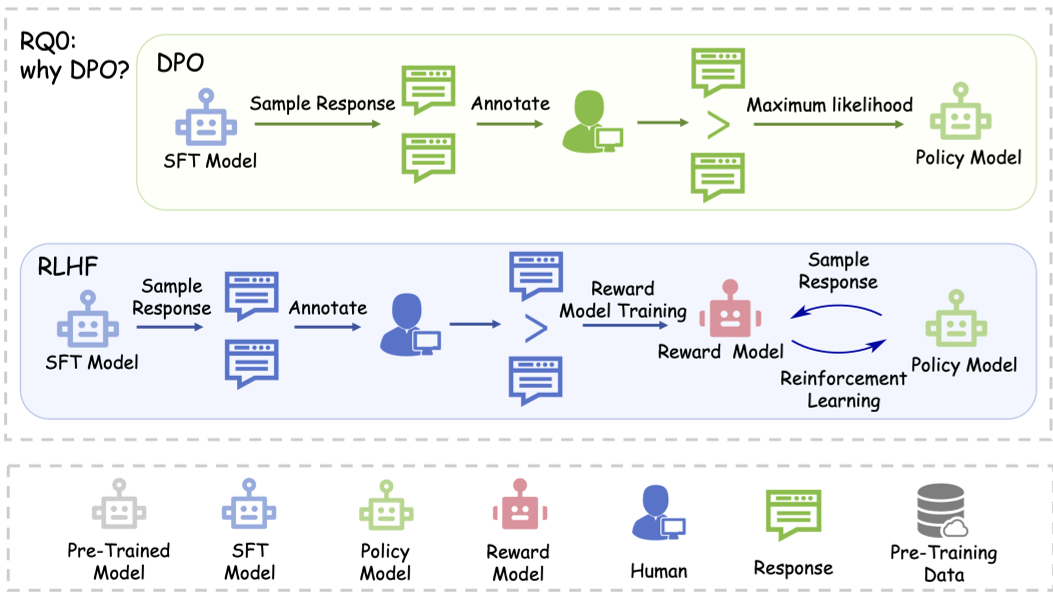 图 1:DPO 将多阶段流程简化为单阶段,显著降低了计算成本。
2. DPO 的数学魔术:隐式奖励模型
DPO 最核心的贡献在于证明了:最优策略 π 与奖励函数 r 之间存在解析解关系。
通过这一推导,DPO 构造了一个基于 Sigmoid 的损失函数(如下式 8 所示):
L_DPO = -E[log σ(β log(π_θ(yw|x)/π_ref(yw|x)) - β log(π_θ(yl|x)/π_ref(yl|x)))]
这行公式背后的物理直觉是:它在不断推大“被选择回答(Winning response)”与“被拒绝回答(Losing response)”相对于参考模型的对数概率差。
3. 核心变体:解决 DPO 的“偏科”问题
尽管 DPO 很强大,但调研发现它存在三个致命痛点:
- 长度黑客(Length Hacking):模型发现只要写得长,分数就高(虽然内容可能全是幻觉)。
- OOD 泛化弱:由于是离线训练,遇到没见过的问题就容易崩溃。
- 粒度太粗:对于长代码或复杂数学推理,错一步就扣全部分数是不公平的。
目前的主流改进方案(见表 2):
- SimPO:引入长度归一化(Length-normalized margin),不带参考模型也能打败 DPO。
- Step-DPO:引入步骤级(Step-wise)对齐,精细打击逻辑错误,大幅提升数学推理能力。
- ORPO:将 SFT 与对齐合并,减少训练阶段,进一步压缩成本。
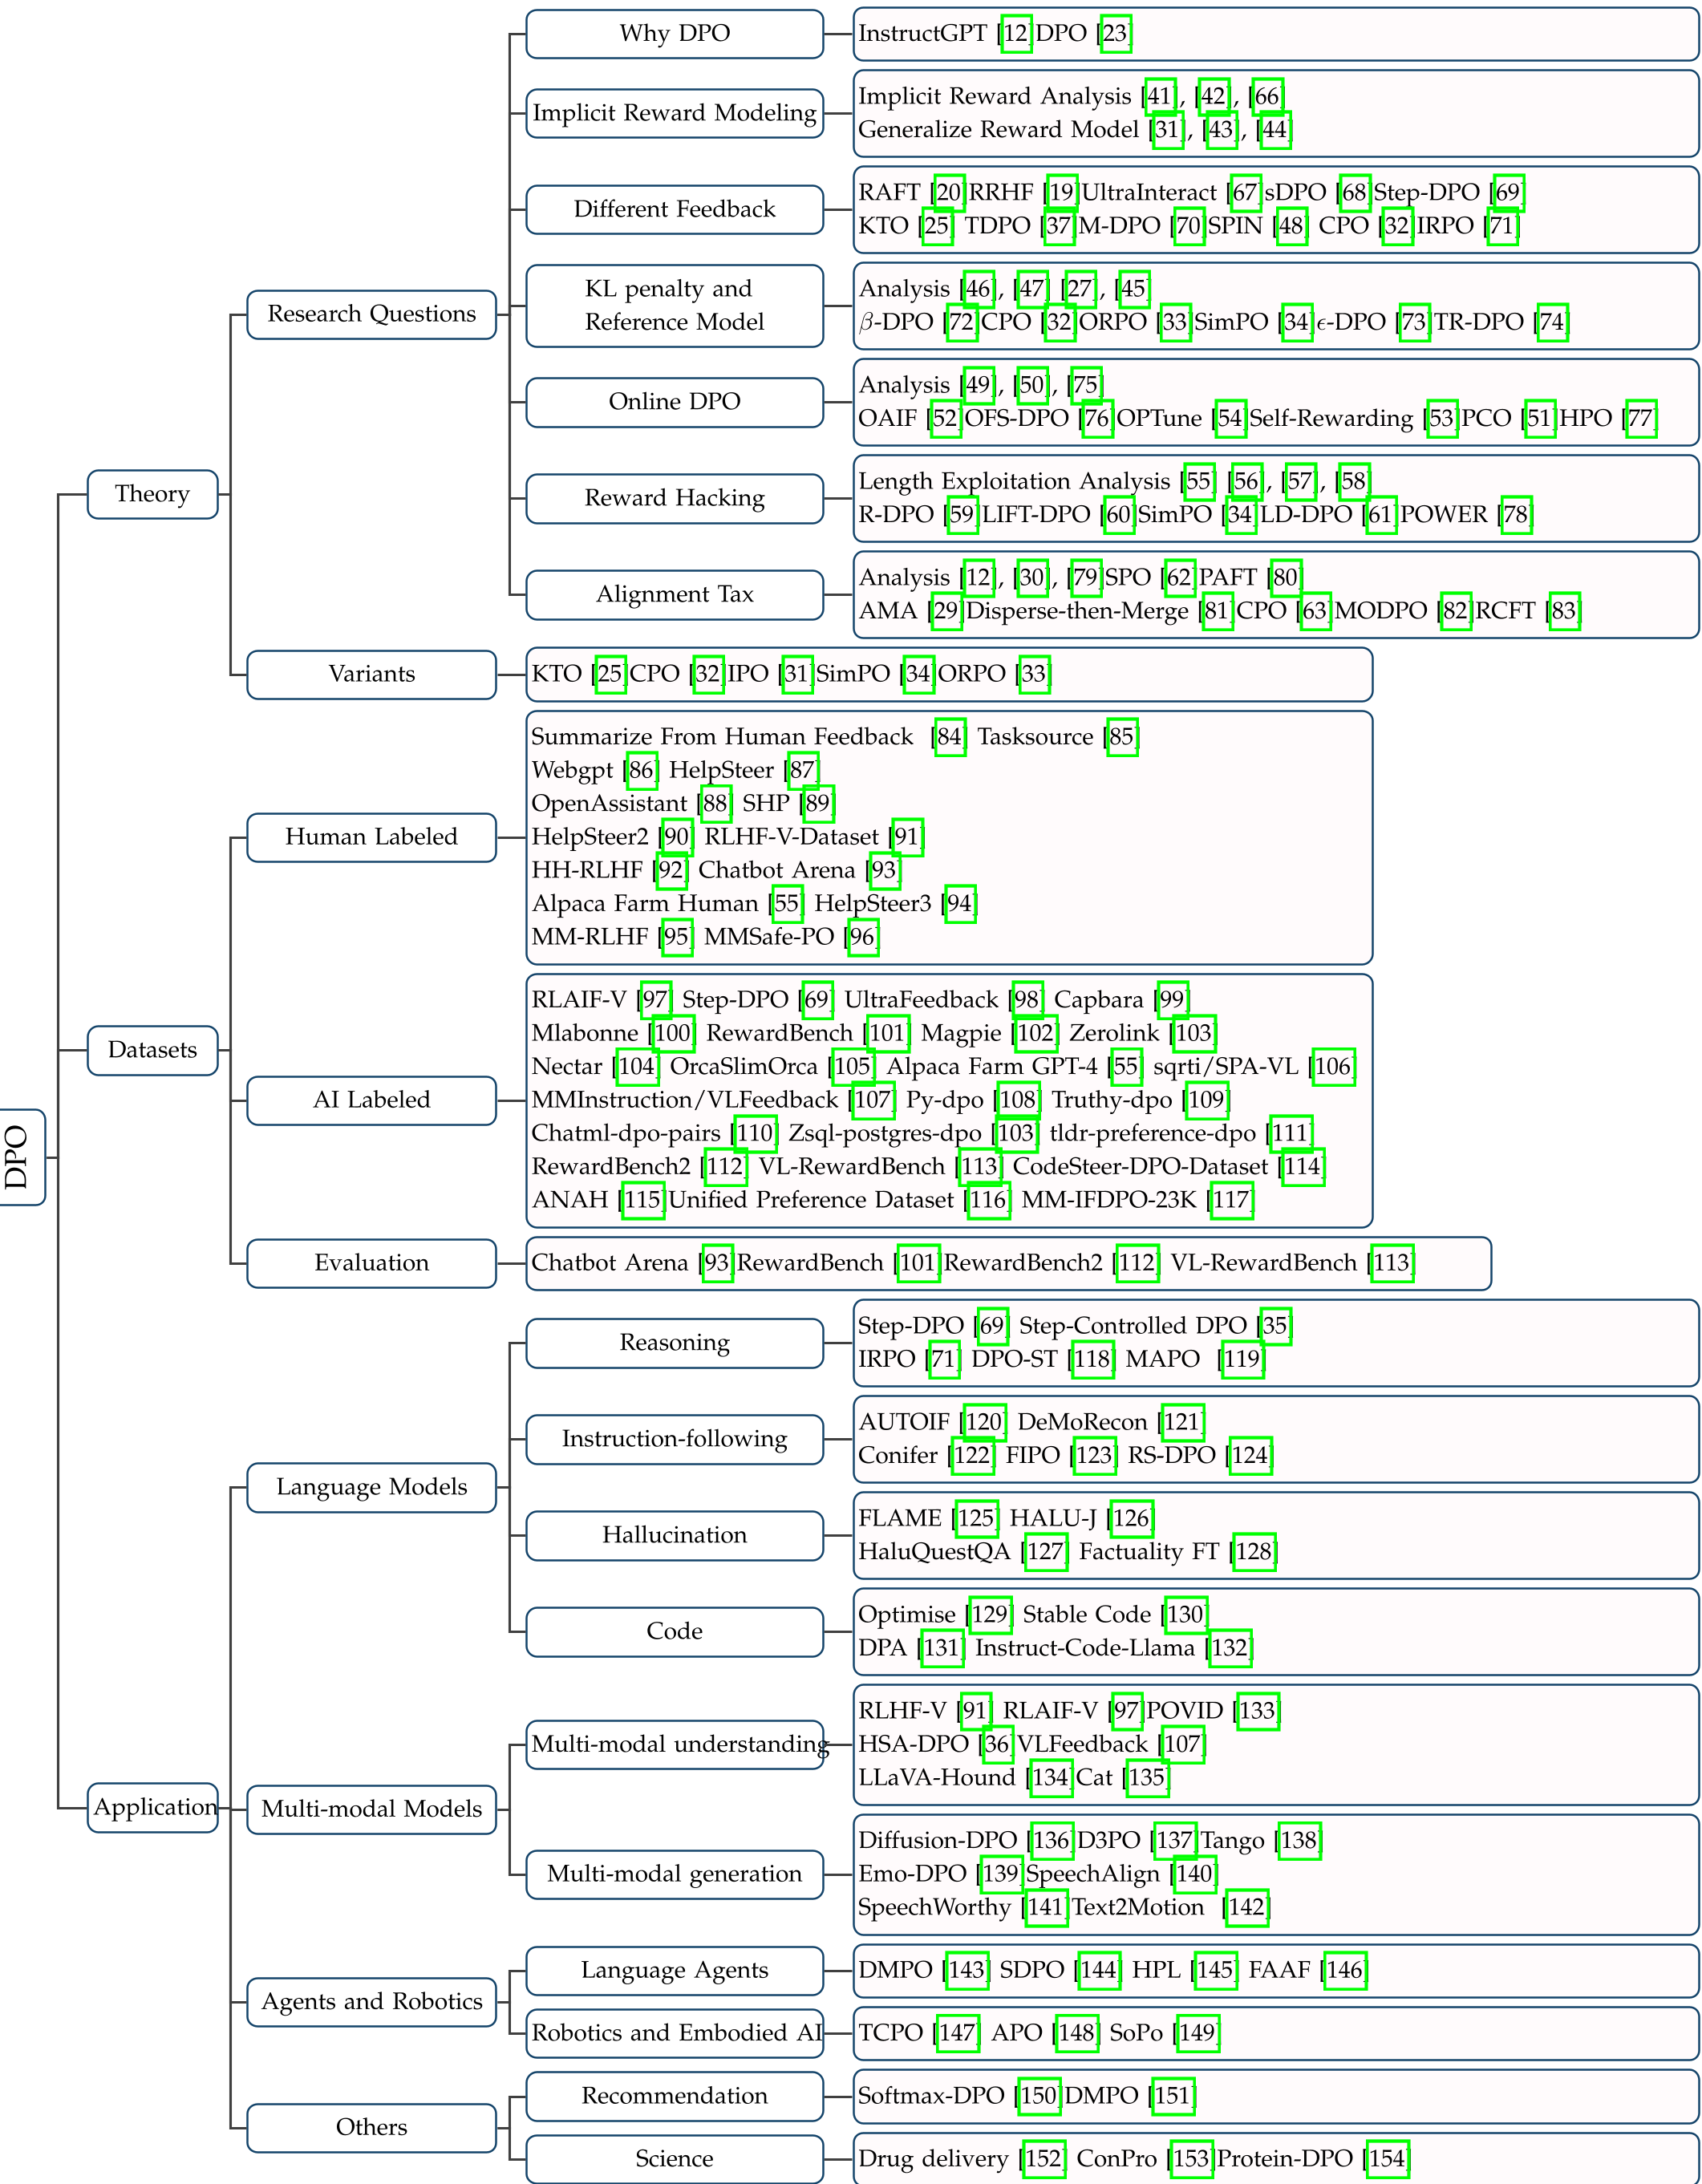 图 2:DPO 的研究版图,涵盖了理论、变体、数据集及应用。
4. 实验战绩与工业实践
在 Llama 3 和 Qwen2 的官方技术报告中,DPO 均被作为关键技术提及。
- SOTA 对比:在相同算力下,DPO 对齐后的模型在 Chatbot Arena 上的 Elo 分数显著高于纯 SFT 模型。
- 对齐税(Alignment Tax):研究表明,过度对齐会导致模型在通用 NLP 任务上性能下降。DPO 通过调节 β 系数可以较好地平衡“听话”与“聪明”之间的矛盾。
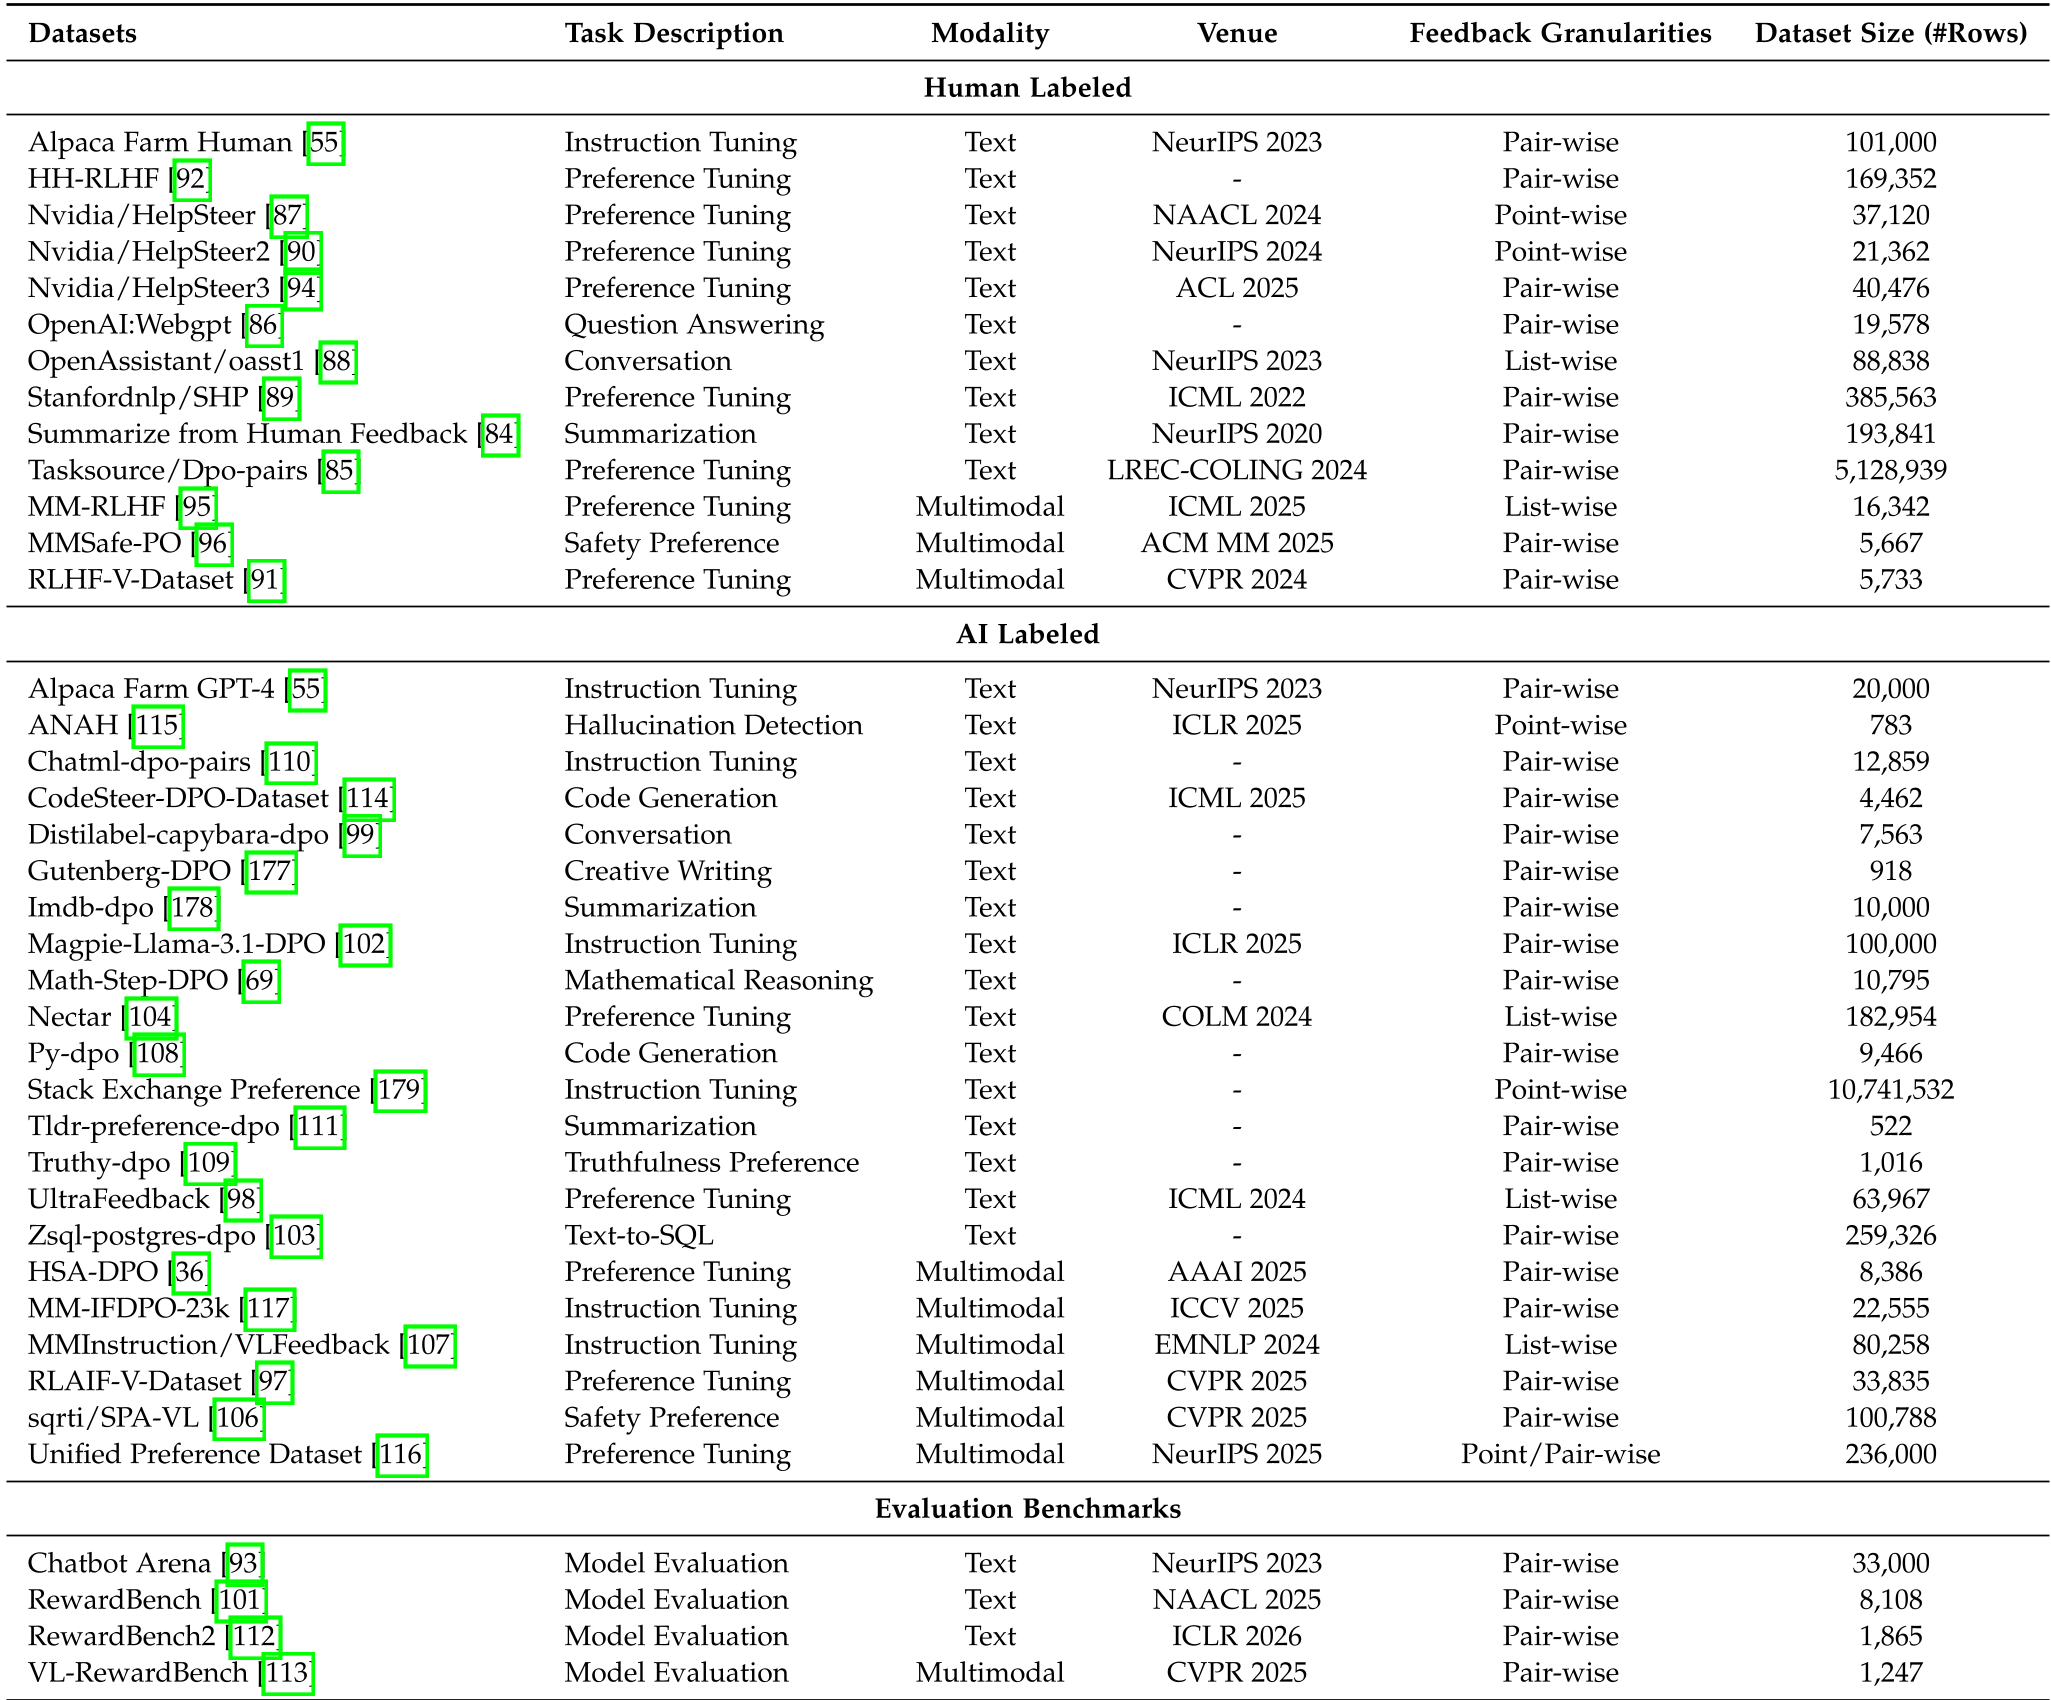 表 1:当前主流的偏好数据集(如 UltraFeedback, HH-RLHF)为 DPO 提供了充足的燃料。
5. 深度洞察与总结
DPO 的本质是 “从排序中学习”。它将 LLM 的训练从单纯的模仿(Next Token Prediction)提升到了甄别与决策的层面。
Takeaway 总结:
- 优势:稳定、高效、显存友好,是中小团队进行模型定制化对齐的必选。
- 局限:对标注数据质量极度敏感(Bad data in, bad model out)。
- 未来:我们将看到更多基于 Self-Play(自博弈) 的在线 DPO 变体,让模型在不断自我生成的过程中实现迭代进化,类似于 OpenAI o1 的长链路推理对齐。
作者评论:DPO 的出现并不是终点,而是开启了“非 RL 对齐”的大门。未来的挑战在于如何利用 DPO 处理非二元偏好(如分数值为 0-10 的连续反馈)以及在具身智能(Robotics)中复杂的连续动作空间对齐。