
CDA-VSR:榨干视频码流,实现 2K 视频直播的实时超分辨率
Compressed-Domain-Aware Online Video Super-Resolution
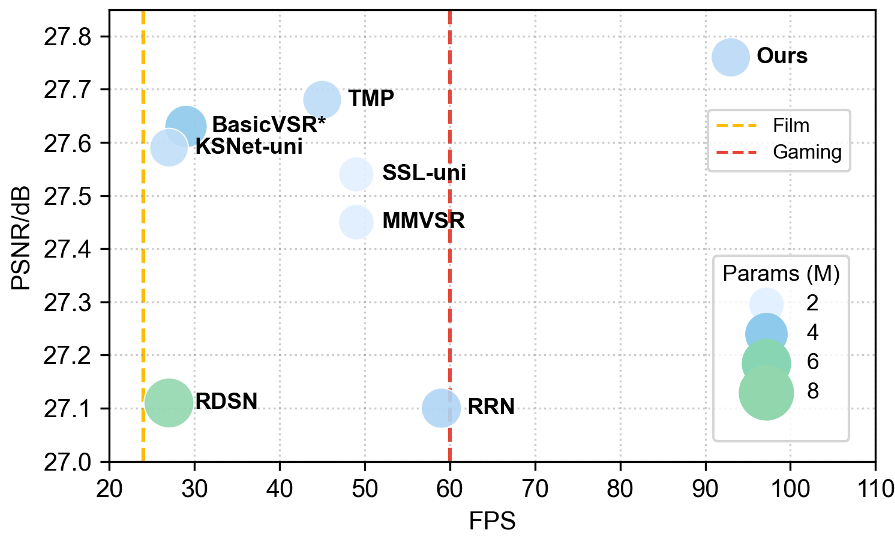
本文提出了 CDA-VSR,一种专为在线视频流设计的压缩域感知超分辨率网络。该方法通过直接利用视频码流中的运动向量 (Motion Vectors)、残差图 (Residual Maps) 和帧类型 (Frame Types),在 REDS4 数据集上超越了 SOTA 方法 TMP,PSNR 提升 0.13 dB 且推理速度提高两倍以上(达 90 FPS)。
TL;DR
传统的视频超分辨率(VSR)往往在“画质”和“速度”的天平两端痛苦抉择,特别是面对 2K/4K 高清实时流时。北京理工大学的研究团队通过 CDA-VSR(Compressed-Domain-Aware VSR) 改变了游戏规则:不再仅仅处理解码后的像素,而是直接“监听”视频码流中的秘密——运动向量、残差图和帧类型。这一举措让模型推理速度翻倍(90 FPS),同时画质刷新了 SOTA 记录。
背景定位:在线 VSR 的“算力黑洞”
在线视频超分辨率要求模型仅利用过去和当前的帧进行推理。现有的 SOTA 方法(如 TMP, KSNet)大多在**运动对齐(Alignment)**上耗费了大量算子。为了处理剧烈运动,它们不得不堆叠复杂的 DCN(可变形卷积)或者光流子网络,这在 3090 显卡上处理 2K 视频都显得步履维艰。
痛点深挖:被浪费的“免费信息”
作者敏锐地观察到:虽然我们在客户端做超分,但这些视频在服务器端其实已经被 H.264 等标准压缩过了。压缩码流中已经包含了:
- 运动向量 (MV):已经算好的粗略块级运动。
- 残差图 (Residual Maps):标记了哪些地方预测不准(通常是复杂纹理或遮挡边缘)。
- 帧类型 (Frame Types):告诉我们哪一帧是独立关键帧(I 帧),哪一帧是参考预测帧(P 帧)。
以往的方法把这些信息扔掉后再用神经网络重算一遍,这无疑是效率的巨大浪费。
核心架构:压缩域感知的三支箭
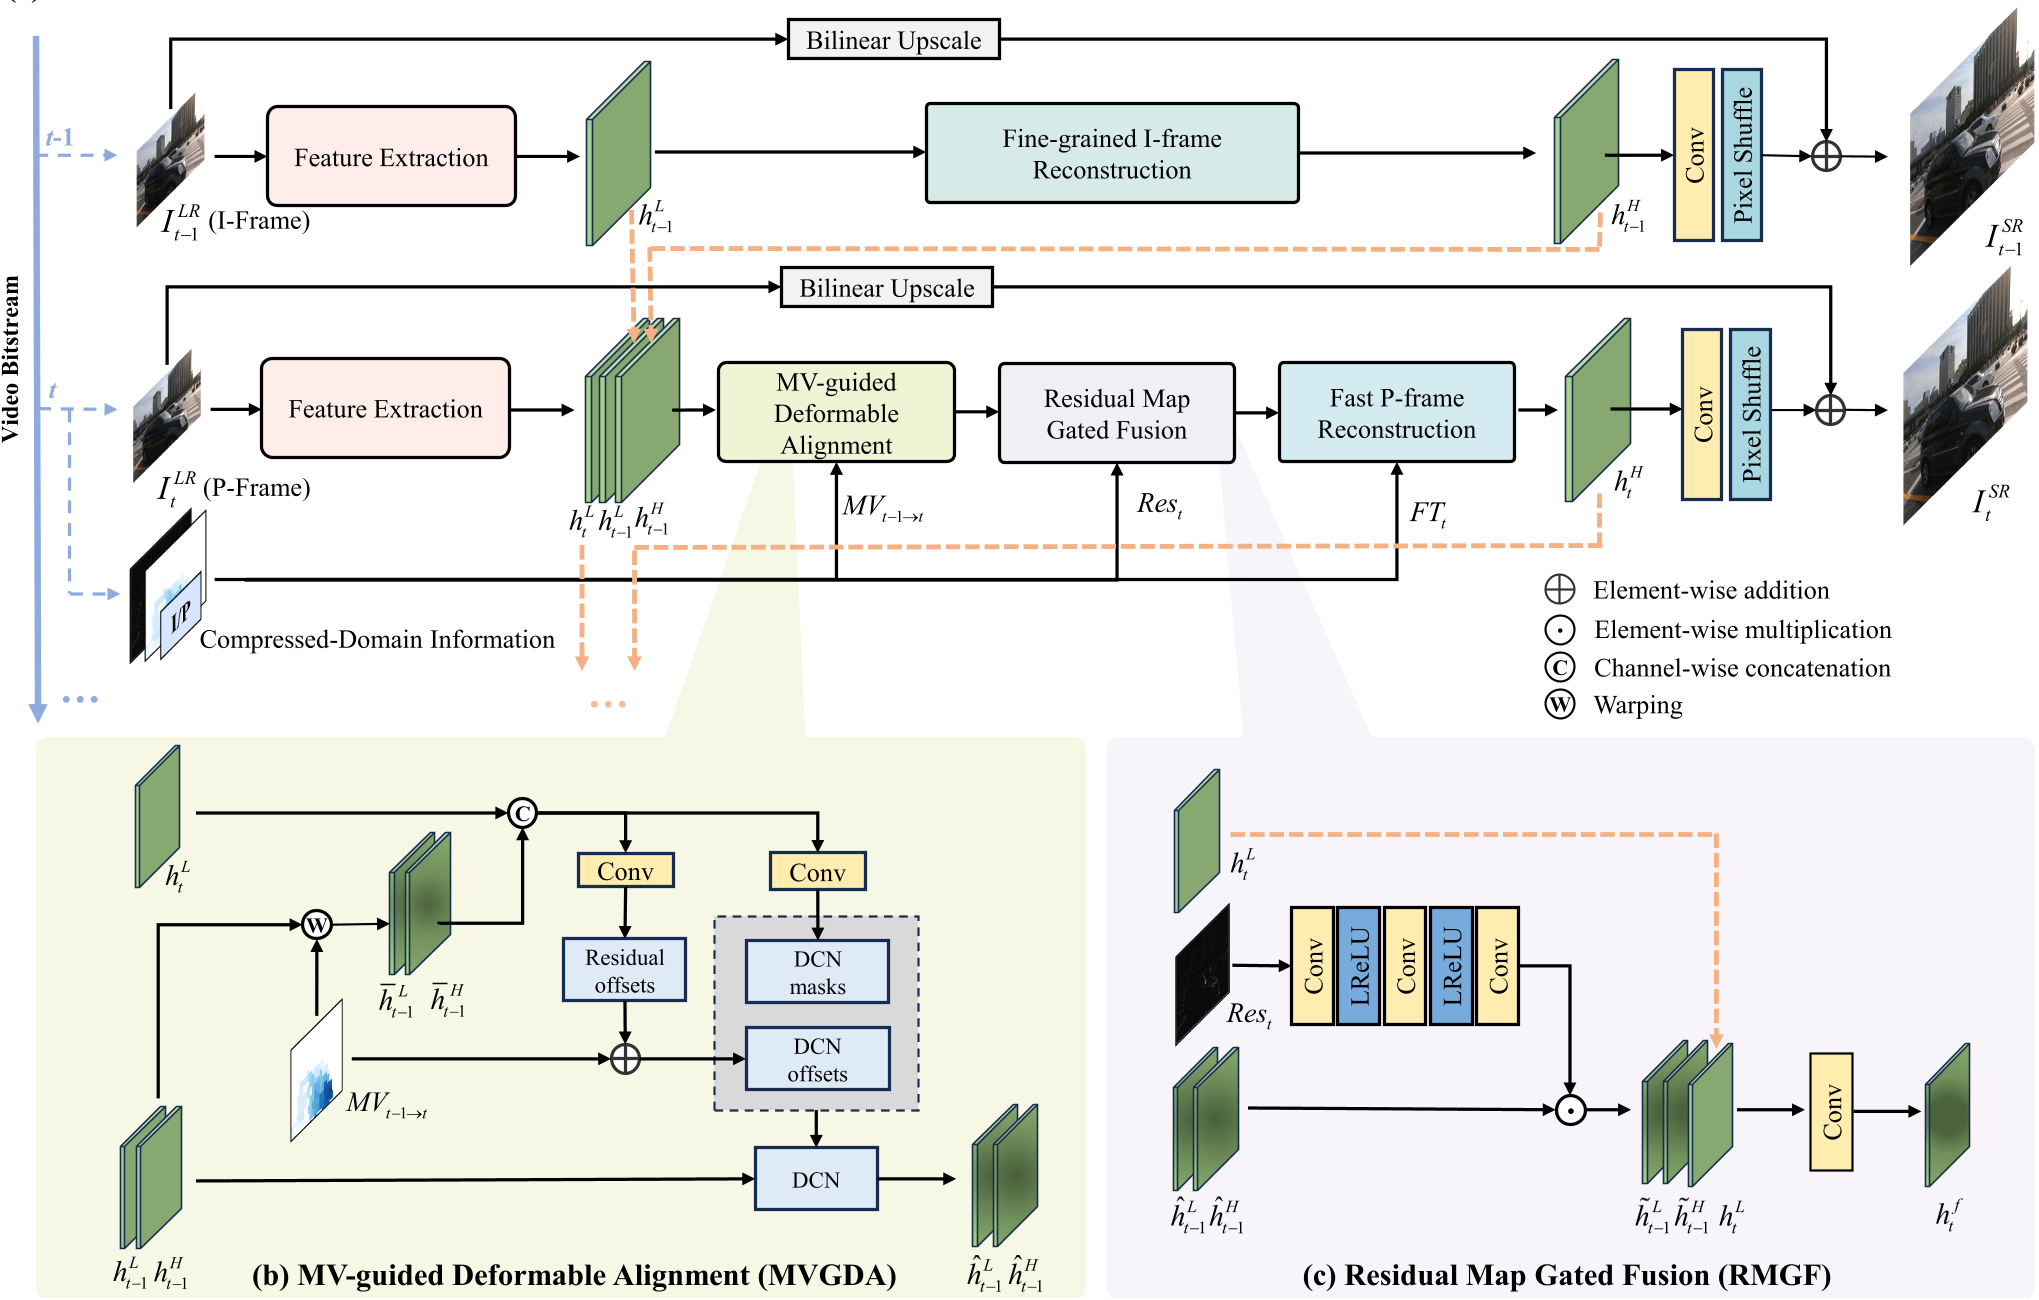
CDA-VSR 通过三个专门设计的模块,将上述废料“化腐朽为神奇”。
1. MVGDA:运动向量引导的轻量化对齐
传统的 DCN 需要从零学习采样偏移(Offset),在运动幅度大时极容易发散。MVGDA 利用码流中“免费”的 Motion Vector 先做一次粗略 Warp,神经网络只需要学习微小的局部修正(Residual Offset)。
- 物理直觉:就像先给人一个大致坐标,再让他寻找具体位置,比让他在荒野漫游快得多。
2. RMGF:基于残差图的门控融合
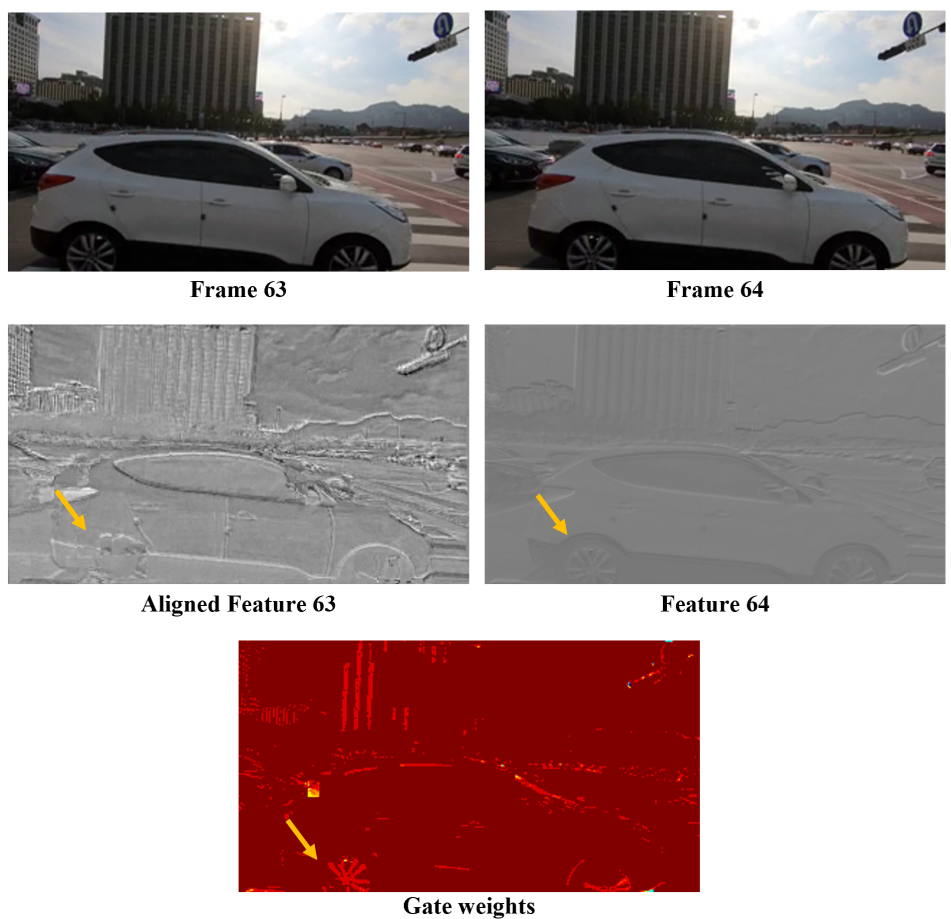
跨帧融合最怕“带崩”画质——如果前一帧对得不齐,强行融合会产生重影。RMGF 利用 Residual Map 生成空间权重。残差大的地方说明运动补偿失效,权重调低;残差小的地方说明背景稳定,权重调高,引入历史信息增强细节。
3. FTAR:分帧治理的精细算力分配
这是工程上的神来之笔。作者发现 I 帧作为序列的基石,必须精修;而 P 帧可以通过历史信息“白嫖”细节。因此,FTAR 为 I 帧配置了 24 个残差块,而为 P 帧仅配置 12 个。
- 成果:在几乎不损失精度的情况下,整体推理延迟大幅降低。
实验战绩:速度与画面的双重碾压
在 REDS4 数据集测试中,CDA-VSR 展示了惊人的性能曲线:
- 画质:最高提升 0.13 dB。
- 速度:单帧 10.8ms,达到 93 FPS,对比 baseline TMP 的 45 FPS 提升了 100%+。
- 2K 挑战:在 2K 分辨率下,它是同类模型中唯一能稳住 24 FPS 电影级实时率的存在。
从可视化结果(图 5 和 图 6)可以看到,由于有了残差图的引导,热力图能够精准避开旋转的车轮等难以对齐的区域,从而保证了生成的画面不会出现常见的伪影。
总结与价值
CDA-VSR 的成功标志着 VSR 研究正在从“纯算法竞赛”转向“软硬结合的系统级优化”。它不再视视频压缩为一种损失,而是将其视为一种计算路标。
局限性:该方法强依赖于 H.264 等压缩标准提供的元数据,如果输入是未压缩的原始帧,其优势会消失。但考虑到现代互联网视频流 99% 都是压缩流,这一方案的落地前景极其广阔。未来,这种“压缩域感知”的思想可能会进一步渗透到视频去噪、补帧等全线视觉任务中。