
CPGA:激活码流中的“隐藏信息”,突破视频增强性能瓶颈
CPGA
本文提出了 CPGA,一种利用编码先验指导的压缩视频质量增强(VQE)网络。该方法通过引入运动矢量(MVs)、预测帧和残差帧,结合帧间时间聚合(ITA)和多尺度非局部聚合(MNA)模块。在标准测试集上达到了顶级 SOTA 水平,并构建了包含编码先验的 VCP 新数据集。
TL;DR
在视频压缩领域,编码过程产生的秘密武器——编码先验 (Coding Priors) 往往被深度学习模型所忽视。电子科技大学与快手技术团队联合提出的 CPGA (Coding Priors-Guided Aggregation) 网络,通过显式利用运动矢量、预测帧和残差帧,配合多尺度非局部聚合机制,在提升视频画质的同时,维持了极高的推理效率。
1. 痛点:被遗忘的“码流财富”
传统的视频质量增强(VQE)方法大多专注于如何利用 Optical Flow 或 Deformable Convolution 进行帧间对齐。这存在两个弊端:
- 算力浪费:视频在解压时已经计算并存储了运动矢量(MV),神经网络再去重新估计一次,无疑是重复造轮子。
- 信息缺失:压缩过程中的预测残差(Residual)反映了编码器最难处理的“瑕疵区域”(如边缘、纹理),这对于画质修复至关重要,但往常方法视而不见。
为了解决这一问题,作者构建了全新的 VCP 数据集,填补了由于缺乏编码先验信息而导致研究受限的空白。
2. 核心架构:三位一体的聚合网络
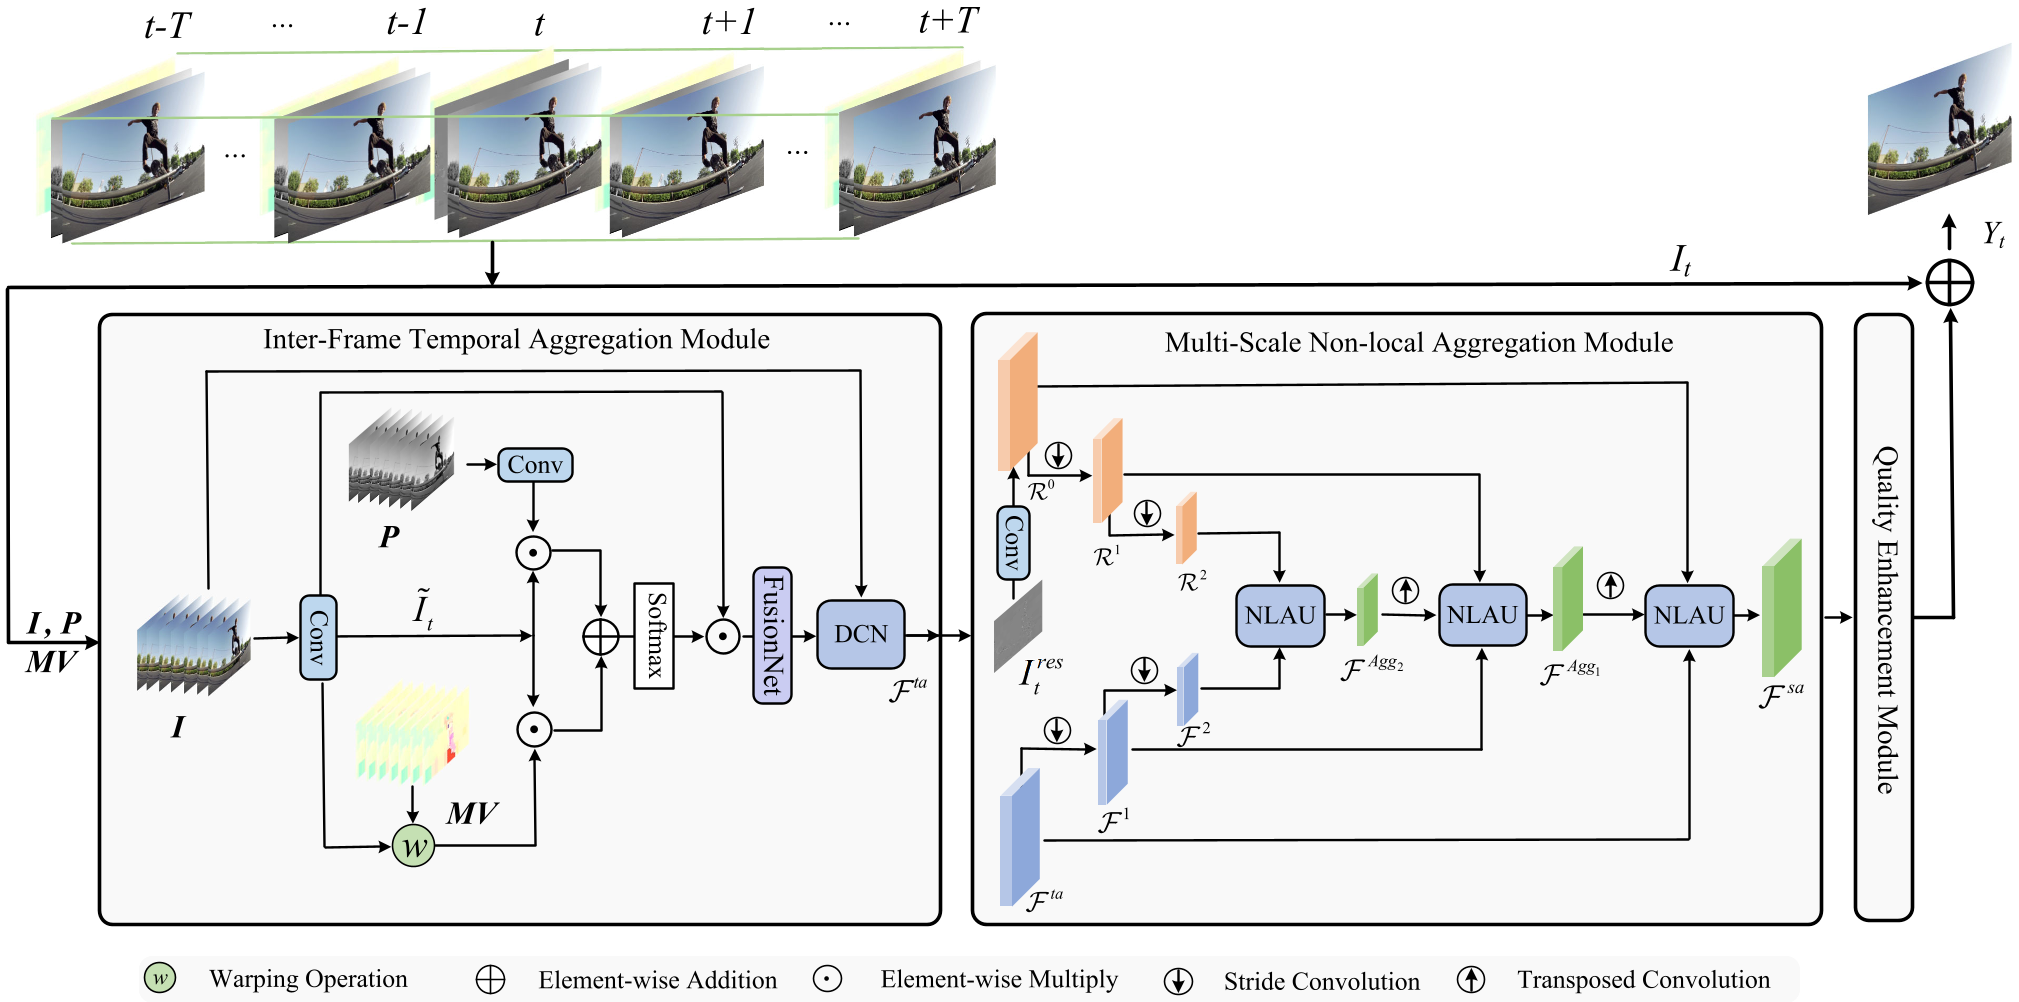
CPGA 的核心直觉在于:时间上的对齐应交给运动矢量,空间上的细节定位应交给残差帧。
2.1 帧间时间聚合 (ITA)
ITA 模块不再盲目搜索运动,而是使用 Warp 算子 通过码流中的 MV 直接对齐特征。它利用预测帧(Predictive Frame)作为参考,通过 Softmax 归一化的加权融合,实现了极低成本的运动补偿。
2.2 多尺度非局部聚合 (MNA)
残差帧通常蕴含了强烈的空间梯度特征。MNA 模块在三个尺度上(Scale=0, 1, 2)引入了 Non-Local Aggregation Unit (NLAU)。这些单元在残差帧特征的引导下,通过计算像素间的长程依赖,精确修复压缩导致的伪影和模糊。
2.3 偏移通道注意力 (SCAB)
为了进一步增强特征质量,QE 模块引入了偏置操作。
- Shift-H/V:在不增加额外乘加运算的前提下,通过水平和垂直的通道偏移(Partial Channel Shifting),极大地延展了神经元的有效感受野。
3. 实验结果:速度与质量的双重飞跃
实验在 HEVC 不同配置(LDB, RA)和不同 QP 值下展开。
-
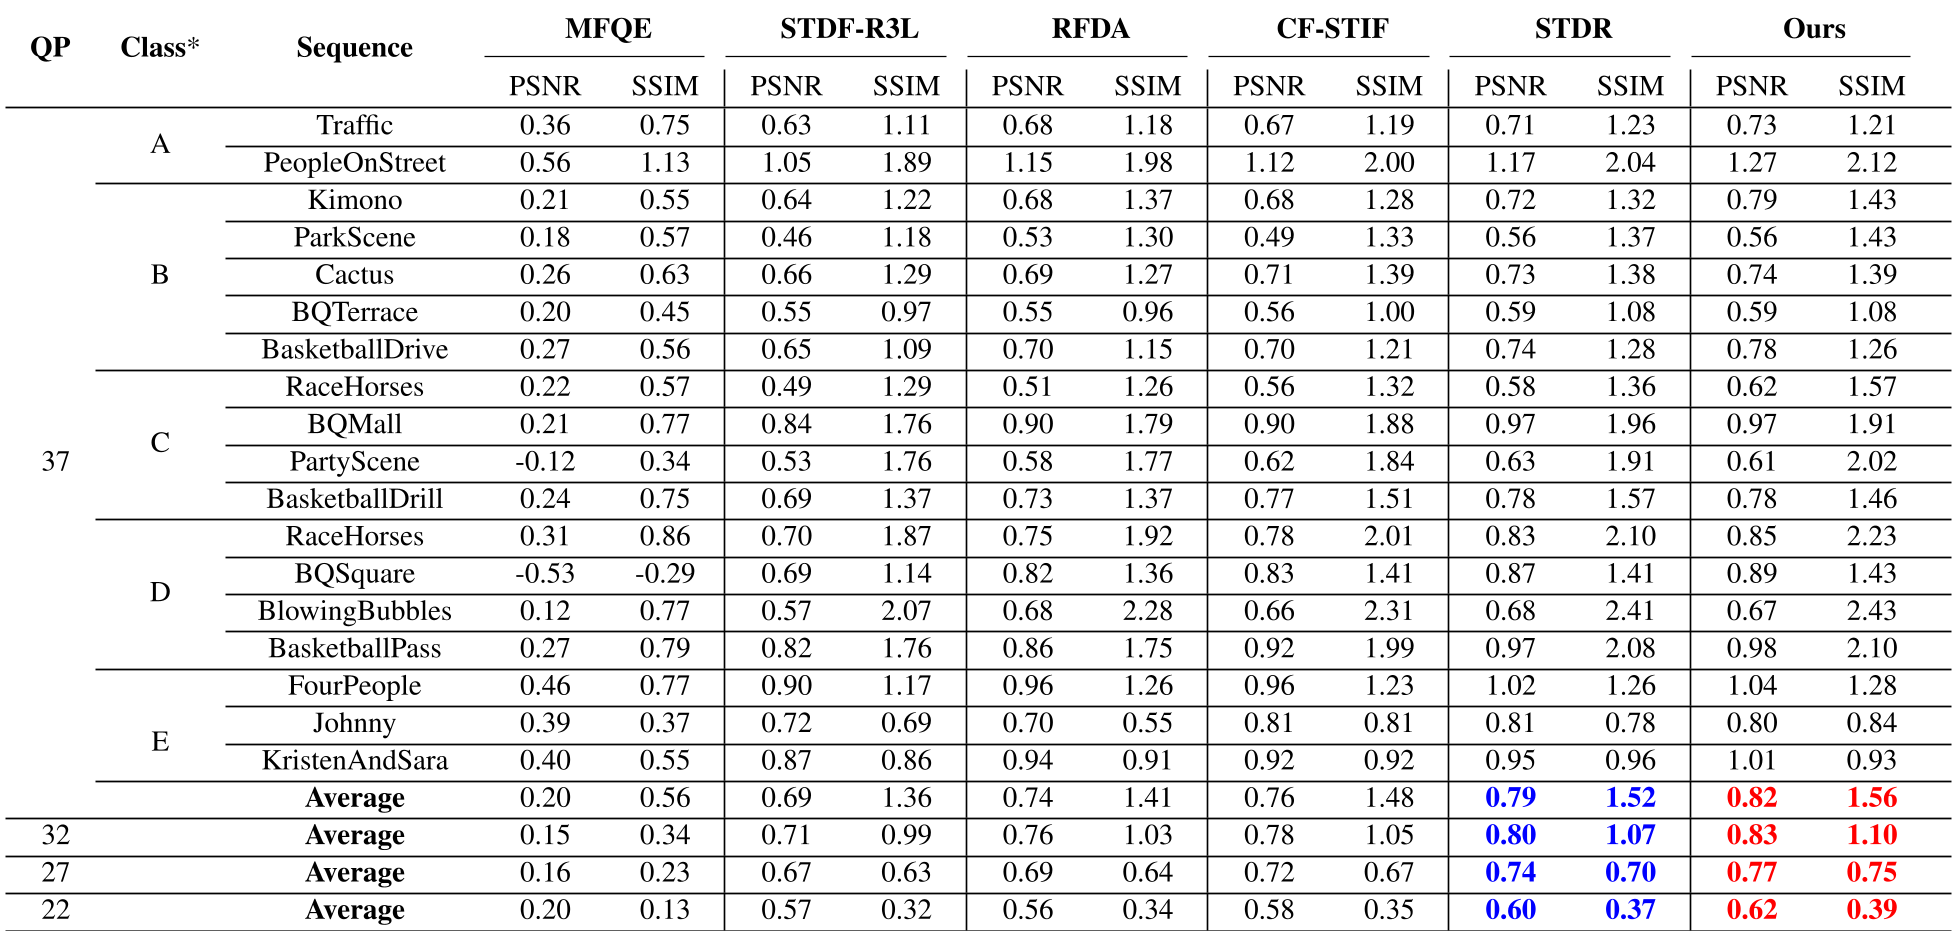
量化对比:如表 2 所示,在 LDB 配置下,CPGA 在所有测试序列上均优于现有的 STDR 和 RFDA。
-
推理速度:虽然 CPGA 引入了额外的先验输入,但由于其轻量化的聚合设计,在 1280×720 分辨率下,其 FPS 依然比 STDR 提升了约 10%。
-
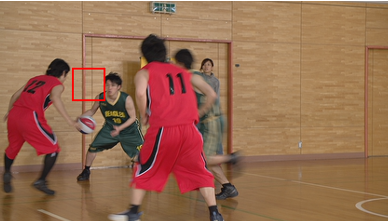
主观效果:CPGA 生成的视频在纹理(如文字、细密线条)上明显更清晰,极大地减轻了“方块效应”。
4. 深度洞察
CPGA 的成功在于它将 Hybrid Video Coding (混合视频编码) 的经典逻辑与 Deep Learning 的表征能力进行了深度融合。不同于“纯黑盒”模型试图学习所有规律,CPGA 选择“站在编码器的肩膀上”,利用已有的 MVs 进行初级对齐。
局限性分析: 该方法高度依赖于特定的视频编码格式(如 HEVC)。如果面对未知格式或经过多次转码的视频,先验信息的准确性可能会下降。如何增强模型对“先验噪声”的容错,将是该技术走向工业落地的下一个课题。
结论
CPGA 证明了在人工智能时代,传统的信号处理先验依然具有不可替代的价值。它不仅刷写了 VQE 的 SOTA 记录,更为后续研究提供了一个更具工程启发性的方向:在模型设计中,数据与先验一个都不能少。