
EmotionCLIP:借文本之桥,破 EEG 跨域情感识别之困
Cross-Domain EEG-Based Emotion Recognition with Contrastive Learning
本文提出了 EmotionCLIP,这是一种将 EEG 跨域情感识别重新定义为 EEG-文本匹配任务的新型对比学习框架。通过结合预训练的 CLIP 文本编码器与专为 EEG 设计的 SST-LegoViT 骨干网络,该方法在 SEED 和 SEED-IV 数据集上分别实现了 88.69% 和 73.50% 的跨受试者识别准确率,显著刷新了 SOTA 记录。
TL;DR
脑电信号(EEG)虽然是解析人类情感的“直连线路”,但其极大的个体差异让传统模型难以跨人、跨时间通用。西安交大研究团队提出的 EmotionCLIP 另辟蹊径:不再纠结于复杂的分类逻辑,而是将 EEG 信号与情感文本描述进行“对齐”。通过全新的 SST-LegoViT 骨干网络提取时-空-频特征,该方法在 SEED 数据集上刷新了 SOTA 表现,跨受试者准确率大涨至 88.69%。
1. 背景定位:情感识别的“跨域孤岛”
情感识别(Emotion Recognition)在心理健康监控和人机交互中意义重大。EEG 信号因其不可伪装性和高时间分辨率成为研究重心。然而,EEG 信号的 Unstationarity(非平稳性) 导致同一个人的情感信号在不同时间看完全不同,更遑论不同受试者之间巨大的物理分布差异。
目前的 SOTA 方法多采用领域自适应(Domain Adaptation),试图寻找“不变特征”。但作者认为,与其在波动的 EEG 信号中苦苦搜寻,不如引入一个绝对稳定的锚点——文本(Text)。无论谁产生的“快乐”脑电波,其最终对应的描述词语“Happy”在语义空间是永恒不变的。
2. 核心架构:EmotionCLIP 与 SST-LegoViT
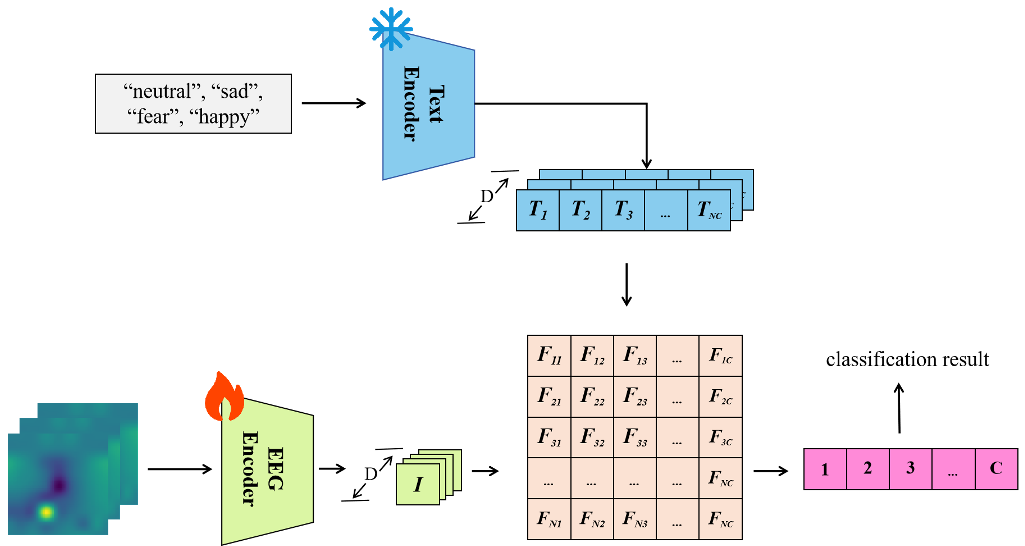
EmotionCLIP 的核心直觉是:利用 CLIP 的强大语义表征力,将识别任务转化为一个匹配任务。
2.1 任务重构:EEG-Text Matching
模型包含两个分支:
- Text Encoder:锁定预训练的 CLIP 文本编码器,利用 16 种 Prompt 模板(如 "The video makes the human feel {label}")将标签向量化。
- EEG Encoder:自研的 SST-LegoViT,负责将复杂的 4D EEG 信号压缩进相同的向量空间。
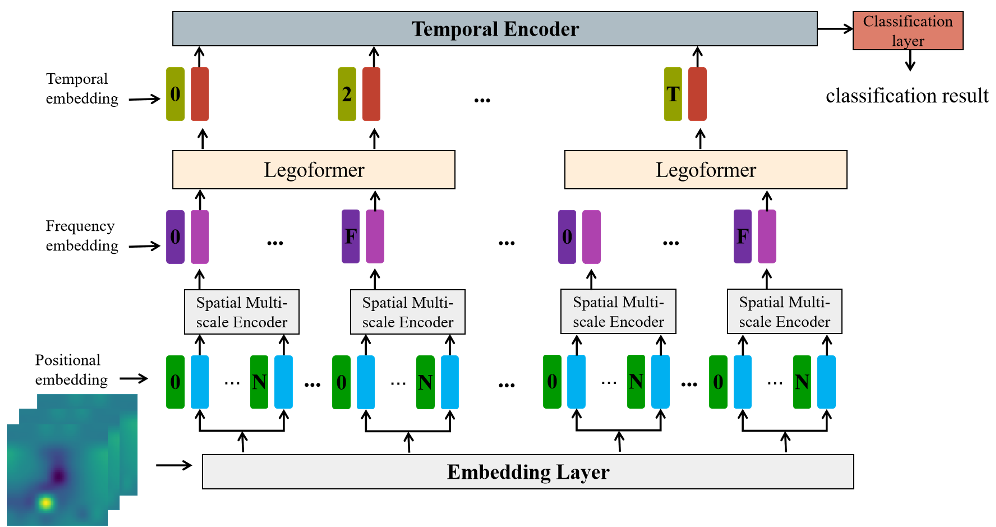
2.2 SST-LegoViT:全方位的特征采集
EEG 信号包含三个物理维度:空间、频率、时间。SST-LegoViT 实现了“三位一体”的处理:
- 空间多尺度编码:放弃了 ViT 简单的 Patch 处理,通过 1×1、3×3、5×5 的多路径卷积捕捉大脑拓扑结构的局部与全局联系。
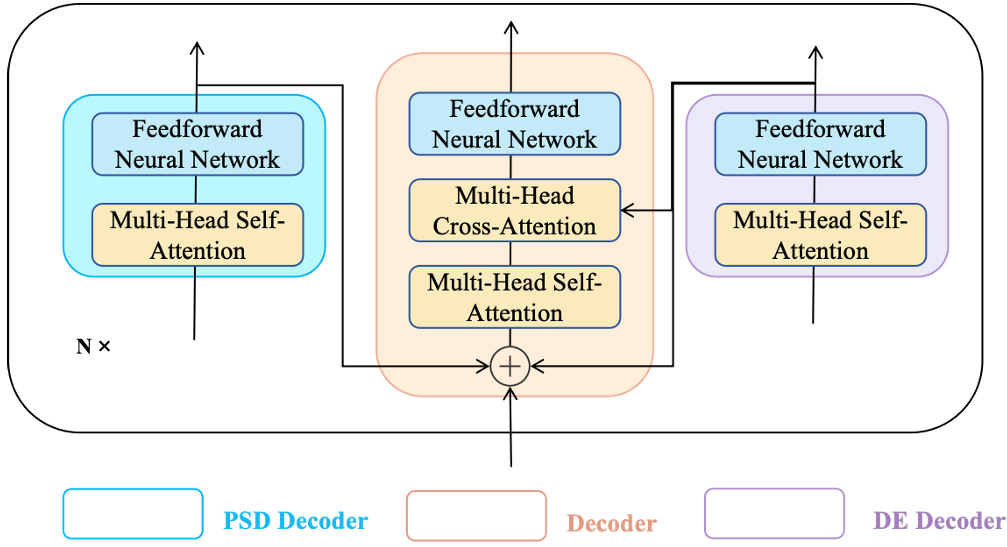
- Legoformer 频域融合:EEG 在不同频带()的表现力各异。Legoformer 使用 Cross-attention 机制,以微分熵(DE)为核心,动态融合功率谱密度(PSD),实现了特征的自适应互补。
- 时间 Sequence 处理:最后由 Transformer 捕捉情感随着时间演变的动态特性。
3. 实验结果:刷新学术坐标系
研究团队在 SEED 和 SEED-IV 两个权威数据集上进行了严苛的测试,包括:
- Cross-subject (LOSO):留一受试者交叉验证。
- Cross-time:跨 Session 测试。
3.1 跨域泛化性的质变
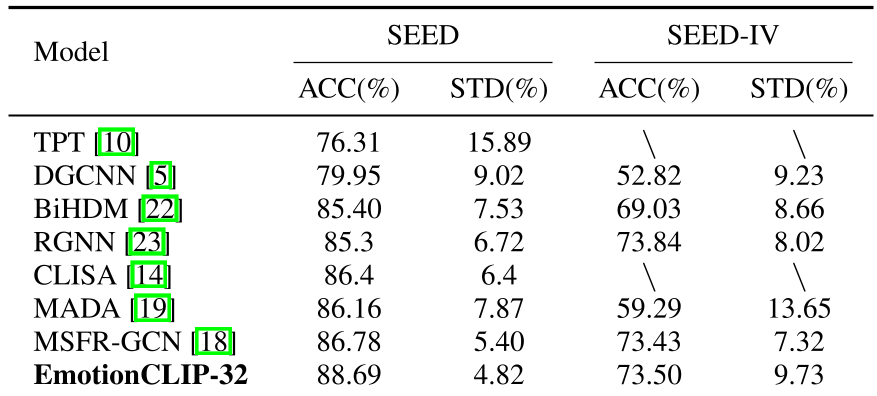
在 SEED 数据集上,EmotionCLIP-32 相比之前的强基线模型 CLISA 和 MADA,在准确率上提升了 2%-3%。即使在最具挑战性的 SEED-IV 四分类任务中,也展现出了极强的稳定性。
3.2 为什么有效?(消融实验)
消融实验发现,即便不进行任何下游微调(Zero-shot),EEG-Text 对齐模式的表现(65.61%)也远好于纯 EEG 的分类模式(61.42%)。这从物理直觉上证实了:语言空间能够为不稳定的信号提供一种“全局校准”。
4. 深度洞察与总结
EmotionCLIP 的核心价值在于其“归纳偏置”的转变。 它不再尝试直接学习一个复杂的非线性分类超平面,而是借助大规模语言模型预训练带来的通用知识,将脑电信号投射到人类已有的成熟语义体系中。
局限性与展望: 尽管 EmotionCLIP 推高了性能上限,但可以看到不同受试者之间的表现差异依然巨大(有些接近 100%,有些则在 60% 徘徊),这说明 EEG 信号中的个体特异性(Subject-specific noise)尚未被完全剥离。未来的研究或许可以考虑引入大模型的推理能力,通过文本描述更细致的脑电形态,从而实现更精细的情感解析。
关键词:EEG, 情感识别, 对比学习, CLIP, 跨域泛化