CRUXEval:揭开 AI 代码理解的“虚假繁荣”——为什么会写代码但不代表懂执行?
Cruxeval: A benchmark for code reasoning, understanding and execution
本文推出了 CRUXEval,一个包含 800 个 Python 函数及其输入输出对的代码推理、理解与执行基准测试集。该基准包含输入预测 (CRUXEval-I) 和输出预测 (CRUXEval-O) 两个任务,旨在评估模型对代码执行行为的逻辑跟踪能力。
TL;DR
Meta AI 与 MIT 联合发布了 CRUXEval,这是一个专门针对代码推理与执行理解的深度基准测试。研究发现:即使是能在 HumanEval 上刷出高分的 SOTA 模型,在处理 10 行左右、逻辑极简的 Python 代码执行预测时,依然会犯一些令人匪夷所思的低级错误。
背景:被忽视的“代码模拟”能力
在 AI 辅助编程领域,现有的评价体系大多停留在“给定需求,生成代码”的端到端范式上。但这存在一个巨大的认知盲区:模型是真正掌握了代码背后的语义(Semantics),还是仅仅学会了符号概率的统计规律?
为了填补这一空白,CRUXEval 提出了两个核心挑战:
- CRUXEval-O (Output Prediction):给定一段函数和输入,预测它的返回值(正向执行)。
- CRUXEval-I (Input Prediction):给定函数和期望的返回值,推测可能的输入参数(逆向分析)。
痛点深挖:蒸馏模型的“偏科”现象
作者指出一个极其有趣的现象:许多通过蒸馏 GPT-4 指令数据而诞生的模型(如 WizardCoder, Phind),虽然在标准的代码生成任务中表现抢眼,但在 CRUXEval 上却显得力不从心。这暗示了目前的微调技术(Instruction Tuning)更多是增强了模型的“口才”和“语法模仿能力”,而非内在的逻辑严密性。
核心机制:三步走构建逻辑迷阵
CRUXEval 的构建并不是简单的随机采集,而是一套严谨的“蒸馏+过滤”流程:
- 自动生成:使用 Code Llama 34B 围绕 Python 标准库函数(如
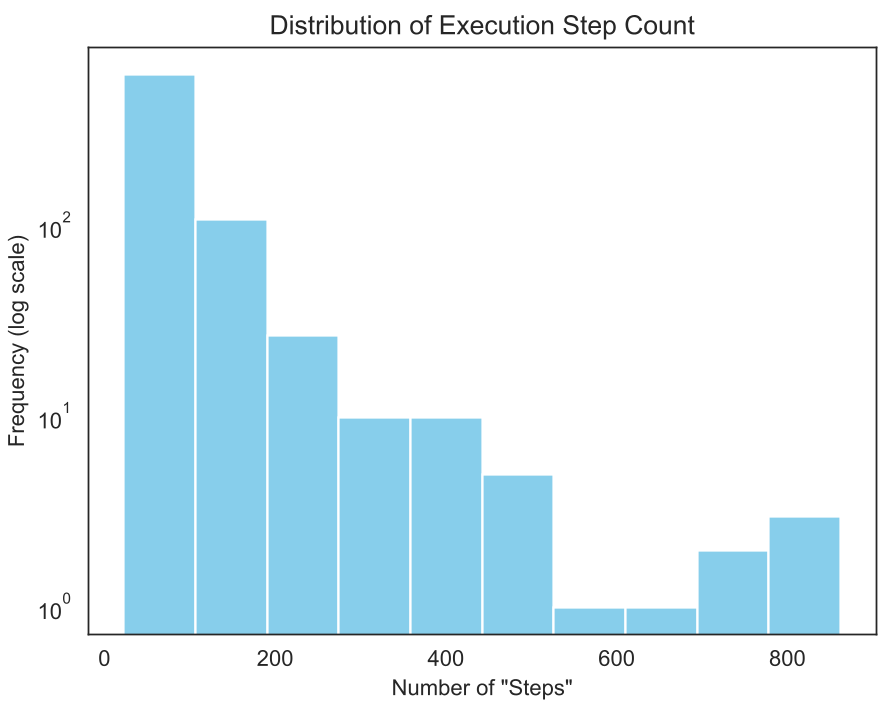
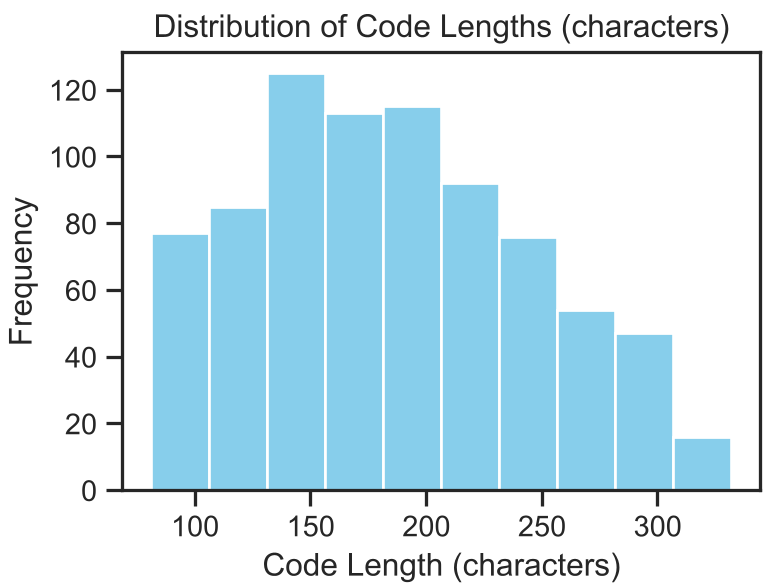
str.rfind,dict.update)生成原始候选项。 - 严格过滤:设置了极其苛刻的准入条件,包括代码必须在 3-13 行之间、严禁浮点运算(防止变成算术题)、无 I/O 副作用、且人类必须能在 1 分钟内口算得出。
- 双向验证:确保每个函数都有确定的映射关系,用于支撑正反两向的评测。
实验分析:GPT-4 也不是常胜将军
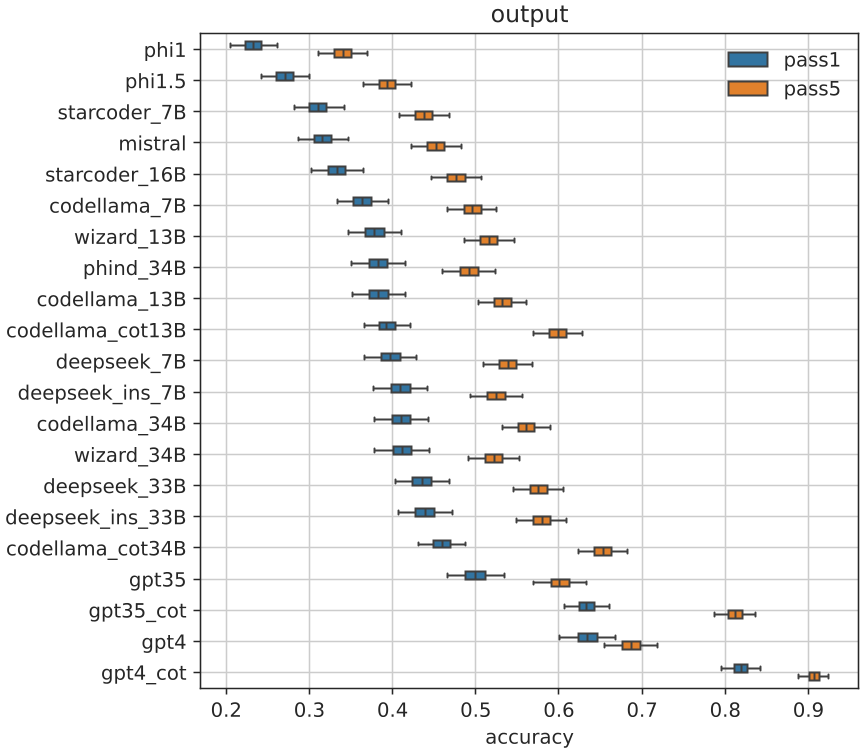
在对 20 个主流代码模型的评测中,结果令人警醒。
1. 性能断层
GPT-4 配合 CoT 的表现虽然大幅领先开源模型(领先近 30 个百分点),但距离“满分”依然遥远。更不可思议的是,GPT-4 会在一些极其简单的逻辑上翻车,例如无法正确判定 6173 < 1000 是否为真(它在长文中会产生数值认知的迷失)。
2. CoT 是双刃剑
虽然 CoT 对 GPT-4 提升显著,但对小模型和 GPT-3.5 来说,在 Input Prediction 任务上,开启 CoT 有时反而会导致性能下降。这是因为 CoT 引入了更多的思维链路,“想象”出的路径如果偏离了严格的解释器路径,会直接导致最终答案崩盘。
深度洞察:程序员的启示
论文揭示了一个深刻的观点:代码推理与代码生成的正相关性正在变弱。
- Tokenization 的原罪:许多失败案例归功于 LLM 对字符串的处理方式。例如,当函数涉及复杂的字符串切片或索引寻找时,模型往往会因为无法对齐索引而失败。
- 反向推理的难度:CRUXEval-I(输入预测)比正向预测更难,它考察的是模型是否理解代码的“逆元”,这种思维能力是高级调试(Debugging)和逆向工程的核心。
总结与未来展望
CRUXEval 不仅仅是一个数据集,它更是一面照妖镜。它告诉我们,目前的 AI 在面对确定性极强的计算机逻辑时,仍然带有一种不可解释的“模糊感”。
对于未来的研究,单靠扩大模型规模或单纯增加训练代码量可能无法填补这一鸿沟。我们需要探索更深度的 执行反馈(Execution Feedback) 学习机制,让模型在学习“怎么写”的同时,真正理解代码“怎么跑”。