
CAI Dataset:18TB 真实轨迹数据,开启网络安全 AI 的“自动驾驶”时代
Cybersecurity AI (CAI) Dataset
本文推出了 CAI Dataset,这是目前已知规模最大的网络安全大语言模型(LLM)轨迹数据集。该数据集包含 14 个月内收集的 23.1 万条会话日志和 2600.7 万个用户提示词,涵盖了真实的渗透测试、漏洞研究和工具调用过程。
TL;DR
本文介绍了 CAI Dataset —— 目前全球最大的网络安全 LLM 交互轨迹数据集。它不同于以往的静态问答对,而是记录了人类专家在 428 天内的真实“实战”全过程。通过 23 万条多轮会话和超 2600 万个 Prompt,CAI Dataset 为训练具备自动化渗透测试能力的专业模型提供了最核心的“燃料”。
痛点深挖:为什么 AI 懂网络安全知识,却不会搞渗透?
在网络安全领域,现有的数据集大多是“考试型”的。比如 CyberMetric 或 SecQA,它们考查的是模型是否记得某个 CVE 漏洞的原理。但在实战中,安全任务是高度动态的:一个渗透测试员需要扫描主机、解读扫描器报错、调整攻击载荷、最后尝试提权。
这种“行动-观察-修正”(Act-Observe-Revise)的逻辑链条在现有的 SFT 数据集中是缺失的。这就导致了目前的 LLM 往往是“懂王”而非“干将”:它们可以背诵防御手册,却无法在复杂的 Shell 循环中完成闭环任务。
核心贡献:把“黑盒”里的专家操作数字化
作者团队通过 CAI 代理框架,在长达 14 个月的时间里,静默且合规地收集了全球安全从业者的真实操作数据。这不仅仅是数据量的堆砌(18.07 TB),更是数据质量的飞跃:
- 实战真实性:包含了大量失败的命令、工具输出的误报解释、以及针对不同环境(IoT、移动端、内网)的策略调整。
- 多轮结构:平均每条轨迹包含 113 个 Prompt,远高于通用数据集(如 ADP 的 10.1 轮)。
- 模型多样性:记录了用户在 4187 个不同 LLM 标识符(包括最新的 GPT-5.5 预览版和 Claude 4 系列)上的 A/B 测试行为。
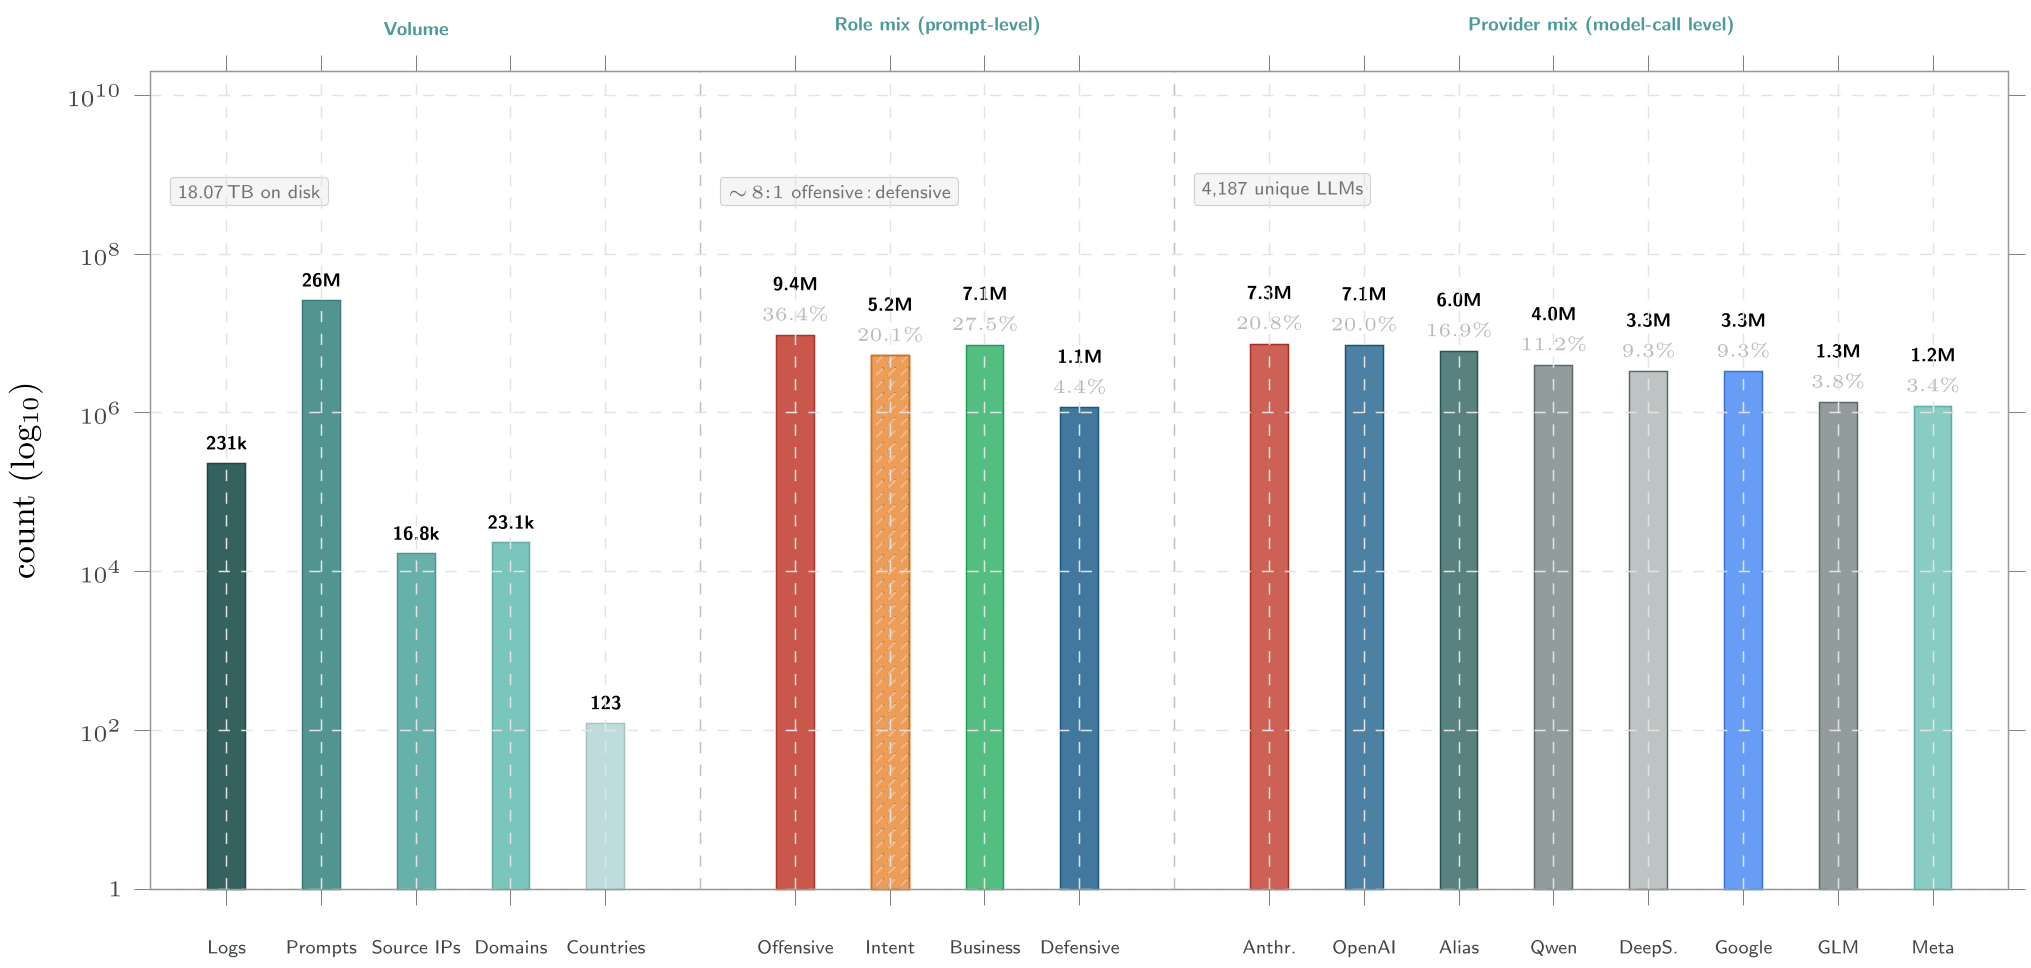 图 1:从卷量、角色分布到供应商分布,全方位展示了 CAI Dataset 的深度与广度。
方法论:如何转化 18TB 的原始日志?
为了防止模型由于学习单一框架的语法而产生 Harness-overfit(框架过拟合),作者提出了一套针对性的训练配方:
- 抽象动作记录:将所有轨迹投影到 ADP(Agent Data Protocol)兼容的动作记录中,消除特定 CLI 的语法痕迹。
- 多模板渲染:在训练时,将同一动作渲染为 JSON, XML, Markdown 等多种 Envelope 格式,提升模型的泛化能力。
- 逻辑推理注入:提取包含
<think>思考链的数据,利用 DeepSeek-R1 式的蒸馏方法,训练模型在执行命令前的推理能力。
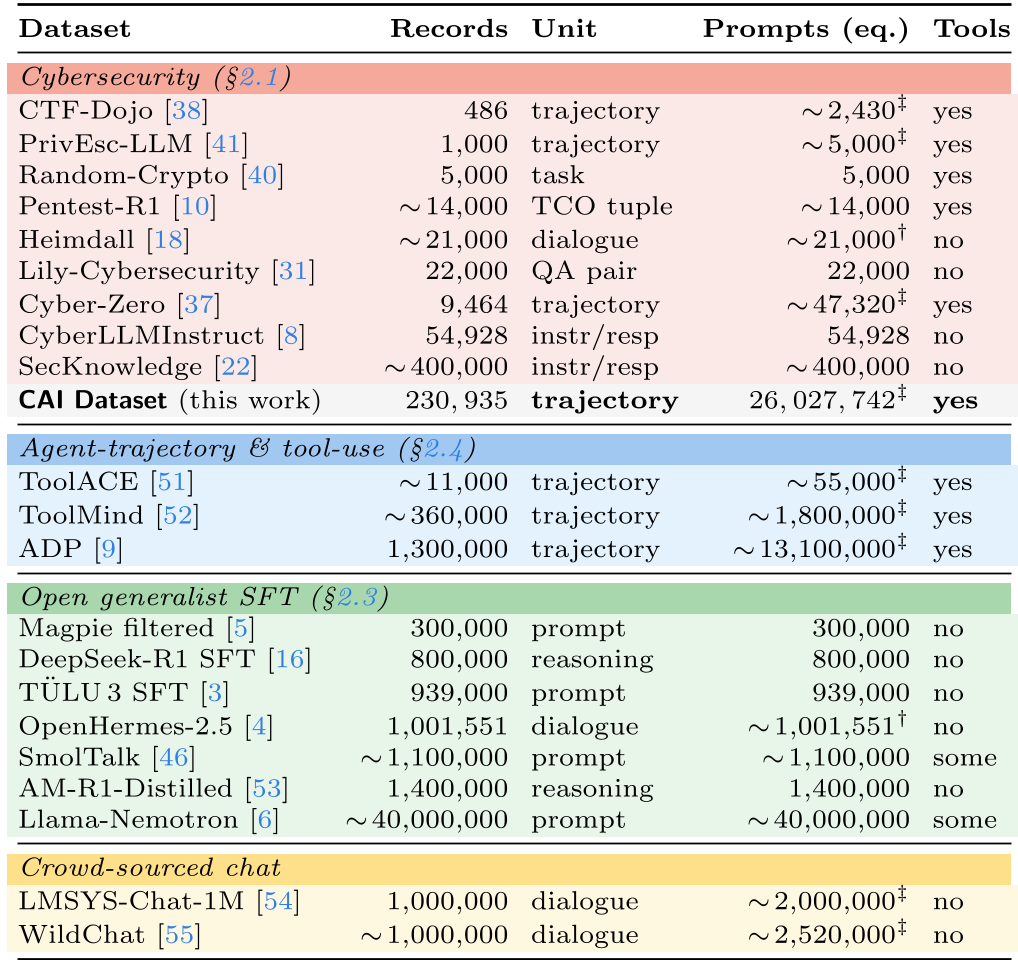 表 1:CAI Dataset 在 prompt 等效规模上远超现有的安全数据集。
实验结果与独到观察
通过对数据的初步扫描,作者发现了几个令人震惊的现象:
- 杀伤链自动化:某些轨迹显示,LLM 辅助的代理可以在不到 2 小时内完成从“GraphQL 探测”到“Kubernetes 权限提升”再到“数据外泄”的全链路攻击。
- 凭据泄露风险:0.46% 的会话中,用户直接将
ANTHROPIC_API_KEY或 GitHub PAT 等真实密钥粘贴进了 Prompt。这反映出 LLM 正在深度集成进生产环境,但也带来了巨大的隐私风险。 - CVE 战绩:尽管漏洞日新月异,但在实战中,2017 年的 WebLogic 反序列化漏洞和 2019 年的 Kubernetes 漏洞依然是 LLM 辅助攻击者的“心头好”。
深度洞察:安全 AI 的未来在“本地化”
作者在文章末尾提出了一个振聋发聩的观点:网络安全 AI 的终局是 On-premise(私有化部署)。
既然真实的渗透测试需要将内网主机名、S3 存储桶、甚至 Bearer Token 交给模型处理,那么依赖第三方 API 供应商就会造成不可接受的“集中式失败风险”。CAI Dataset 的发布,本质上是为那些希望在隐私边界内训练“比肩 GPT-4 级安全专家”的企业提供了必不可少的原材料。
总结
CAI Dataset 不仅仅是一个数据集,它是对未来自动化网络安全作战的一次大规模预演。它告诉我们,AI 安全的胜负手不在于谁的模型参数更多,而在于谁更懂真实世界的攻击者是如何思考和纠错的。
局限性分析:尽管规模庞大,但数据集存在由于地域来源(如西班牙 IP 识别偏向)导致的 Source Skew 风险,且网络安全数据的双重用途(Dual-use)特性要求访问权限必须受到严格审计。