
DarKnight:解锁 TEE-GPU 协同训练,兼顾隐私与极致性能
DarKnight: An accelerated framework for privacy and integrity preserving deep learning using trusted hardware
本文提出了 DarKnight,一个结合可信执行环境 (TEE) 与 GPU 加速器的深度学习框架,旨在解决大规模 DNN 训练中的隐私保护与计算完整性验证问题。该方法通过在 TEE 内进行矩阵掩码(Matrix Masking)编码,将计算密集型的线性操作外包给不可信的 GPU,从而在保证数据隐私的同时实现平均 65 倍的性能提升。
TL;DR
在云端进行 AI 训练时,数据隐私与算力需求之间总是存在天然的矛盾。DarKnight 提出了一个巧妙的框架:将受保护的 TEE(Intel SGX)作为“指挥官”,负责数据混淆与非线性运算;将廉价高效的 GPU 作为“劳动力”,在完全不接触原始数据的前提下完成海量线性计算。该方案突破了以往 SLALOM 等方法只能做推理的限制,将训练性能拉升了 65 倍。
背景:算法与硬件的“安全困境”
目前保护模型训练隐私主要有两条赛道:
- 纯算法路径(FHE, MPC):数学安全性极高,但计算开销大到令人绝望(通常慢 100~1000 倍)。
- 硬件路径(TEE/SGX):安全性由硬件电路保证,但 SGX 就像在高墙里办公,内存极小(128MB),且 CPU 算卷积简直是灾难。
DarKnight 的动机非常明确:能不能把 GPU 拉进 TEE 的安全阵营? 既然不能直接让 GPU 变安全,那就让数据进 GPU 之前先变成“乱码”。
核心机制:矩阵掩码与双线性性质 (Methodology)
1. 数据的“分身术”:编码过程
DarKnight 并不直接将图片 x 发给 GPU。在 TEE 内部,它会通过以下公式生成一组编码数据 : 这里, 是 TEE 生成的随机噪声。通过这种方式,GPU 看到的每一组数据在数学上都是独立同分布的“杂讯”,满足 One-Time Pad 般的完美隐私保障。
2. 利用“双线性”实现盲计算
为什么 GPU 算“乱码”还有意义?核心在于卷积和矩阵乘法具有双线性性质。 GPU 计算完 后返回结果,TEE 利用手中保留的解码系数 轻轻一拨,就能在极小的开销下还原出真实的计算结果 。
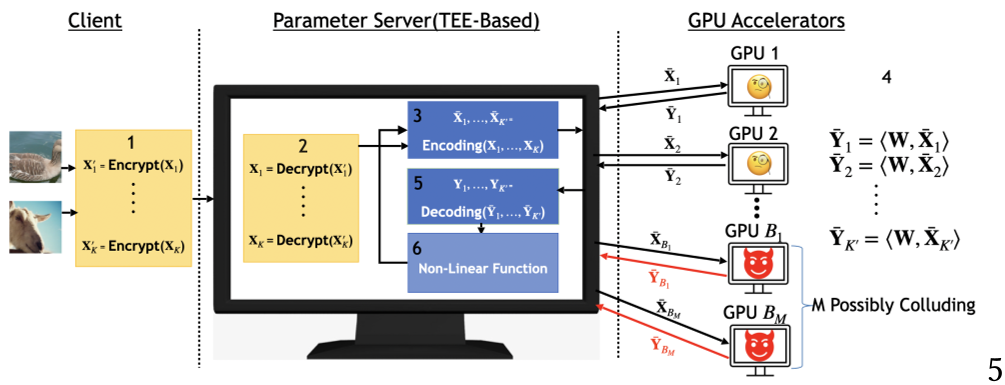 图 1:DarKnight 整体协同流图,展示了 TEE 编码、GPU 计算、TEE 解码的闭环。
3. 反向传播的“长治久安”
相比于前人工作 Slalom,DarKnight 最大的贡献是支持训练。在训练中,权重 每一轮都在变。DarKnight 设计了一套累积梯度更新机制,不需要在 TEE 里预计算复杂的辅助项,而是直接对虚拟批次进行线性聚合,完美解决了训练状态同步的难题。
实验战绩 (Experiments & Results)
作者在 VGG16、ResNet50 等复杂模型上进行了严格测试。
- 加速效果:在 Pipelined 模式下(即 GPU 计算的同时 TEE 准备下一组数据),性能提升触目惊心。对于线性操作密集的 VGG16,甚至达到了百倍级的算力释放。
- 完整性保护:通过冗余方程注入,DarKnight 能够以极低的代价检测 GPU 是否在计算中“偷工减料”或恶意攻击。
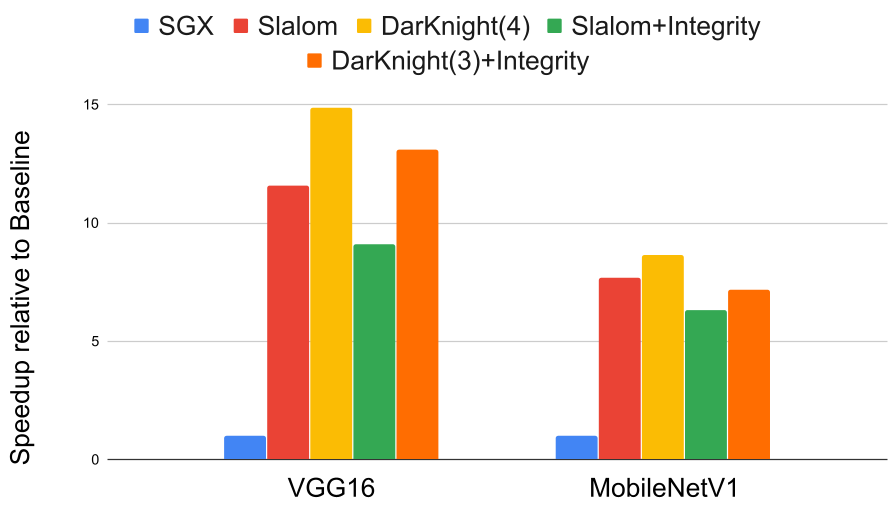 图 2:不同模型、不同配置下的推理与训练加速对比。
深度洞察
DarKnight 的成功在于它深刻理解了深度学习的数学特性——计算密集的线性部分可以用线性掩码保护,逻辑复杂的非线性部分(如 ReLU, Maxpool)虽然难掩码,但计算量小,留在 CPU 执行绰绰有余。
局限性与挑战
- 通信开销:由于编码后的数据体积增大(K+1 策略),对 PCI-E 链路或网络带宽提出了更高要求。
- 侧信道风险:虽然文章声明侧信道攻击不在讨论范围内,但频繁的 TEE-GPU 内存交换仍可能泄露模型结构信息。
总结
DarKnight 为隐私计算提供了一个极具工业价值的范式:不追求硬件的全能化,而是通过算法层面的混淆,让性能强悍但不可信的外部硬件为安全核心服务。 这对于未来基于云端的隐私保护机器学习服务(MLaaS)具有重大的启示意义。