
破译竞争背后的动机:基于熵正则化的逆博弈论推断
Decoding Rewards in Competitive Games: Inverse Game Theory with Entropy Regularization
本文提出了一个针对两人零和博弈(矩阵博弈与马尔可夫博弈)的逆博弈论(Inverse Game Theory)统一框架。核心方法是利用带熵正则化的量子响应均衡(Quantal Response Equilibrium, QRE)来推导奖励函数的识别条件,并开发了在静态和动态环境下均能从观测策略中恢复奖励参数的离线算法。
TL;DR
在博弈论中,“知道对手想要什么”比“知道对手在做什么”更重要。本文提出了一种全新的逆博弈分析框架,通过观测两人零和博弈中的行为数据,反向推导出支撑这些行为的奖励函数(Reward Function)。即使在数据分布不完全或奖励函数不唯一的情况下,该方法也能通过构造“可行奖励集”实现稳健的行为预测。
背景:为何“逆博弈”如此困难?
传统的强化学习(RL)是给定奖励求最优策略,而逆强化学习(IRL)则是给定策略求奖励。在竞争性博弈中,问题的复杂性呈指数级增长:
- 策略耦合:选手的行为不仅取决于自己的偏好,还取决于对对手反应的预期。
- 病态不唯一性 (Identifiability):许多不同的奖励函数可能导致相同的纳什均衡。
- 数据稀疏:在现实的离线场景中,我们很难观察到选手在所有可能状态下的所有反应。
核心直觉:熵正则化与QRE
为了解决这一挑战,作者引入了熵正则化(Entropy Regularization)。在传统的纳什均衡中,选手总是采取绝对最优动作,这会导致策略函数的导数不连续,难以反推。
引入熵正则化后,选手的行为模型从“绝对理性”转向了“受限理性”,即量子响应均衡(Quantal Response Equilibrium, QRE)。在QRE下,选手以更高的概率选择高奖励动作,但也会以较小概率尝试其他动作。这种平滑性使得奖励函数与观测概率之间建立了一套可求导的线性映射关系。
方法论详解:从矩阵到马尔可夫
1. 静态矩阵博弈 (Matrix Games)
作者通过将QRE的固定点方程取对数,成功将其转化为了一个线性方程组: 这使得判断奖励是否唯一确定(Strong Identifiability)简化为了判断特征矩阵是否满秩。
2. 动态马尔可夫博弈 (Markov Games)
在动态场景下,奖励不仅取决于当前动作,还涉及对未来价值的期望。作者提出了 Algorithm 2 / 3,其核心流程如下:
- 策略估计:利用频率估计或 MLE 从数据中恢复选手的 QRE 策略。
- 转移模型推断:通过岭回归(Ridge Regression)估计环境的动力学。
- 递归恢复:利用贝尔曼方程(Bellman Equation)倒序迭代恢复每一步的奖励函数。
(此处应展示论文中关于马尔可夫博弈奖励恢复的递归流程示意图)
实验战绩
实验在两种设定下展开:
- 强识别设定:参数 唯一。结果显示重构误差随样本量增加呈现完美的收敛曲线。
- 部分识别设定:存在多个奖励方案。此时虽然参数不能完全对齐真实值,但算法找到的“等效奖励”生成的行为策略与真实策略完全一致。
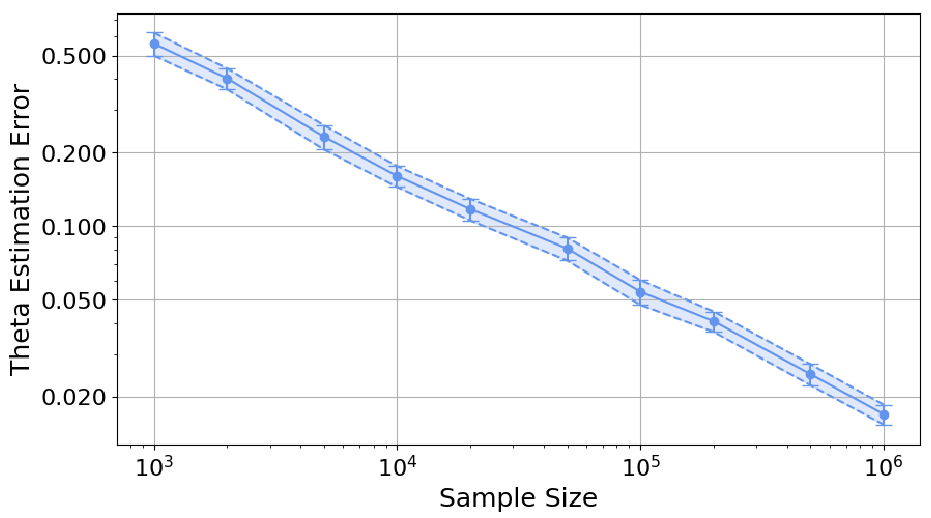 图:在 Setup I (a, c, e) 中,参数与奖励均能完美收敛;在 Setup II (b, d, f) 中,即使参数不唯一,策略误差依然收敛。
深度洞察:部分识别的价值
这篇文章最深刻的贡献在于对“无法识别”问题的坦诚与处理。在实际工业应用(如定价博弈或网络攻击防御)中,我们往往不需要知道唯一的奖励数值,只需要知道在给定观测范围内的可行奖励区间。作者通过Hausdorff 距离证明了其构造的“置信集”能以 的速率逼近真实的可行奖励空间,这为后续的风险评估提供了极大的理论空间。
总结与局限
本文为逆博弈论提供了一套数学上严密且计算上高效的工具包。其局限性主要在于对线性结构的依赖(Assumption 3.3)。在神经网络高度普及的今天,如何将该框架扩展到非线性函数近似器(如深度神经网络)将是未来的重要研究方向。
关键词:Inverse Game Theory, QRE, Entropy Regularization, Markov Games, identifiability.