
深度学习赋能:压缩视频质量增强的技术演进与未来视野
A Survey of Deep-Learning-Based Compressed Video Quality Enhancement
本文是一篇关于基于深度学习的压缩视频质量增强(CVQE)的综述,涵盖了从 ARCNN 到最新 Transformer 架构的发展历程。文章系统分类了帧内(Intra-frame)和帧间(Inter-frame)增强方法,并深入探讨了针对屏幕内容、360度视频等特定领域的优化策略。
核心速览 (Executive Summary)
随着数字媒体爆炸式增长,视频压缩通过牺牲高频细节换取带宽。压缩视频质量增强 (Compressed Video Quality Enhancement, CVQE) 的目标是修复这种“有损性”。本文综述了从 2015 年 ARCNN 开启的 CNN 时代到如今 Transformer 与生成式模型并存的学术版图。
该工作不仅系统化地梳理了技术脉络,更深刻分析了运动对齐 (Motion Alignment) 与感知质量 (Perceptual Quality) 之间的博弈,是该领域从学术探索迈向工业级应用的重要参考。
痛点深挖:为什么传统滤波不够用了?
传统的视频编码标准(如 HEVC, VVC)虽然内置了环内滤波(In-loop Filter),但存在三个致命伤:
- 启发式预测的局限:人工设计的滤波器难以泛化到复杂场景,在高压缩率下容易产生过度平滑。
- 时域信息浪费:传统方法多关注单块或单帧,难以通过多帧间的冗余信息来“还原”某一帧丢失的细节。
- 硬同步需求:必须在编码端和解码端同时更改协议,无法直接增强已有的旧视频资源。
方法论详解:从单帧修复到时空融合
深度学习方法的崛起,本质上是将修复问题转化为一个条件生成的优化问题。
1. 帧内增强:从浅层到深层
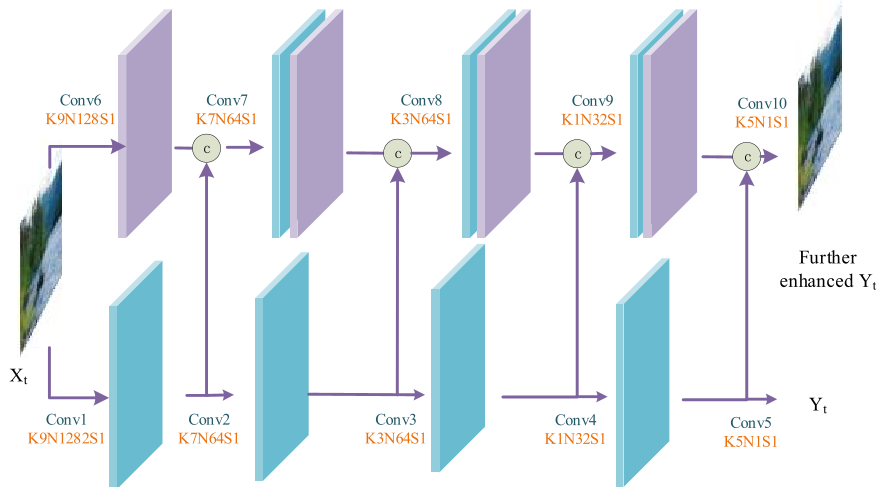
早期的 ARCNN 借鉴了超分辨率的思想,通过简单的 4 层 CNN 学习压缩噪声的分布。而现代的 GL-Fusion(如下图)则引入了双分支架构:一个分支捕获全局纹理特征,另一个分支专注于修复局部的块效应。
2. 帧间对齐:CVQE 的天花板
视频增强的核心难点在于 Alignment。如果不能精准对齐,多帧信息反而会引入模糊(Ghosting)。
- 光流对齐 (Optical Flow):如 TOFlow,显示地估计像素偏移,但对噪声极其敏感。
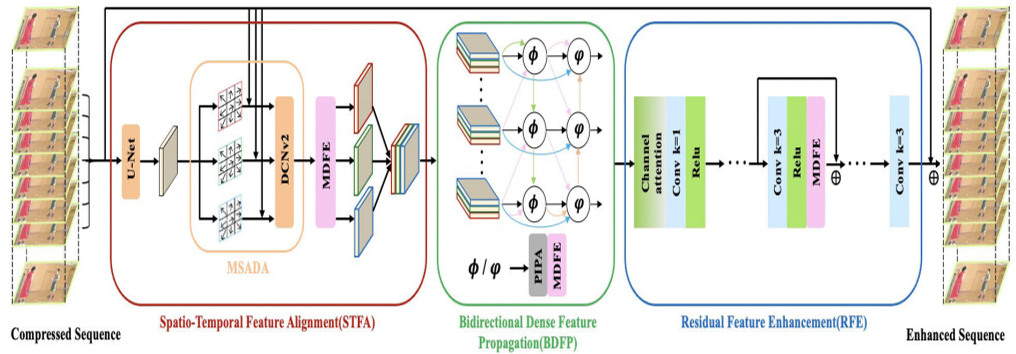
- 可变形对齐 (Deformable Alignment):如 STDF 和 EMAFA(如下图)。它通过学习偏移量 (Offsets),让卷积核形状动态贴合运动物体的轮廓,这对于形状不规则的压缩伪影修复具有奇效。
实验与结果:SOTA 战力榜
论文通过大规模实验对比显示,基于 Transformer 和可变形卷积的方法(如 BasicVSR++, RFDA)在 BD-rate(等质量下的比特率节省)上取得了压倒性胜利。
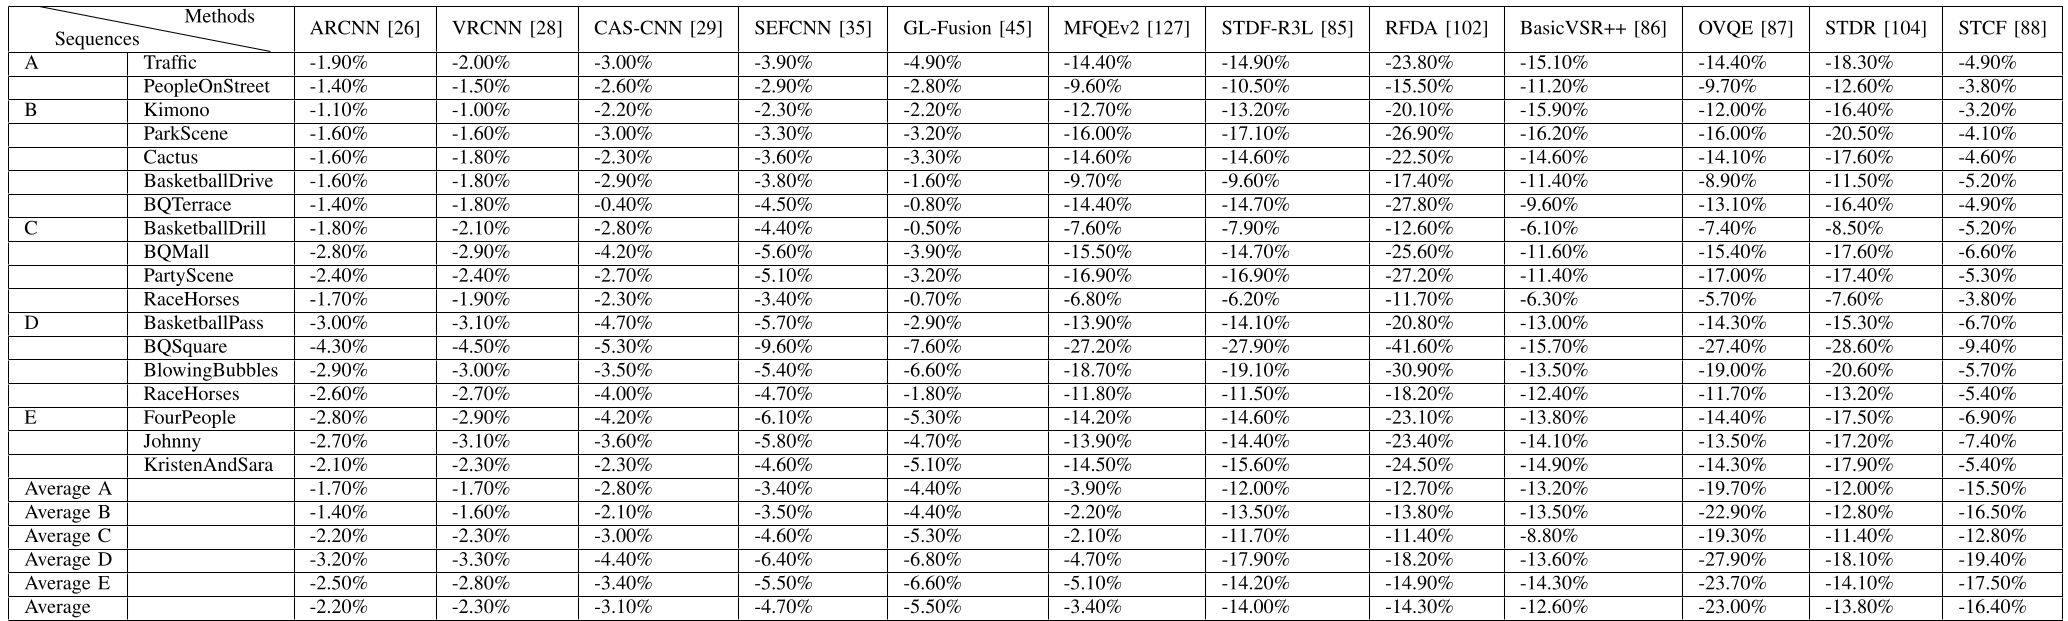
- 关键数据:在强压缩(QP=37)下,最强的模型能实现平均 16.4% 至 23% 的 BD-rate 增益。这意味着在相同的主观质量下,你可以节省近四分之一的存储空间。
- 局限性:高精度的对齐往往伴随着恐怖的计算成本(GFLOPs 动辄上千),这使得实时在线增强仍是一个待解的难题。
深度洞察:未来的三个风向标
- 压缩域增强 (Compressed Domain Early Exit):不再等视频解码完再增强,而是直接利用码流里的残差(Residuals)和运动矢量(MV)作为指导。
- 生成式 AI 的引入:利用 Diffusion Models 的强大先验,在极低比特率(仅剩色块)的情况下,“脑补”出真实的毛发和皮肤纹理。
- 语义感知 QA:结合大语言模型(LLM)理解视频内容,优先增强人类视觉关注的 ROI (Region of Interest) 区域,而非像老方法那样暴力计算全帧。
总结
CVQE 领域正处于从“能用”到“好用”的跨越期。虽然目前学术界在 PSNR 指标上已近瓶颈,但如何能在移动端低功耗地跑通 SOTA 架构,以及如何利用生成式模型解决极端毁坏情况下的修复,依然是未来五年的技术高地。