
DRL 邂逅 GNN:突破自驱动网络路由泛化的“最后一公里”
Deep reinforcement learning meets graph neural networks: Exploring a routing optimization use case
本文提出了一个集成图神经网络 (GNN) 的深度强化学习 (DRL) 架构,专门用于解决光传输网络 (OTN) 中的路由优化问题。通过引入基于消息传递神经网络 (MPNN) 的拓扑无关模型,该方案在 180 个合成拓扑和 232 个真实拓扑上实现了强大的零样本泛化能力。
TL;DR
传统的深度强化学习(DRL)在网络路由任务中虽然表现出色,但往往存在“拓扑依赖”的通病——一旦换个网络环境就失效。本文通过引入图神经网络(GNN),构建了一个具备拓扑感知能力的路由代理,实现了在完全未见过的真实网络拓扑上的零样本泛化(Zero-shot Generalization),且推理时间保持在毫秒级。
背景定位:为何 DRL 难以走出实验室?
在自驱动网络(Self-driving Networks)的愿景中,DRL 被寄予厚望。然而,工业界的真实阻碍在于:训练成本极高且风险大。你不能在一个正在运行的运营商核心网上通过随机探索来训练模型。
目前的主流做法是在仿真环境中训练,然后部署。但现有的模型多采用多层感知机(MLP)或卷积神经网络(CNN),它们将网络状态视为平铺的向量。这种做法丢失了网络最本质的属性:图结构(Graph Structure)。当拓扑发生细微变化(如掉了一根光纤或增加了一个节点),输入向量的维度或语义就会错位,导致模型彻底崩溃。
核心直觉:将路由视为一种“消息传递”
作者认为,网络路由的本质是链路(Links)之间的资源竞争与协作。为此,他们设计了一个基于 Message Passing Neural Networks (MPNN) 的 DRL 架构。
1. 状态与动作的图编码
不同于前人直接输入流量矩阵,作者将链路作为图的实体。每个链路的隐藏状态 初始化为:
- 剩余带宽(Available Capacity)
- 链路介数(Betweenness):衡量链路重要性的拓扑指标
- 动作特征:如果选择某条路径,该链路上新占据的带宽
2. 消息传递机制
在每一轮迭代中,链路节点会从相邻链路接收“消息”,并利用循环神经网络(RNN/GRU)更新自己的状态。
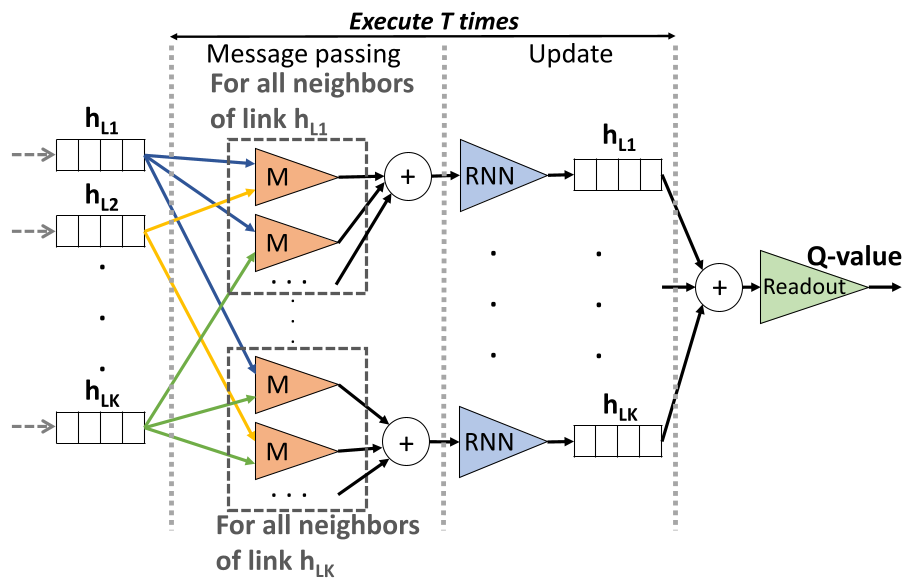
这种机制的物理含义在于:通过 次迭代,每个链路都能感知到 跳之外的资源压力。 最终,所有链路的状态被聚合(Readout)为一个全局向量,映射为该路由决策的 Q 值。
实验战绩:降维打击 SOTA
作者在 Nsfnet(14 节点)上训练,直接在 Geant2(24 节点)及 200 多个真实世界拓扑上进行测试。
- 泛化性能:相比于基于传统神经网络的 SOTA 方案,DRL+GNN 在未知拓扑上的带宽分配能力提升了 45% 以上。
- 容灾能力:即便在网络中随机切断多达 10 条链路,GNN 代理依然能快速适应,表现稳健。
- 扩展性:推理延迟随节点数线性增长,对于 100 节点的网络,决策时间依然维持在毫秒级别,完全满足实时路由需求。
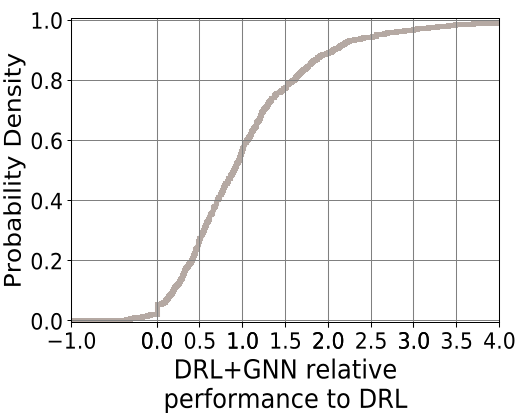 上图展示了在不同拓扑下,DRL+GNN 相较于状态最先进方案的压倒性优势。
深度洞察:为什么 GNN 真的有用?
GNN 之所以能在此任务中胜出,是因为它引入了强归纳偏置。传统的 MLP 需要学习“节点 A 与节点 B 的关系”,而 GNN 学习的是“节点与其邻居之间局部交互的通用模式”。这种模式在任何图中都是通用的。
局限性分析: 尽管表现强异,作者也坦诚了其局限:
- 黑盒属性:虽然性能好,但路由策略难以被网络管理员解释(Explainability)。
- 分布偏移:当评估拓扑的平均度和介数与训练集差异过大时,性能仍会出现一定程度的退化。
总结与启示
这篇论文为 DRL 在通信领域的应用指明了方向:不要试图用通用的深度学习架构去套特定的网络问题,而应该根据问题的图论本质定制架构。 这种“结构化”的强化学习,才是构建真正通用、可部署的“网络大脑”的关键。