
Think Deep, Not Just Long:超越长度,用“深度思考 Token”量化 LLM 推理直觉
Think Deep, Not Just Long: Measuring LLM Reasoning Effort via Deep-Thinking Tokens
本文提出了深度思考率(Deep-Thinking Ratio, DTR),一种通过监测大模型在推理过程中 Token 生成时的层级收敛深度来衡量推理质量的新指标。实验证明,DTR 在数学和科学推理任务(如 AIME, GPQA)中与准确率展现出极强的正相关性,显著优于传统的 Token 长度或置信度指标。
TL;DR
在 LLM 推理领域,我们长期陷入了“输出越长,推理越强”的迷思。然而,Google 与 UVa 的这篇最新力作给予了有力反击:真正决定推理质量的是模型内部的“纠结程度”,而非表面的字数。 作者提出的 Deep-Thinking Ratio (DTR) 指标通过监测 Token 在模型深层的预测稳定性,精准捕捉到了模型真正的推理努力。基于此的 Think@n 策略,在 AIME 竞赛级数学题上,仅用一半的算力就跑赢了昂贵的 Self-Consistency 方案。
背景定位:走出“长等于好”的陷阱
最近一年,OpenAI o1 系列带火了测试时计算(Test-time Compute)缩放。大家普遍认为,给模型更多的时间/Token 去生成思维链(CoT),准确率就会提升。但在实际应用中,我们常观察到 “过度思考(Overthinking)” 现象:模型写了几千个 Token,最后却在简单的自洽逻辑里翻车,甚至因为一步错步步错导致性能退化。
现有研究在衡量推理努力时,大多使用 Token 计数。但这篇论文明确指出:Token 计数是一个极不稳定的代理指标(相关系数 r = -0.544 甚至呈负相关!)。
核心洞察:从“预测稳定性”看思考深度
作者提出了一个直觉:
- 浅层思考(Easy Tokens):一些功能性词汇(如 "the", "and")或简单的模板化推理,在模型的早期 Transformer 层就已经确定了预测分布,后续深层只是在做数值微调。
- 深层思考(Deep-Thinking Tokens):对于复杂的逻辑推导或关键数值计算,模型需要在通过几乎所有计算层后,预测分布才会发生剧烈变化并最终收敛。
DTR 是如何计算的?
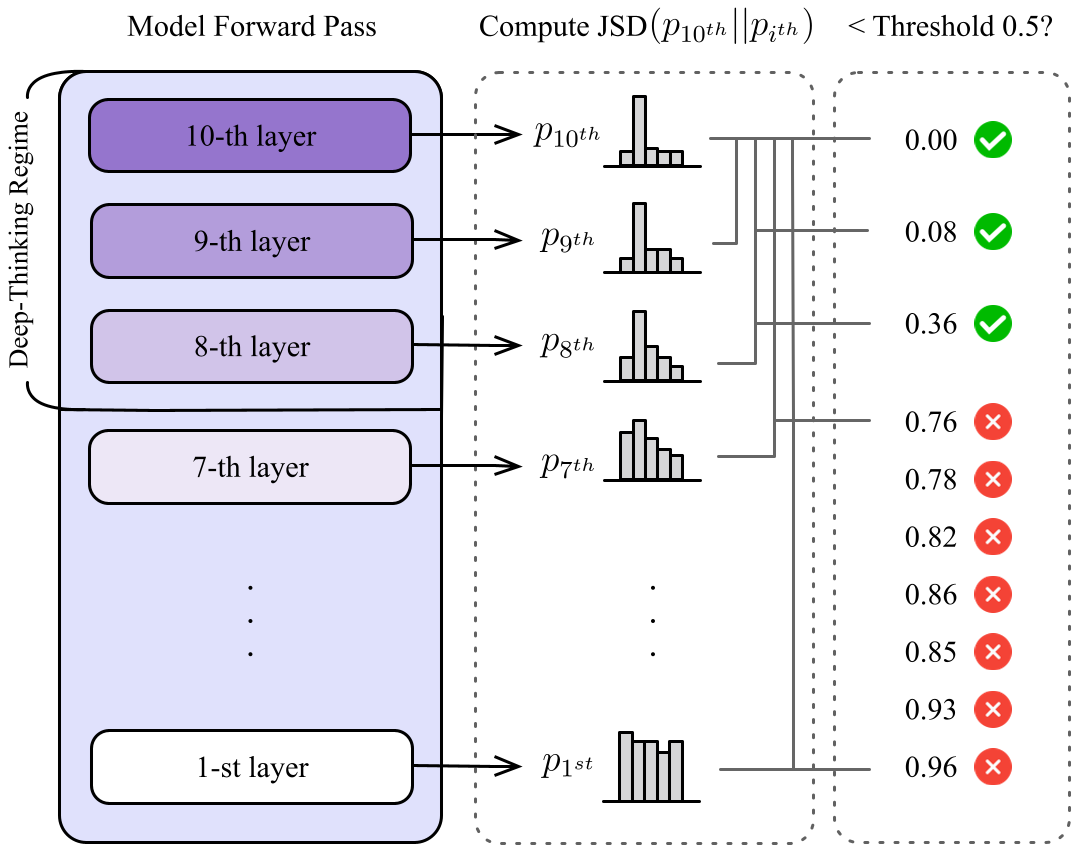
- Logit Lens 投影:在推理的每一步,将每一层的隐藏状态通过 Unembedding 矩阵映射回词表。
- 分布差异测量:计算每一层预测分布与最后一层最终输出分布之间的 Jensen–Shannon 散度(JSD)。
- 确定收敛点:如果一个 Token 的预测直到很深的层(例如总层数的 85% 之后)才与最终结果趋同,它就被打上“Deep-thinking”的标签。
- 比例计算:DTR = 深思 Token 数 / 总 Token 数。
实验结果:DTR 统治了相关性分析
研究团队在 AIME 2024/2025、GPQA-Diamond 等顶级硬件/数学挑战集上,对 GPT-OSS, DeepSeek-R1 和 Qwen3 进行了广泛测试。
- 相关性飞跃:DTR 与准确率的相关性均值达到了 0.828,而传统的 Token 计数在很多模型上表现出了明显的负相关(越长越差)。
- 可视化证据:在热图分析中可以发现,简单的连接词在第 5-10 层就收敛了,而关键的解题步骤和最终数值答案,往往在最后几层才发生“预测坍缩”。
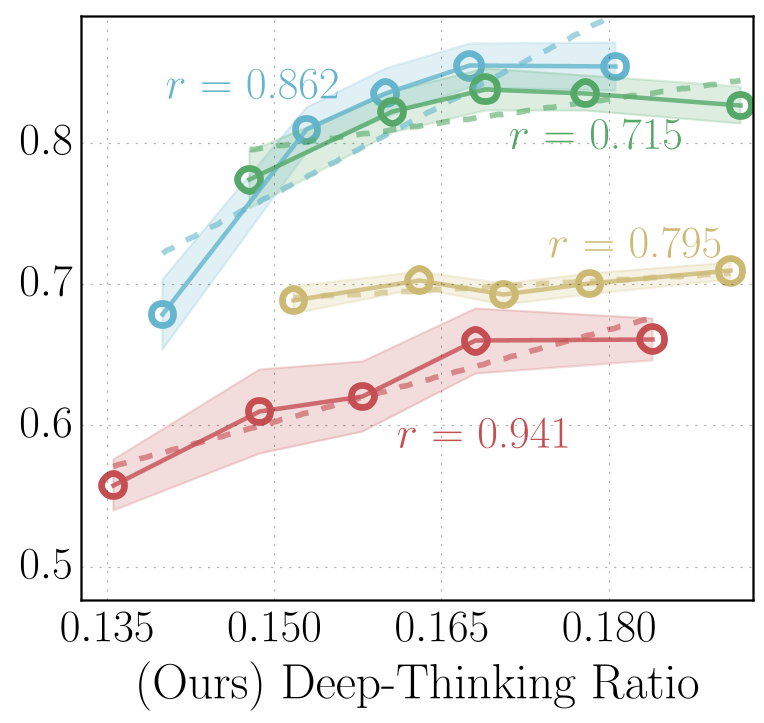 左图:Token 长度与准确率的混乱关系;右图:DTR 与准确率的清晰正相关。
工程价值:Think@n 助力低成本推理缩放
基于 DTR,作者开发了一个极为实用的推理策略 Think@n: 在并行采样多个答案时,我们不需要等所有答案都生成完。模型只需生成前 50 个 Token 的 前缀 (Prefix),我们就能估算出该路径的 DTR 指数。
- 效率革命:优先继续生成 DTR 高的路径,直接掐掉(Early Stopping)那些表面字数多但“思维肤浅”的路径。
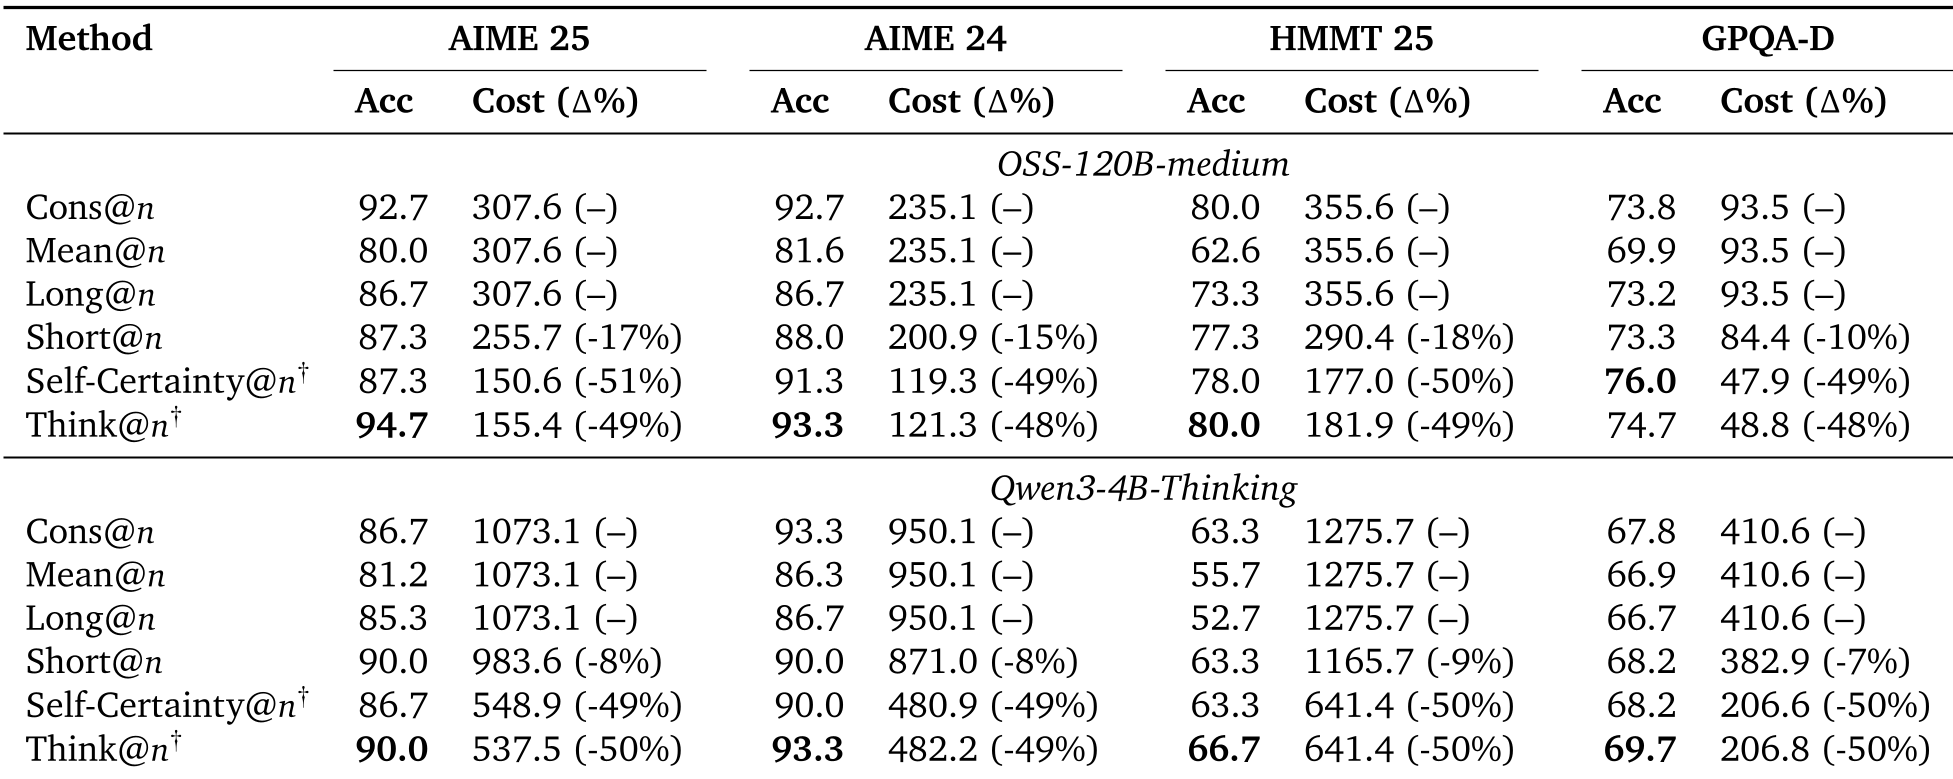
- 战绩:在 AIME 25 任务上,Think@n 仅消耗了 Cons@n(标准投票法)约 51% 的 Token,但准确率却从 92.7% 提升到了 94.7%。
深度洞察与总结
这篇论文的意义在于,它将对 LLM 推理的理解从外部的文本表象引向了内部的动力学特征。
- 推理的本质是计算量的垂直分配:长篇大论不代表思考,真正的推理是模型在模型深层对信息进行的“高强度重构”。
- 打破过拟合长度的死循环:通过 DTR,我们现在有了一个不依赖长度的、纯内源性的信号来监控模型是否在“胡言乱语”。
- 局限性:DTR 依赖于对中间层 Logits 的访问,这对于目前的闭源 API(如 GPT-4, Claude 3.5)来说需要厂商提供专门的接口(如 Logprobs 扩展)才能实现。
总结一句话:不要问你的模型能写多长,要问它在深层网络里纠结了多久。