
Deeper or Wider? 基于 Sobolev 损失的最优泛化误差视角
Deeper or Wider: A Perspective from Optimal Generalization Error with Sobolev Loss
2024-01-01
总结
问题
方法
结果
要点
摘要
本文探讨了深度神经网络 (DeNN) 与宽度神经网络 (WeNN) 在 Sobolev 损失函数下的最优泛化误差对比。研究建立了一套理论框架,证明了在参数量相同的情况下,网络架构的选择取决于样本量和损失函数的正则性。该理论被成功应用于 Deep Ritz 和 PINN 方法解决偏微分方程 (PDE) 的实验中。
TL;DR
在神经网络设计中,“深而窄”还是“浅而宽”是一个永恒的博弈。本文从数学层面给出了定论:在 Sobolev 训练(即损失函数包含导数项)背景下,泛化性能由样本量、参数量和损失函数正则性三者共同决定。简单来说:样本多、处理高阶导数时选深网;样本少、参数管够时选宽网。
背景定位
本文属于深度学习理论(DL Theory)中的泛化性研究。其核心贡献在于打破了先前研究对深度网络参数必须“统一有界”的假设,利用针对 DeNN 及其导数的伪维度分析,填补了 Sobolev 空间下长深网络泛化界限的空白。
痛点深挖:为什么 DeNN 的泛化很难分析?
- 超收敛的代价:DeNN 可以通过复杂的函数复合实现超收敛(Super-convergence),但这通常需要网络参数值变得很大(Bit Extraction 机制)。
- 导数复杂性:当损失函数涉及 或 范数(如 PINN 方法)时,神经网络的导数空间复杂度由于链式法则呈爆炸式增长,难以用传统的 Rademacher 复杂度直接刻画。
方法论详解:泛化误差的“天平”
作者将泛化误差分解为:
- 逼近误差 (Approximation Error):模型能达到的精度上限。DeNN 具有指数级的逼近优势。
- 采样误差 (Sampling Error):模型在有限样本上的过拟合风险。DeNN 结构精巧,采样误差通常随深度增加而波动。
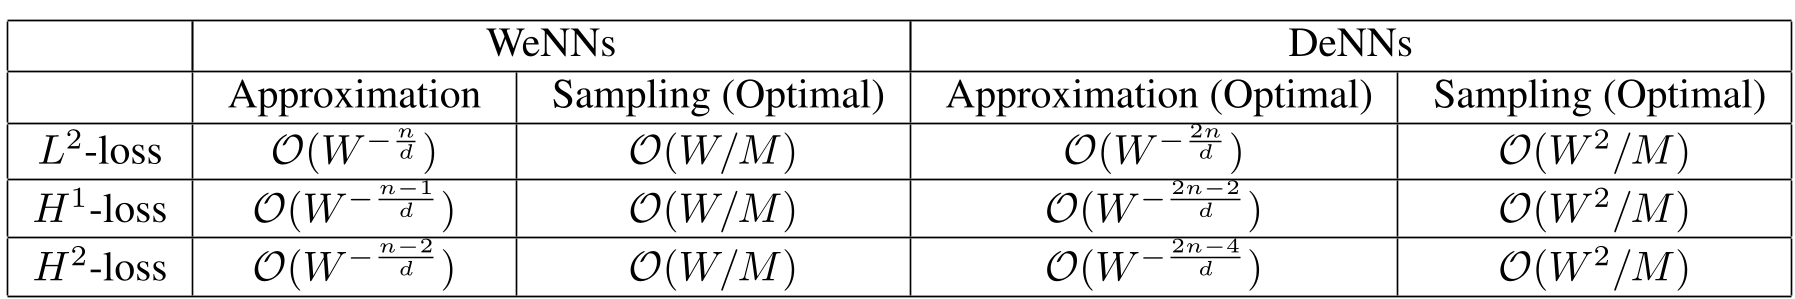
从上表可见,DeNN 在逼近误差上具有更高的阶数( 对比 ),这为其在处理复杂科学计算任务时提供了物理直觉层面的支撑。
核心发现:性能临界点
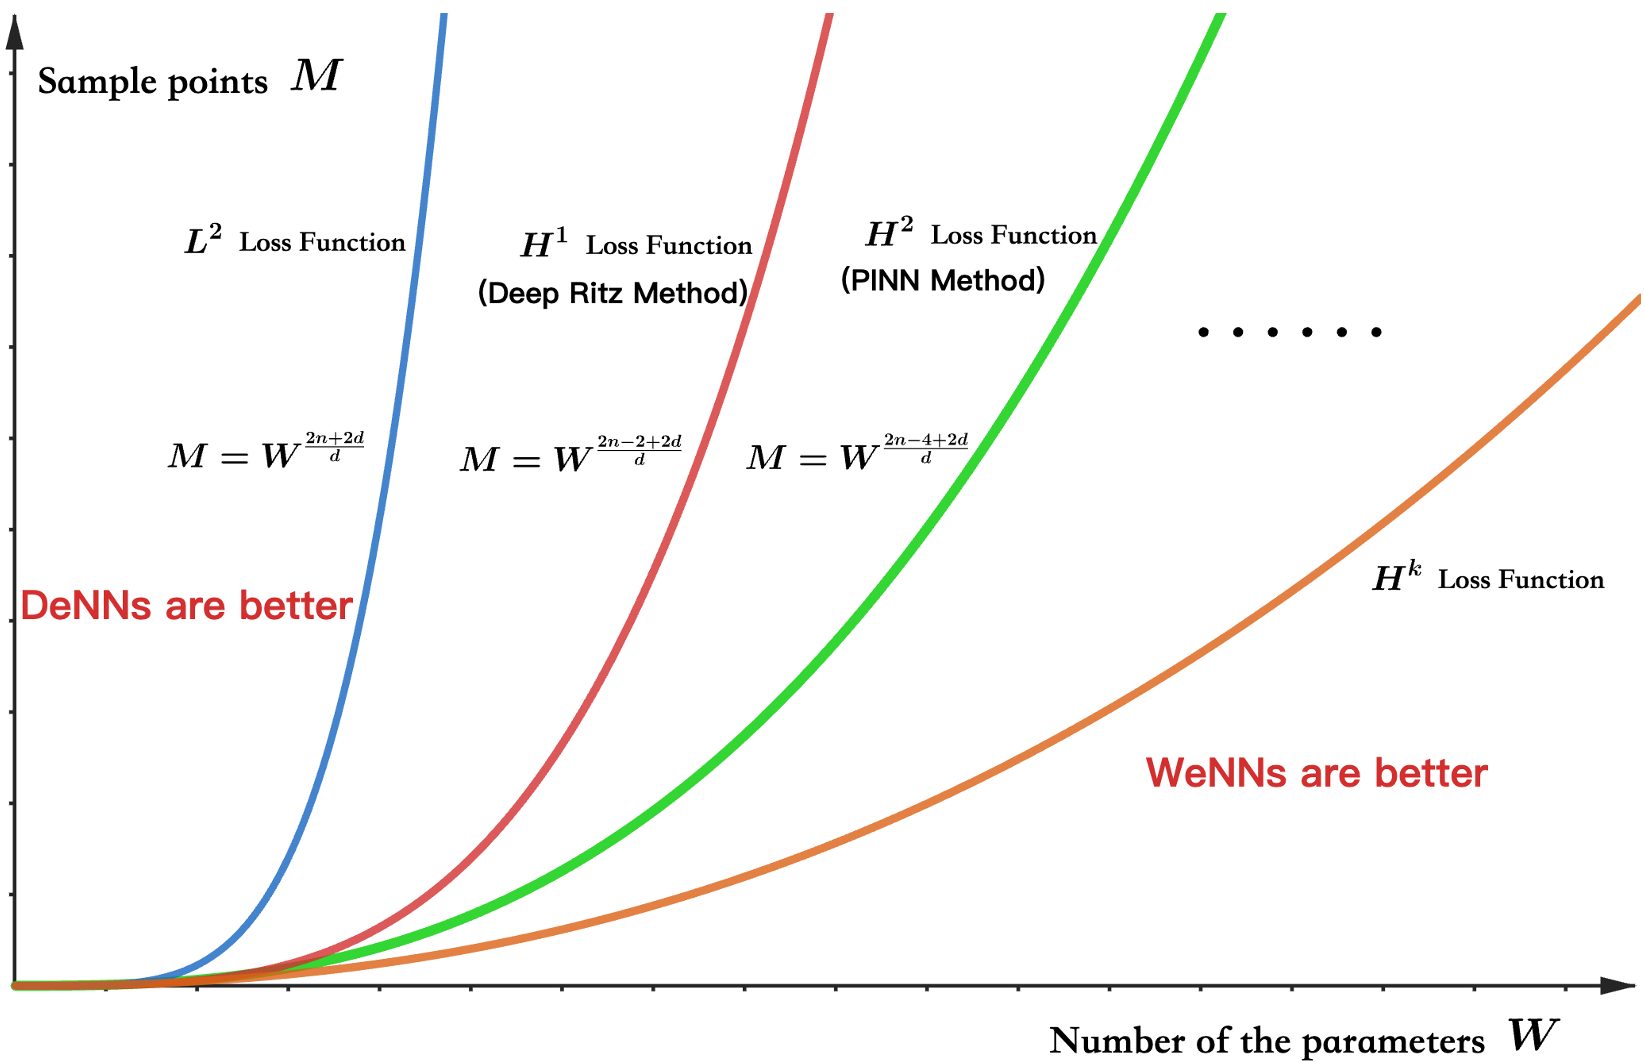
研究发现存在一个由 决定的临界曲线。
- 损失下:WeNN 适合小数据;
- 损失下:随着 (导数阶数)增大,DeNN 的优势区域(蓝色曲线左侧)不断向右侧扩张。这意味着损失函数越“硬”(正则性要求越高),深度网络越划算。
实验验证:PINN 与 Deep Ritz
在求解 Poisson 方程的实验中,作者对比了浅层宽网络(深度 1,宽度 20)与深层窄网络(深度 4,宽度 10)。
- 大数据量 (Large Data):深层网络胜出,测试误差从 6.18e-4 降至 3.69e-4。
- 小数据量 (Small Data):宽网络更稳,因为深层网络在样本不足时采样误差激增。
深度洞察与总结
Takeaway:
- AI for Science 的直觉:在开发 PINN 或物理约束模型时,如果计算资源有限(参数 固定),首先应通过增加深度而非宽度来消耗资源。
- 局限性:本文主要讨论的是欠参数化(Under-parameterized)情况。在当前主流的超参数化(Over-parameterized)体制下,深度与宽度的泛化特性可能会受到神经切向量核(NTK)等机制的影响,这是未来的重要研究方向。
结论:这篇论文不仅为神经网络架构设计提供了理论依据,更为如何平衡“逼近能力”与“泛化难度”提供了一个严密的数学坐标系。