
DeepSeek-V4 深度解析:突破百万级上下文的效率极限
DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
本文介绍了 DeepSeek-V4 系列模型(包括 1.6T 参数的 Pro 和 284B 的 Flash 版本),该系列采用混合注意力机制(CSA 和 HCA)及流形约束超连接(mHC),在支持百万级(1M)上下文处理的同时,显著提升了推理效率并刷新了多项开源模型 SOTA 纪录。
TL;DR
DeepSeek-V4 的发布标志着大模型从“暴力计算”转向“架构级深度优化”。通过 CSA (Compressed Sparse Attention) 与 HCA (Heavily Compressed Attention) 的巧妙结合,以及 mHC (流形约束超连接) 对残差结构的重塑,DeepSeek-V4 在 100 万 token 的上下文长度下,实现了令人震惊的效率飞跃:KV Cache 占用骤降 90%,同时在编程、推理和知识问答领域全面对标乃至超越了 GPT-5(预览版级别)等最强闭源模型。
1. 核心动机:解决长文本的“通脹”危机
在 Test-time Scaling(思维链推理)和长程 Agent 任务日益普及的今天,Transformer 原生的 Attention 机制成了最大的绊脚石。处理 1M token 时,内存和计算成本呈指数级增长。DeepSeek 团队意识到,单纯增加算力无法解决本质问题,必须从数学结构上对注意力计算和信号传播进行“降维打击”。
2. 混合注意力架构:CSA 与 HCA 的协同
DeepSeek-V4 的核心杀手锏是其混合注意力设计,它将注意力层分为两种不同的压缩策略:
- Compressed Sparse Attention (CSA):它将每 4 个 token 压缩为 1 个 KV 条目,并引入 Lightning Indexer。在检索时,Query 只会选取 Top-k 个最相关的压缩块进行计算。
- Heavily Compressed Attention (HCA):这是一种更极致的方案,每 128 个 token 才产生一个 KV 条目。虽然它依然进行全局 Dense Attention,但由于序列长度被压缩了 128 倍,计算开销近乎忽略不计。
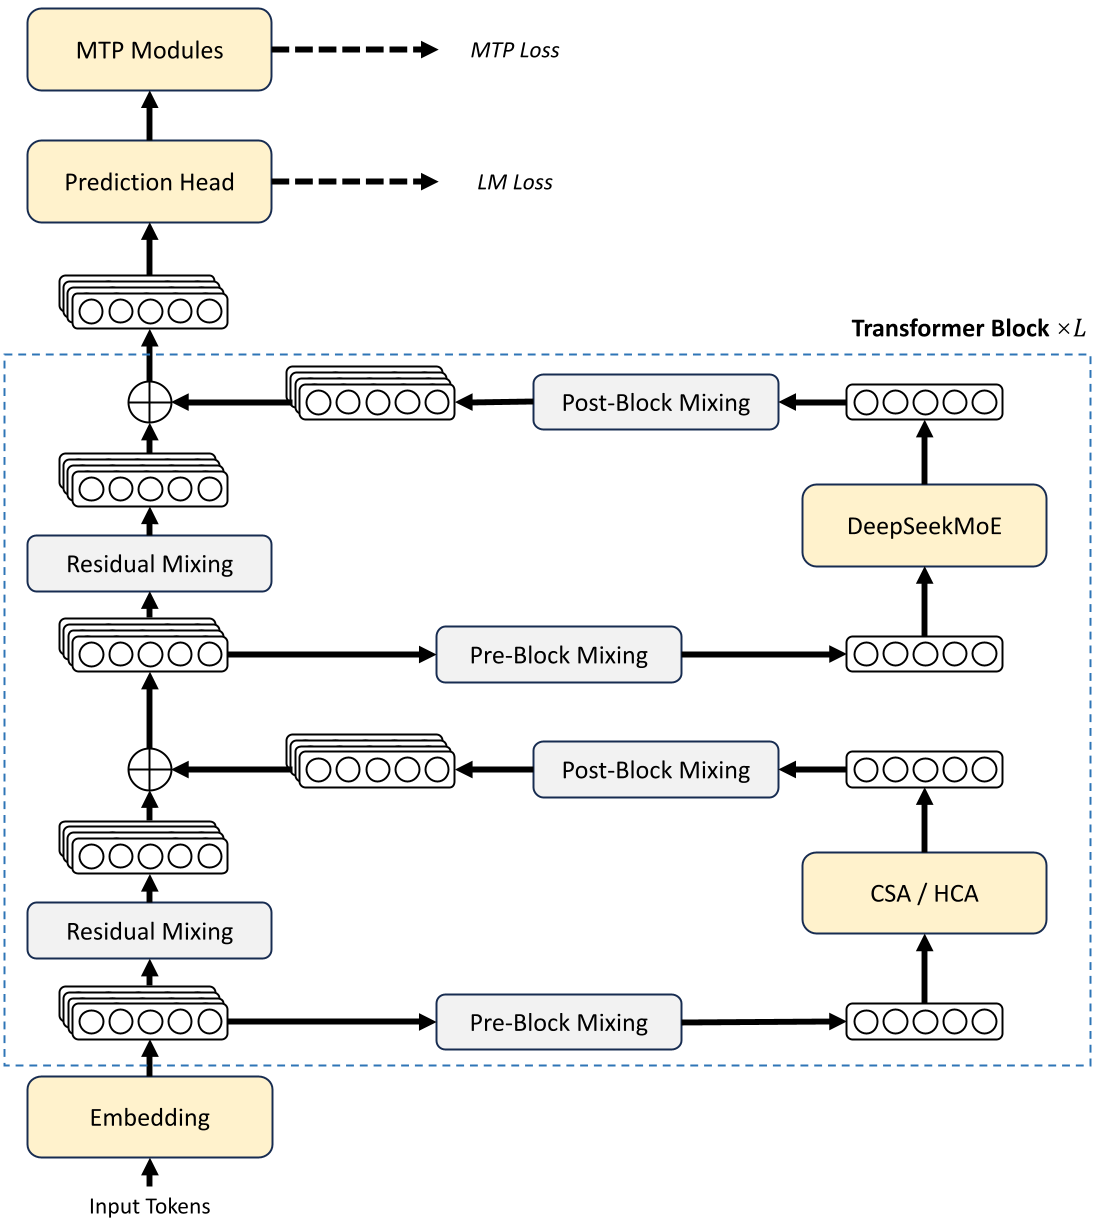 图 1:DeepSeek-V4 整体架构,展示了混合注意力与 MoE 模块的结合
通过这种设计,模型在保持长程依赖感知的(HCA 的功劳)同时也具备了局部的精细理解能力(CSA 的功劳)。
3. 稳定性保障:mHC 流形约束超连接
为了支撑 1.6T 参数量的超深网络,传统的残差连接(Residual Connection)开始显露疲态。作者引入了 Manifold-Constrained Hyper-Connections (mHC)。
不同于传统的 ,mHC 将残差映射约束在 **Birkhoff Polytope(双标量随机矩阵流形)**上。这种数学约束保证了映射矩阵的谱范数(Spectral Norm)始终小于或等于 1,从根本上防止了信号在数百层网络传播中的爆炸或消失。
4. 实验战绩:效率与智能的双赢
实验数据展示了 DeepSeek-V4 的恐怖统治力:
- 长文本效率:在 1M 上下文下,DeepSeek-V4-Pro 的单个 Token FLOPs 仅需 V3.2 的 27%,KV Cache 内存仅占用 10%。
- 竞技水平:其在 Codeforces 上的表现让它跻身全球人类程序猿的前 23 名。
- 知识深度:在 SimpleQA 任务上,它以 57.9% 的准确率大幅抛离其他开源模型。
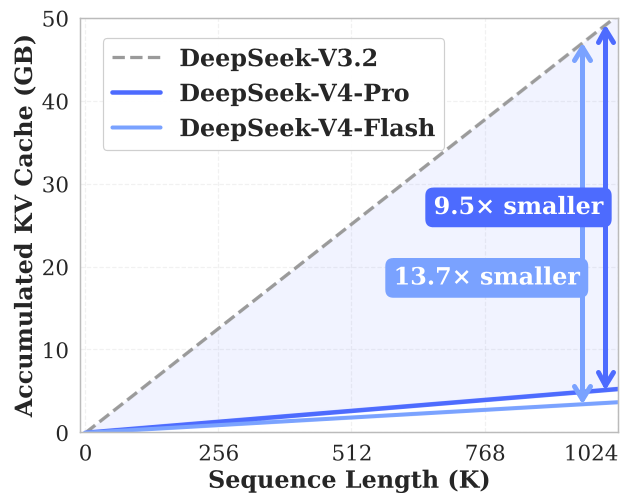 图 2:左侧展示了 Benchmark 性能对比,右侧直观刻画了其在推理开销上的巨大优势
5. 训练与设施:Muon 优化器与 TileLang
为了更进一步压榨硬件性能,DeepSeek-V4 采用了:
- Muon 优化器:利用 Newton-Schulz 迭代进行正交化更新,相比 AdamW 具有更快的收敛速度。
- TileLang DSL:自研域名特定语言,在开发效率与内核(Kernel)运行速度之间取得了平衡,特别是在处理稀疏算子时。
6. 总结与展望
DeepSeek-V4 不仅仅是一个更强的模型,它是一套面向“长文本时代”的工程标准。它告诉我们:通过对算法物理直觉的精准把握(如稀疏性与压缩的结合),我们可以用更少的激活参数(49B)撬动万亿级别的模型能力(1.6T)。
局限性:尽管 V4 在效率上近乎完美,但其复杂的混合架构也对推理引擎的实现提出了极高要求。未来如何在多模态场景下维持这种长文本优势,将是下一个值得关注的战场。