
DeepSeek-V4:突破效率瓶颈,开启百万级长文本智能的新纪元
DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
本文介绍了 DeepSeek-V4 系列模型(包括 1.6T 的 Pro 和 284B 的 Flash 版本),采用混合注意力机制与 MoE 架构,在百万级 Token 上下文工程化与推理效率上实现重大突破,DeepSeek-V4-Pro-Max 在多项核心任务上刷新了开源模型的 SOTA 纪录。
TL;DR
DeepSeek-V4 系列(Pro 与 Flash)通过对 Transformer 架构的激进重构,成功将 100 万 Token 级别的上下文处理效率提升到了前所未有的高度。主要创新包括混合注意力机制(CSA + HCA)、流形约束超连接(mHC)以及针对大规模 MoE 训练的稳定性优化策略。其旗舰版 Pro-Max 不仅在推理能力上逼近 GPT-5 级别,更在长文本任务上展现了极高的能效比。
背景:长文本处理的“不可能三角”
在深度学习领域,长文本处理一直面临性能、内存与计算成本的权衡困境。原生 Attention 的 复杂度使得上下文每增加一倍,计算量呈指数级增长。DeepSeek 团队认为,要真正让模型具备处理大规模文档、复杂 Agent 工作流的能力,必须通过架构层面的创新打破这一瓶颈。
核心技术深度解析
1. 混合注意力架构:CSA 与 HCA 的协同
DeepSeek-V4 并没有采用单一的注意力降维,而是设计了一套精妙的混合系统:
- 压缩稀疏注意力 (Compressed Sparse Attention, CSA):先将每 个 Token 压缩为一个 KV 项,再通过 DeepSeek 独有的稀疏选择逻辑(DeepSeek Sparse Attention),让 Query 仅访问最相关的部分。
- 重压缩注意力 (Heavily Compressed Attention, HCA):采取更极端的压缩率 (),但在压缩后的特征上进行全量计算。 这种 interleaved(交错)的排布方式,既保留了局部细粒度依赖,又兼顾了全局长程建模。
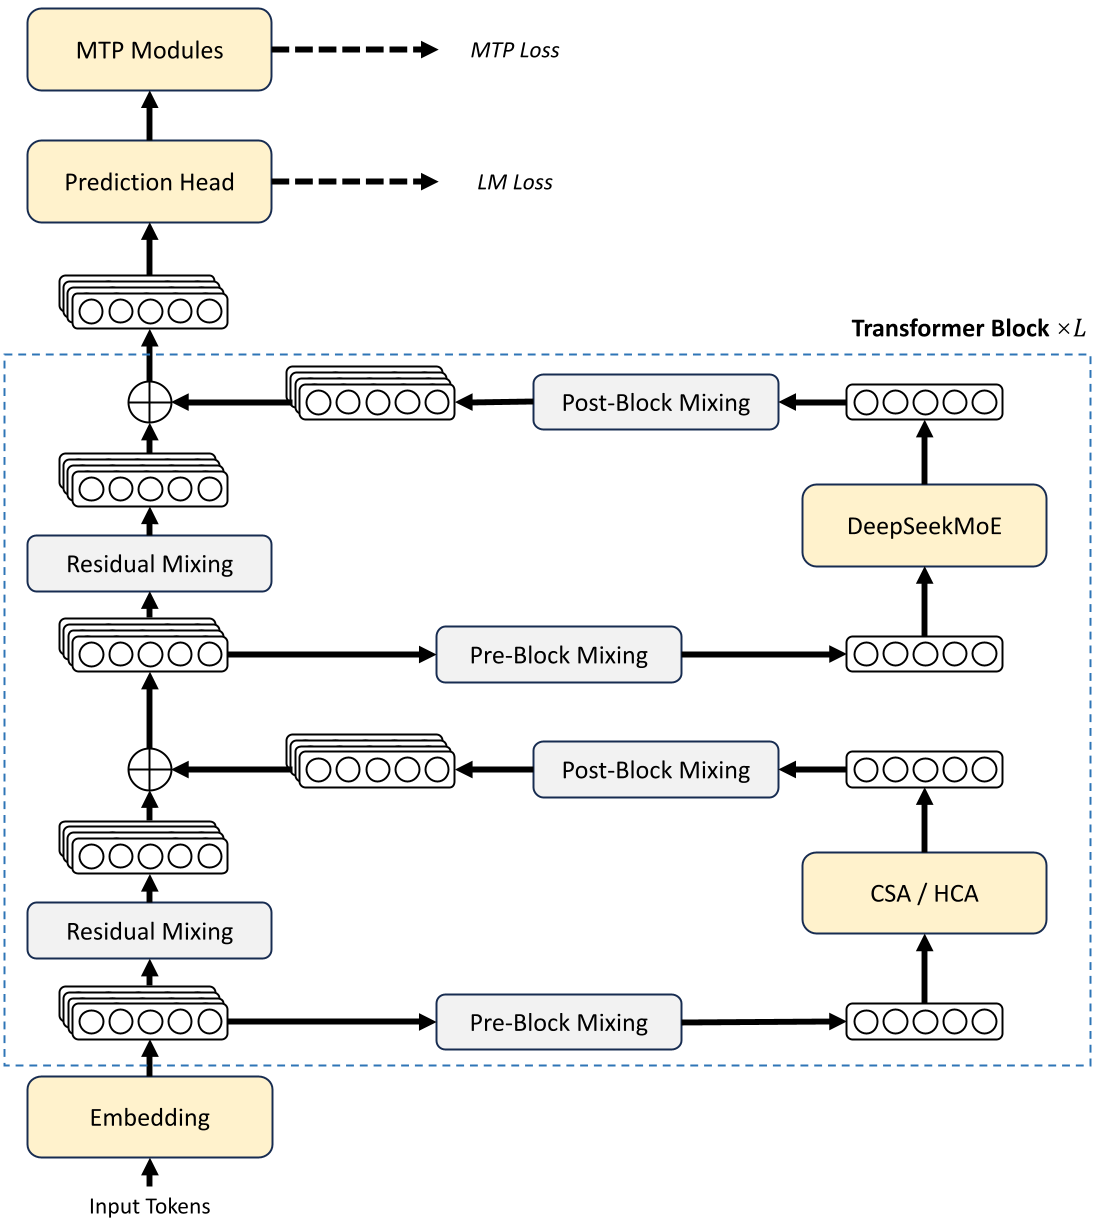 图 1:DeepSeek-V4 总体架构,展示了混合注意力与 MoE 的结合。
2. 流形约束超连接 (mHC)
为了增强深度网络的信号传播稳定性,作者引入了 mHC。相比传统的残差连接,mHC 将残差映射约束在双随机矩阵(Doubly Stochastic Matrices)流形之上。通过 Sinkhorn-Knopp 算法迭代,保证了变换矩阵的谱范数有界,这对于万亿级参数量(1.6T)模型的训练稳定性至关重要。
3. 训练稳定性三板斧
- Muon 优化器:利用二阶导数信息实现更快的收敛。
- 预判路由 (Anticipatory Routing):解耦 Backbone 更新与路由索引计算,利用历史参数决定 Token 的去向,有效缓解了 MoE 常见的 Loss Spikes。
- SwiGLU 钳制:通过限制激活值的范围防止离群值(Outliers)拖垮整个训练。
实验战果:效率与能力的双重极致
在推理效率方面,DeepSeek-V4 完成了对前代产品的“降维打击”。如下图所示,Pro 版本在处理 1M 长度文本时,显存占用(KV Cache)和计算耗时(FLOPs)仅为 V3.2 的一成到三成。
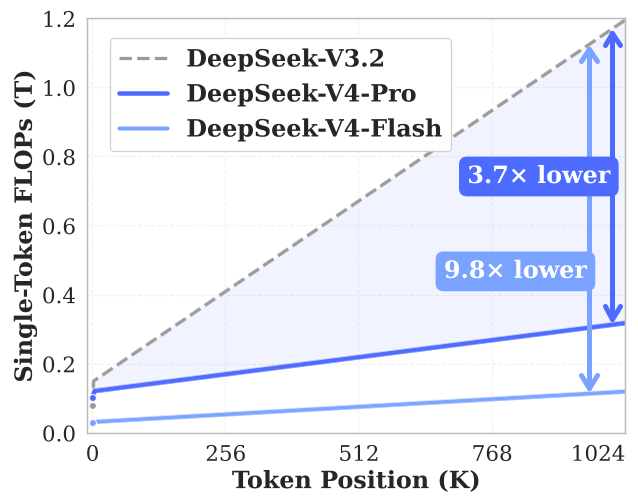 图 2:DeepSeek-V4 相比 V3.2 在 1M 上下文下的 FLOPs 与 KV Cache 显著下降。
而在能力维度上,DeepSeek-V4-Pro-Max 在 Codeforces 编程竞赛评估中表现惊人。其实际建模的逻辑深度足以应对复杂的算法挑战,Rating 评分超过 3200 意味着它在编程逻辑上已达到人类顶尖选手水平。
| 任务维度 | 关键指标 | DeepSeek-V4-Pro-Max 表现 |
|---|---|---|
| 基础知识 | SimpleQA | 57.9% (开源首位) |
| 代码竞技 | Codeforces Rating | 3206 (LGM 级别) |
| 长文本 | MRCR 1M Context | 83.5 (优于 Gemini 3.1 Pro) |
总结与未来启示
DeepSeek-V4 系列的发布标志着“小激活参数、大模型底座”的 MoE 路线在工程化上已臻成熟。其对注意力机制的底层剪枝与压缩,不仅是为学术研究,更为未来构建具备“持续在线、海量上下文记忆”的真正 Agent 提供了不可或缺的底层支柱。
局限性:虽然架构表现卓越,但目前对于路由稳定性、混合注意力中压缩特征的信息丢失率仍缺乏系统论解释。
未来,我们可以期待 DeepSeek 将此类高效架构扩展至多模态领域,或者通过更稀疏的 Embedding 模块进一步压低推理门槛。