
DeepXiv-SDK:把学术文献变 API,终结科研 Agent 的 PDF 噩梦
DeepXiv-SDK: An Agentic Data Interface for Scientific Literature
本文推出了 DeepXiv-SDK,一个专为大语言模型智能体(LLM-agents)设计的学术文献数据接口。它将 ArXiv 等海量非结构化 PDF/HTML 文档转化为结构化、可编程调用的 JSON 对象,支持渐进式访问和混合检索,显著提升了科研 Agent 的处理效率。
TL;DR
在 AI4Science 领域,学术论文是 Agent 进化的养料,但 PDF/HTML 的解析却是它们的“致命弱点”。北京智源人工智能研究院(BAAI)推出的 DeepXiv-SDK 正式发布,它不仅是一个数据库,更是一个面向 Agent 的数据协议。它将 ArXiv 上的数百万篇论文转化为结构化、带预算提示、可按章节随机存取的 JSON 接口,让科研 Agent 能够像调用 API 一样高效、廉价地“阅读”论文。
背景定位
目前大多数科研 Agent(如 GPT-4o Deep Research)在处理论文时,依然采用“粗暴读取”模式:下载 PDF -> 文本提取 -> 丢进 Context。这种方式存在三大痛点:
- 解析脆弱 (Brittle):表格丢失、公式乱码、结构不明。
- 成本爆炸 (Costly):为了找一个实验数据,不得不支付整篇论文的 Token 费用。
- 缺乏索引:Agent 很难实现类似人类查阅目录后精准跳读的行为。
DeepXiv-SDK 的出现,标志着学术资源从“为人阅读设计”向“为 Agent 消费设计”的重大转变。
痛点深挖:为什么现有的方案行不通?
学术写作是高度结构化的,但其承载媒介(PDF)却是物理布局导向的。现有 SOTA 方法(如 ar5iv)虽然能转成 HTML,但主要是为了优化移动端阅读,并没有为 AI 模型量身定制。Agent 需要的是:
- 结构感知:能够直接通过
sections[1].text拿到引言,而不是靠正则匹配。 - 预算感知:在阅读前知道这一段有多少 Token,从而决定是否需要更廉价的摘要(TL;DR)。
方法论详解:三层架构的魔法
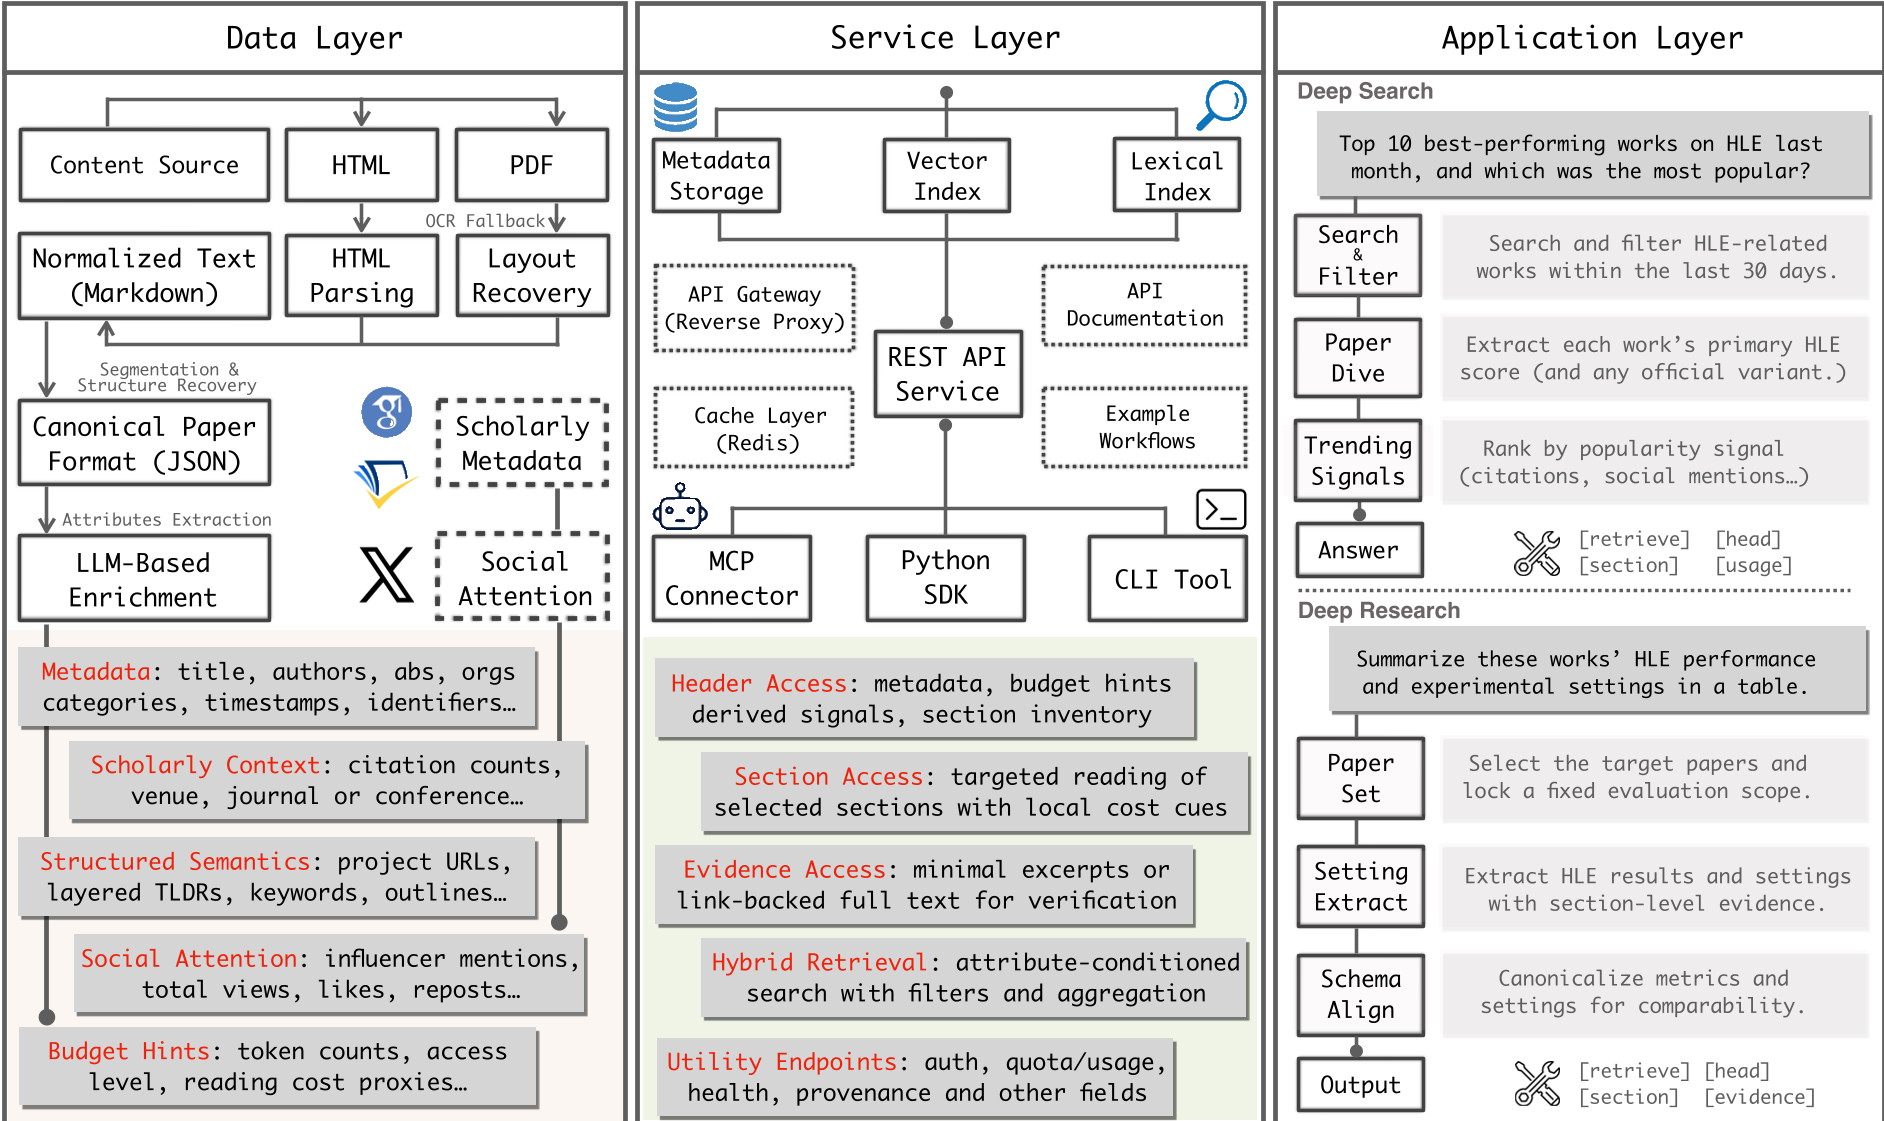
1. 数据层:大规模标准化
DeepXiv-SDK 并非简单的爬虫,它背后有一套精密的流水线:
- PDF 骨架重排:使用高性能工具 MinerU 将 PDF 转化为标准的 Markdown 格式。
- 语义信号增强:利用 Qwen 系列模型为每一个章节生成轻量级的
TL;DR,并精确计算每一部分的 Token 数量。 - 多维度索引:不仅有文本内容,还通过正则和 LLM 校验提取了关联的 GitHub 仓库地址,并对接 X(Twitter) 的社交关注度信号。
2. 服务层:渐进式访问视图
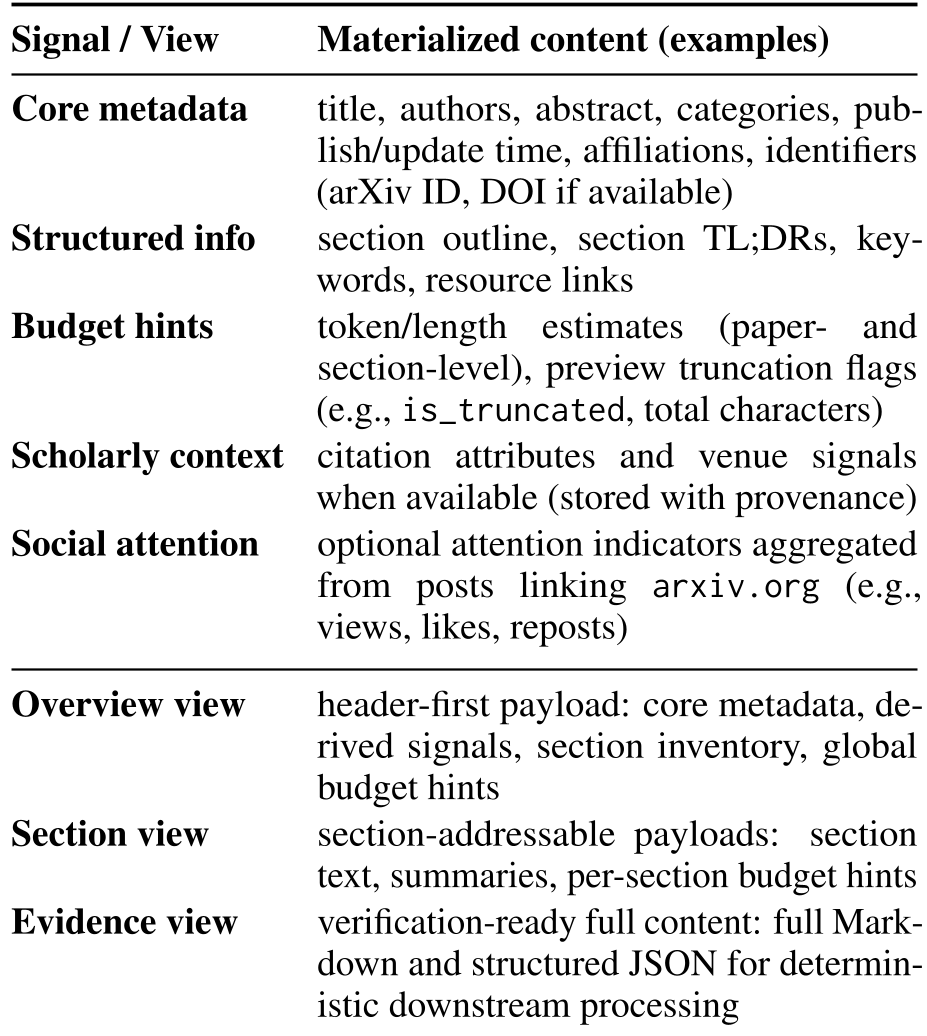
这是 DeepXiv 最核心的设计哲学——渐进式披露(Progressive Disclosure)。由于 API 支持不同粒度的请求,Agent 可以采取以下策略:
- Header 级预览:只看标题、摘要、目录和预算,判断是否有必要进一步阅读。
- Section 级精读:只请求最关键的“实验”或“结论”章节,极大节省上下文窗口。
- Evidence 级校验:只有在需要最终确认细节时,才获取全文 Markdown。
实验与结果:快且准的降维打击
推理效率的飞跃
在对负载下的延迟测试中,DeepXiv-SDK 展现了极强的商业级性能。传统的“下载+解析”流程处理 1000 篇论文平均每篇需 7.2 秒,而通过 DeepXiv 的缓存接口,本地热访问延迟降低到了毫秒级(约 131ms),加速比高达 54.6 倍。
Deep Research 任务实测
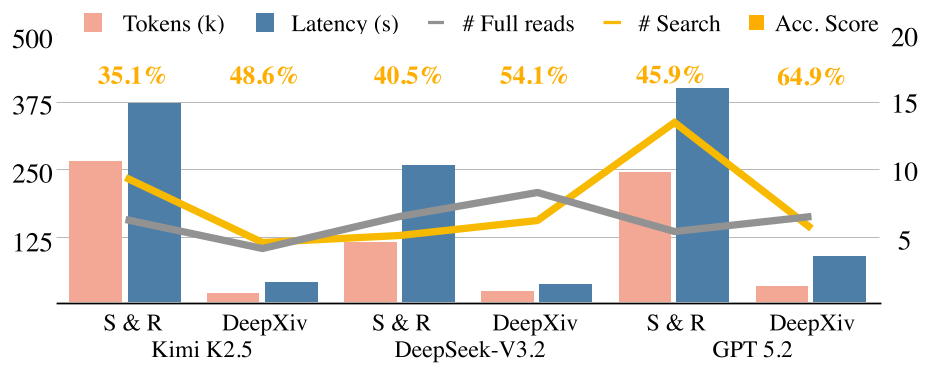
研究团队构建了 47 个复杂的学术 QA 问题(如“上个月内在某榜单上取得最高分的论文是哪篇?”)。相比于传统的搜索+Jina Reader 方案,基于 DeepXiv-SDK 的 Agent 在保持更高答案准确度的同时,显著降低了运行时间和 Token 成本。
深度洞察与总结
核心价值 (Takeaway): DeepXiv-SDK 实际上是为 AI 时代建立了一套“学术基础设施协议”。当数据不再是零散的文档,而是结构化、可查询的 API 时,科研智能体的上限将被极大地拉高。它可以无缝集成到 MCP (Model Context Protocol) 协议中,成为开发者手中的利器。
局限性与挑战: 虽然该系统目前覆盖了近 300 万篇 ArXiv 论文,但对于非开源期刊(闭源数据库)的覆盖仍受限于版权和授权协议。此外,一些极度复杂的数学公式或非线性图表在 Markdown 转化中仍可能存在精度损失。
展望: 随着 DeepXiv-SDK 扩展到 PubMed、bioRxiv 等更多领域,我们有望看到能够跨学科、跨领域自动整合科学证据的“超级科研助理”诞生。对于开发者而言,现在就可以前往其 GitHub 或项目主页获取 API Token,开始构建属于自己的 AI 学者。