
Deliberative Searcher:通过约束强化学习重塑 LLM 搜索的可靠性
Deliberative Searcher: Improving LLM Reliability via Reinforcement Learning with constraints
本文提出了 Deliberative Searcher,这是一个推理优先的搜索增强语言模型框架。该方法通过约束强化学习(Constrained RL)和自适应拉格朗日乘子,将搜索操作与置信度校准集成到 Chain-of-Thought 生成中,显著提升了模型在复杂问答任务中的可靠性。
TL;DR
在大模型搜索增强(Search-Augmented)领域,模型往往容易陷入“一本正经胡说八道”的窘境。复旦大学与上海 AI Lab 联合提出的 Deliberative Searcher 通过约束强化学习(Constrained RL),不仅让模型学会了通过搜索解决问题,更重要的是,它学会了**“知道自己不知道”**。实验显示,该模型在显著降低错误自信率的同时,还通过置信度引导的推理计算,实现了 4 倍的推理加速。
痛点深挖:信息爆炸后的信任危机
目前的 RAG 模型或 Agent 框架普遍遵循“信息优先”逻辑:盲目堆砌检索结果,导致输出冗长且可靠性模糊。更危险的是,模型常常以极高的确定性给出错误答案(False-Certain)。
作者认为,真正的可靠性应该源于推理优先(Reasoning-Primary):
- 自我评估:在生成的每一步感知知识盲点。
- 主动探索:仅在必要时触发搜索。
- 透明校准:让用户直观看到检索证据如何改变模型的置信度。
核心机制:约束强化学习(Constrained RL)
为了同时优化“正确性(Correctness)”和“可靠性(Reliability)”,Deliberative Searcher 并没有简单地堆叠奖励函数,而是采用了带约束的优化方案。
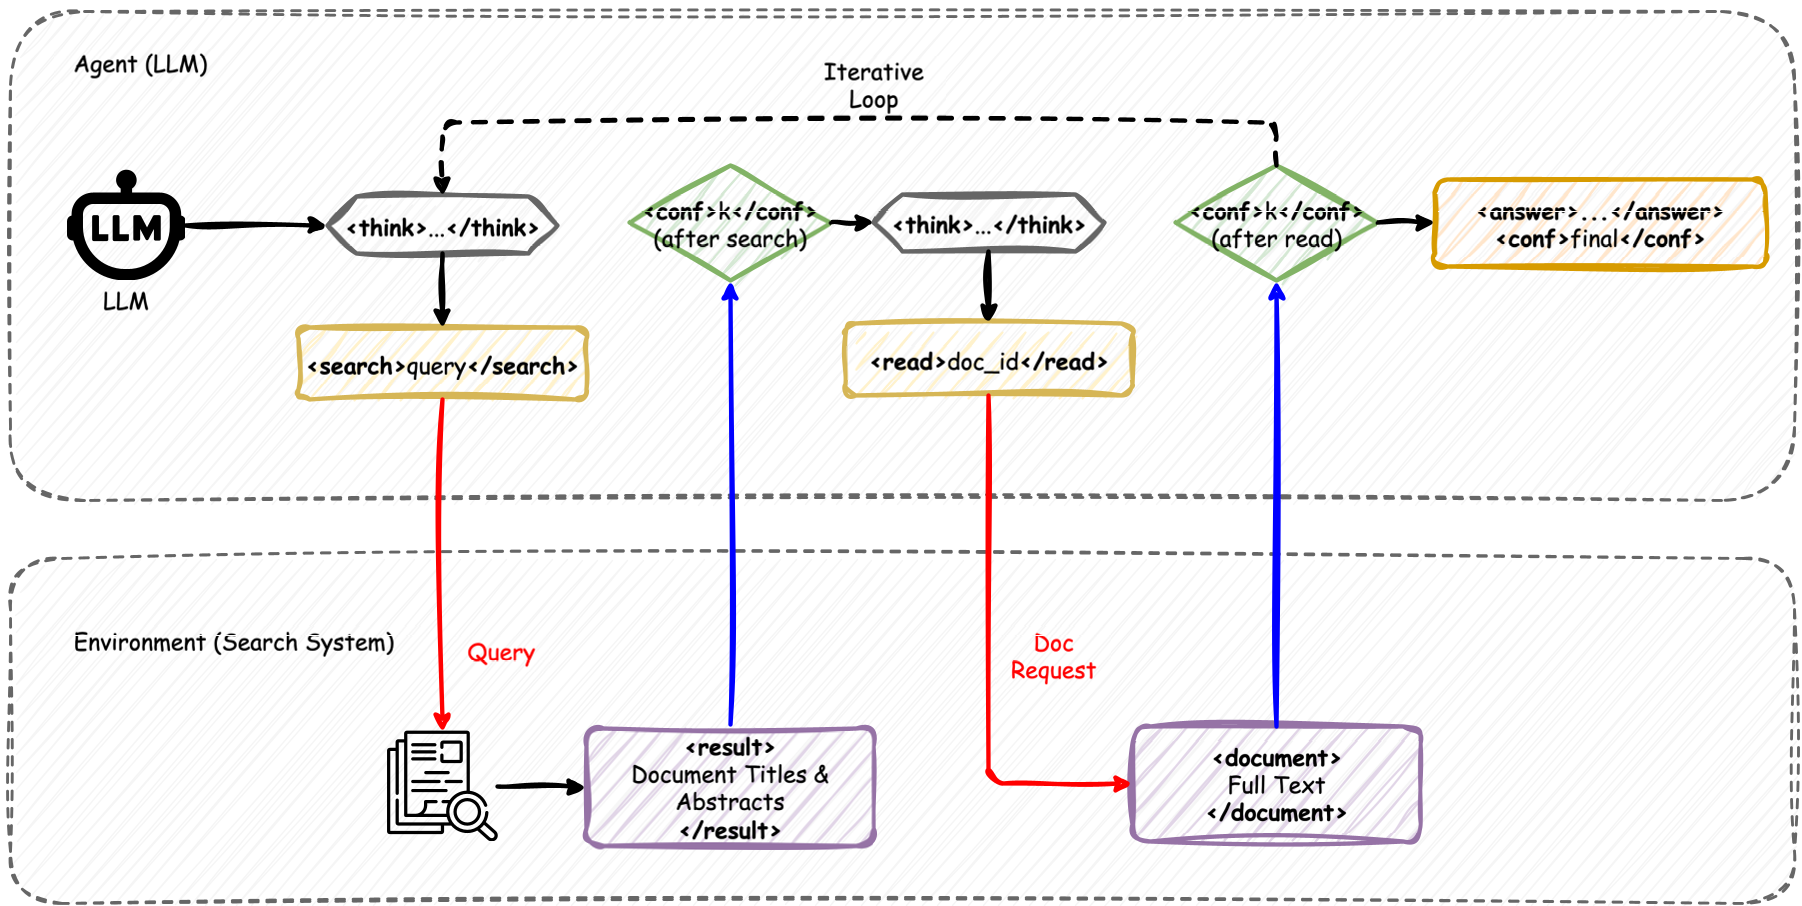
1. 动作空间与推理循环
模型在推理链中可以执行 <think>, <search>, <read>, <confidence> 等动作。特别地,引入了两阶段检索流程:先看摘要(Abstract),觉得有用再读全文(Read),这极大节省了上下文成本。
2. 拉格朗日乘子动态调整
单纯的加权奖励(Fixed-weight RL)容易导致模型走向极端(例如为了刷可靠性分数而变得永远不自信)。作者在 GRPO 算法的基础上,引入了自适应拉格朗日乘子 :
- 如果模型的可靠性低于设定阈值, 增大,强化惩罚。
- 如果可靠性达标, 减小,让模型专注提升准确率。
实验与战绩:不仅仅是准确率
研究团队在 7B 和 70B 两个量级上进行了实验,并对比了 GPT-4o 等闭源模型。
显著降低“虚假自信”
Deliberative Searcher-7B 的平均 False-Certain 率从基线的 54% 暴降至 2%。这意味着模型在不确定时会老老实实地给出低置信度评分,或者通过进一步搜索来核实。

推理时计算(Test-time Compute)的跃迁
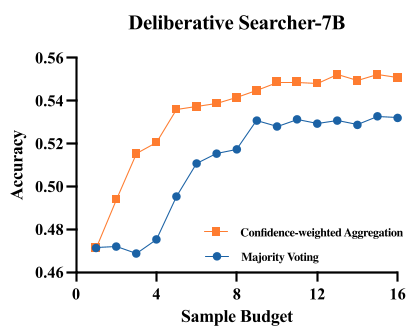
传统的 Self-Consistency 需要采样大量路径并进行多数投票(Majority Voting)。Deliberative Searcher 利用其校准良好的置信度进行加权投票。结果显示,仅需 4 个样本的效果就等同于传统方法 16 个样本的效果,实现了 4 倍的推理成本削减。
典型案例:置信度的动态演化
在处理关于“BERT 层数对比”的问题时,模型展示了精彩的校准行为:
- 第一步:搜索到 BERT 有 12 层,置信度提升至 4/10。
- 第二步:搜索原版 Transformer 时结果模糊,置信度果断下降至 2/10。
- 第三步:通过精准读取(Read)确认了 Transformer 为 6 层,置信度飙升至 9/10。
这种“证据驱动”的置信度波动,证明了模型已经形成了验证习惯(Verification Habit)。
总结与洞察
Deliberative Searcher 的成功点明了未来 AI Agent 的一个重要方向:置信度不应只是一个后处理的数字,而应是驱动整个推理和搜索流程的核心信号。通过约束强化学习将“诚实”写入模型底层逻辑,是通往 AGI 可信化的必经之路。
虽然目前该框架主要集中在文本领域,但其在多模态搜索及更复杂的自适应推理任务中展现出的潜力不容小觑。