
稠密监督,稀疏更新:揭秘在线策略蒸馏(OPD)的参数几何学
Dense Supervision, Sparse Updates: On the Sparsity and Geometry of On-Policy Distillation
本文系统分析了在线策略蒸馏(On-Policy Distillation, OPD)在参数空间中的更新特性。通过对多种大语言模型(LLM)和视觉语言模型(VLM)的对比,研究发现 OPD 的参数更新具有极高的坐标稀疏性(Sparse Updates)和特定几何特征,尽管其接收的是稠密的教师信号(Dense Supervision)。
TL;DR
在线策略蒸馏(OPD)已成为大模型轻量化和推理能力迁移的核心方案。人们直觉上认为:既然老师给的是每个 Token 的稠密反馈,学生的参数更新也应该是大面积的。然而,本论文反直觉地指出:OPD 本质上是在做“手术级”的微调。 它的权重更新极其稀疏,且专门寻找源模型中“不重要”的角落进行修改,这种特性使其更像强化学习(RL),而非传统的监督微调(SFT)。
1. 坐标系定位:OPD 到底在哪?
在 LLM 的后训练坐标系中,我们通常有三个象限:
- SFT (Supervised Fine-tuning): 固定数据 + 稠密 Token 信号 = 行为克隆。
- RLVR (RL with Verifiable Rewards): 自己的数据 + 预测稀疏奖励 = 策略优化。
- OPD (On-Policy Distillation): 自己的数据 + 稠密 Token 信号 = 本文的研究对象。
作者发现,尽管 OPD 在信号上向 SFT 看齐,但在参数行为上,它却坚定地站在了 RL 这一边。
2. 核心发现:稀疏性与分布
研究者通过分析 Qwen、MiniCPM 等模型的 Checkpoint Delta 发现,OPD 的更新表现出惊人的稀疏性。
- 更新规模极小:OPD 的相对 Frobenius 范数仅为 0.04% 左右,而离线蒸馏则高达 11.9%。
- 高度坐标稀疏:在 的阈值下,约 70%~90% 的参数坐标几乎没有变动。
- 模块偏好:更新并非均匀分布,FFN(前馈网络)通常承载了最大的相对变动。
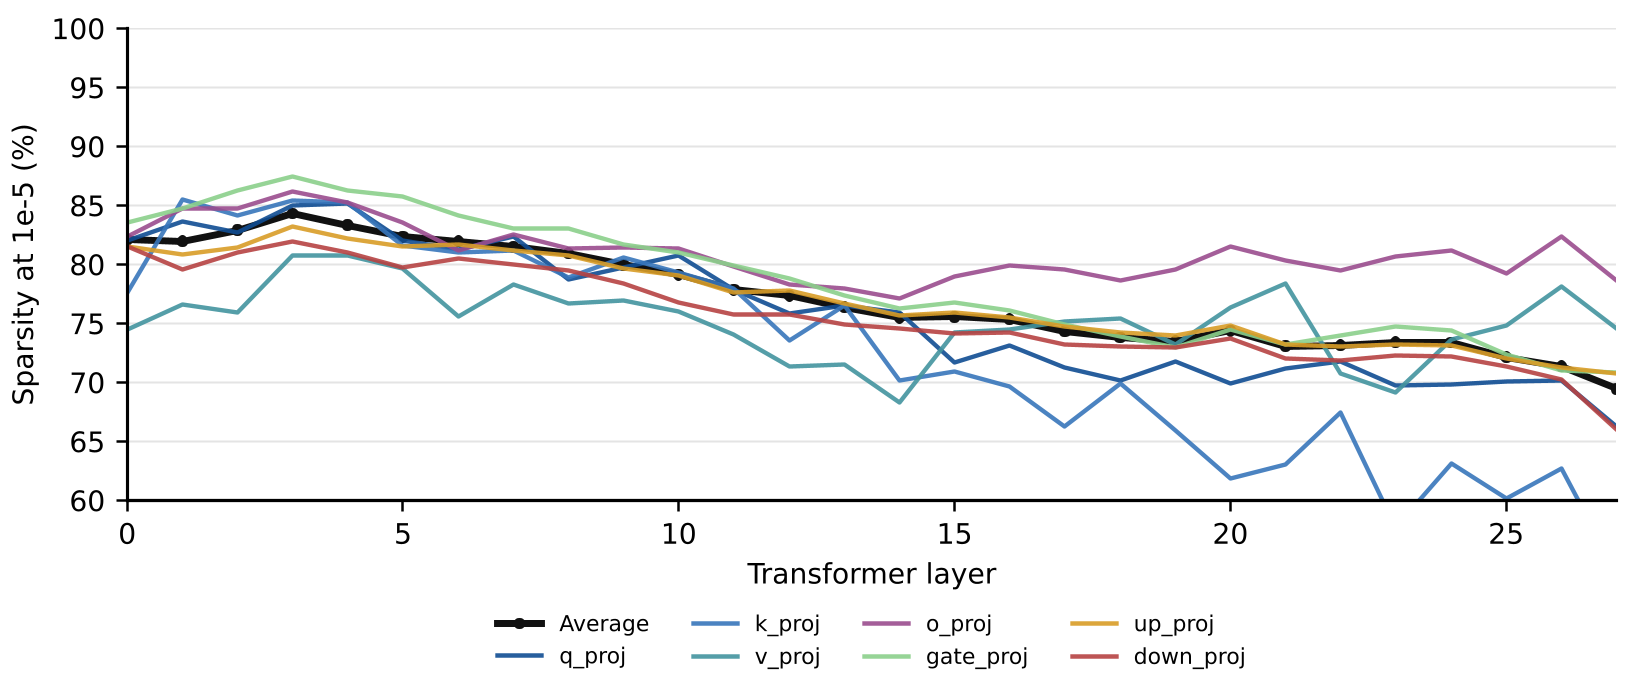 图:DS-Qwen 模型中 OPD 更新的逐层稀疏度分析,显示更新跨层分布但保持高度坐标集中。
3. 几何直觉:避重就轻的“谱”特性
为什么 OPD 有效?作者引入了矩阵谱分析(SVD)来解析更新矩阵 :
- 满秩但集中: 在数值上是满秩的,但其能量(奇异值)高度集中在少数几个方向上(Stable Rank 极低)。
- 避开主成分:最有趣的发现是,OPD 的更新方向几乎不与源权重 的奇异向量对齐。它倾向于在源权重接近于零的坐标上进行“刺青”,而不是重写那些已经很庞大的参数。
这种“避开主导地位”的特性,解释了为什么 OPD 能够在不破坏预训练知识的前提下,精准植入推理能力。
4. 实验验证:子网络训练的奇迹
为了证明这种稀疏性不是单纯的数值噪声,作者做了一个硬核实验:只训练那些在 OPD 中变动过的参数(约占 17.5%),冻结其他所有坐标。
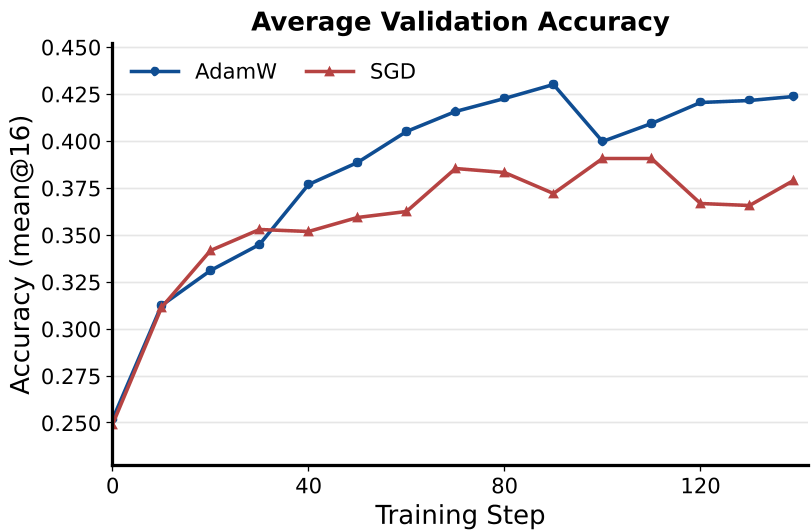 图:在 AIME 数学竞赛评测集上,基于 OPD 掩码的子网络训练(红色)几乎完美复现了全量训练(蓝色)的效果,远超随机掩码(橙色)。
5. 优化器陷阱:我们还需要 Adam 吗?
最近有研究声称在 RL 阶段 SGD 就能打平 Adam。但在 OPD 里,作者给出了否定答案。由于教师信号产生的梯度具有更强的异构性(Coordinate-wise Heterogeneity),AdamW 的这种二阶动量缩放依然至关重要。实验显示,在同样配置下,SGD 的表现明显逊色。
6. 深度洞察
OPD 的这种“稠密监督、稀疏更新”的范式启示我们:模型学习新技能并不需要重塑整个大脑。 当模型在处理自己生成的样本(On-policy)时,它已经处于熟悉的流形区域,教师的反馈更多是指引它在现有架构的空隙中进行微调。
这种特性为未来的 OPD 原生自适应方法(如更精准的 LoRA 变体)提供了坚实的理论支撑。
总结
本文通过对参数空间的深度切片,证明了在线策略数据分布才是决定后训练几何特征的第一变量。OPD 不仅仅是蒸馏,它是一种利用教师知识,在学生自发行为流形上进行的特种编辑。