
音乐也能精准控号:基于多模态反馈的情绪闭环调节系统
Design and Analysis of a Closed-Loop Emotion Regulation System Based on Multimodal Affective Computing and Emotional Markov Chain
本文介绍了一种基于多模态情感计算和情感马尔可夫链(Emotional Markov Chain)的闭环音乐情绪调节系统。通过融合面部表情、EEG 和 ECG 信号,系统能够实时精准监测用户情绪,并利用动态概率模型自动选择音乐刺激,实现将用户引导至并维持在目标情感状态的目的。
TL;DR
本文提出了一种能够“读懂”人心并“治愈”负能量的闭环系统。它通过摄像头、脑电(EEG)和心电(ECG)传感器实时监测情绪,并利用情感马尔可夫链动态调整音乐播放。实验证明,这种闭环干预能让用户比传统随机听歌更快速、更稳定地进入并维持在“快乐”状态。
1. 背景定位:从“听歌识曲”到“听歌识人”
在人机交互(HCI)领域,情感计算早已不是新鲜赛道。然而,绝大多数工作停留在“识别”阶段。如果你难过,模型只会机械地告诉你“你现在很悲伤”,这无异于一种生理上的“复读机”。真正有价值的研究应该关注如何调节(Regulation)。
本文作者 Xingchao Wang 等人将控制理论中的“闭环(Closed-loop)”思想引入情绪干预,将人体的情绪变化视为一个受控过程,而音乐则是那个精准的驱动信号。
2. 核心挑战:情绪的非线性和个体差异
为什么做一个情绪调节系统这么难?
- 模态缺失:仅靠表情可能被掩饰(社交面具),仅靠生理信号噪声多。
- 动态性:情绪不是开关,是从悲伤到平和、再到快乐的连续演变过程。
- 不可预测性:同样的欢快歌曲,对失恋的人可能适得其反。
3. 方法论详解:多模态感知与马尔可夫链调节
3.1 感知系统:多模态 LSTM 融合
为了打破单模态识别的瓶颈,系统整合了三类信号:
- 面部视觉(Face Visual):提取表情动作单元(Action Units)。
- 脑电(EEG):通过 PSD 特征捕捉情感深层的神经活动。
- 心电(ECG):利用 HRV(心率变异性)分析自主神经系统的激活度。
这些特征被喂入一个多模态 LSTM 模型。LSTM 擅长处理时序数据,能够捕捉情绪在时间上的依赖性。
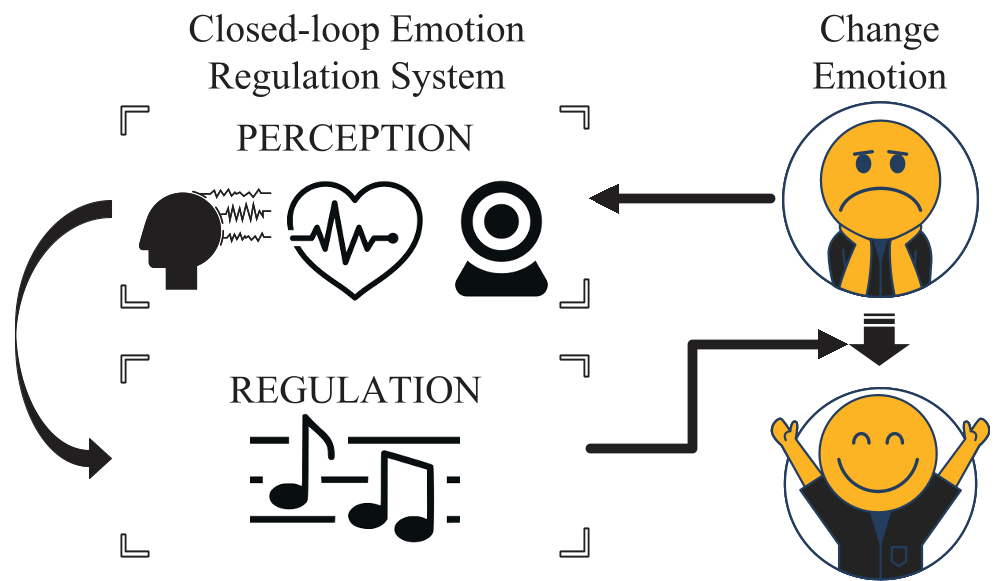 图 1:感知系统与调节系统构成的闭环框架
3.2 调节系统:情感马尔可夫链(Emotional Markov Chain)
这是本文最精彩的设计。作者认为情绪转换具有概率性(Probabilistic)。通过马尔可夫链,系统可以预测:在当前情感状态 A 下,播放一段具有特征 M 的音乐,下一时刻转移到目标状态 B 的概率。
闭环调节逻辑:
- 计算当前情绪与目标情绪(Valence & Arousal)的偏差。
- 若偏离目标,通过修正公式动态计算下一段音乐所需的参数。
- 利用 KNN 算法在音乐库中“按图索骥”,寻找最能填补该情绪缺口的曲目。
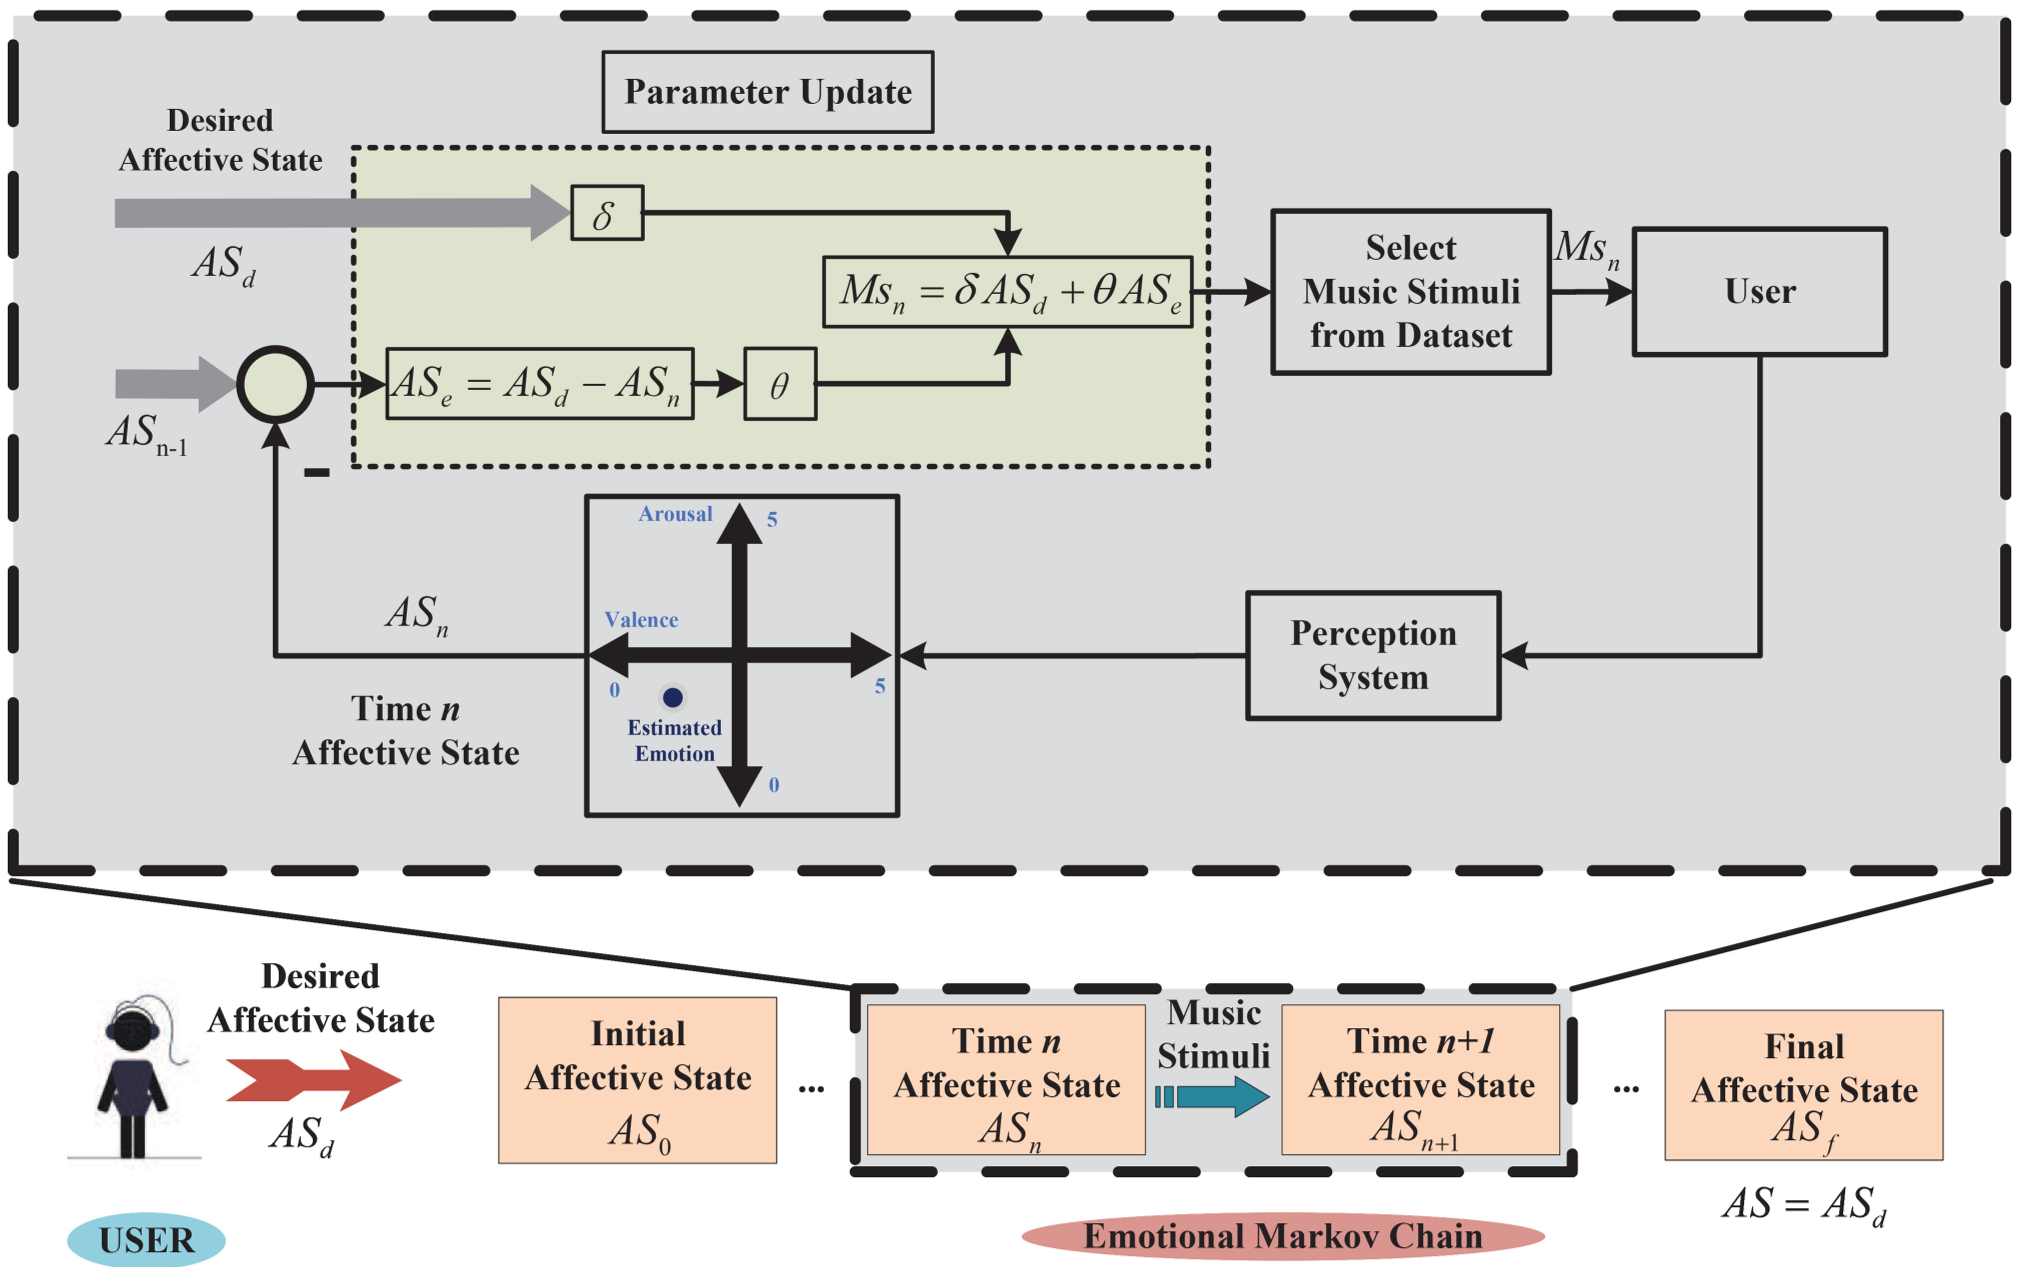 图 2:基于反馈的情绪调节流程
4. 实验与战绩:闭环吊打开环
研究团队通过两组实验论证了系统的优越性:
- 精度测试:在 DEAP 数据集上,该方法将识别准确率推到了 86% 以上。相比于只用 EEG 或只用视频,融合方案展示了强大的鲁棒性。
- 调节有效性:通过 5 名受试者的真实对比实验发现,虽然“开环方法”(即推荐类似的情绪音乐)能让人短暂触达目标情绪,但很快就会由于“情绪疲劳”或“适应性”跌落。而闭环系统通过实时微调音乐能量,让受试者在长达几分钟的实验中始终稳如泰山地保持在“快乐”区间。
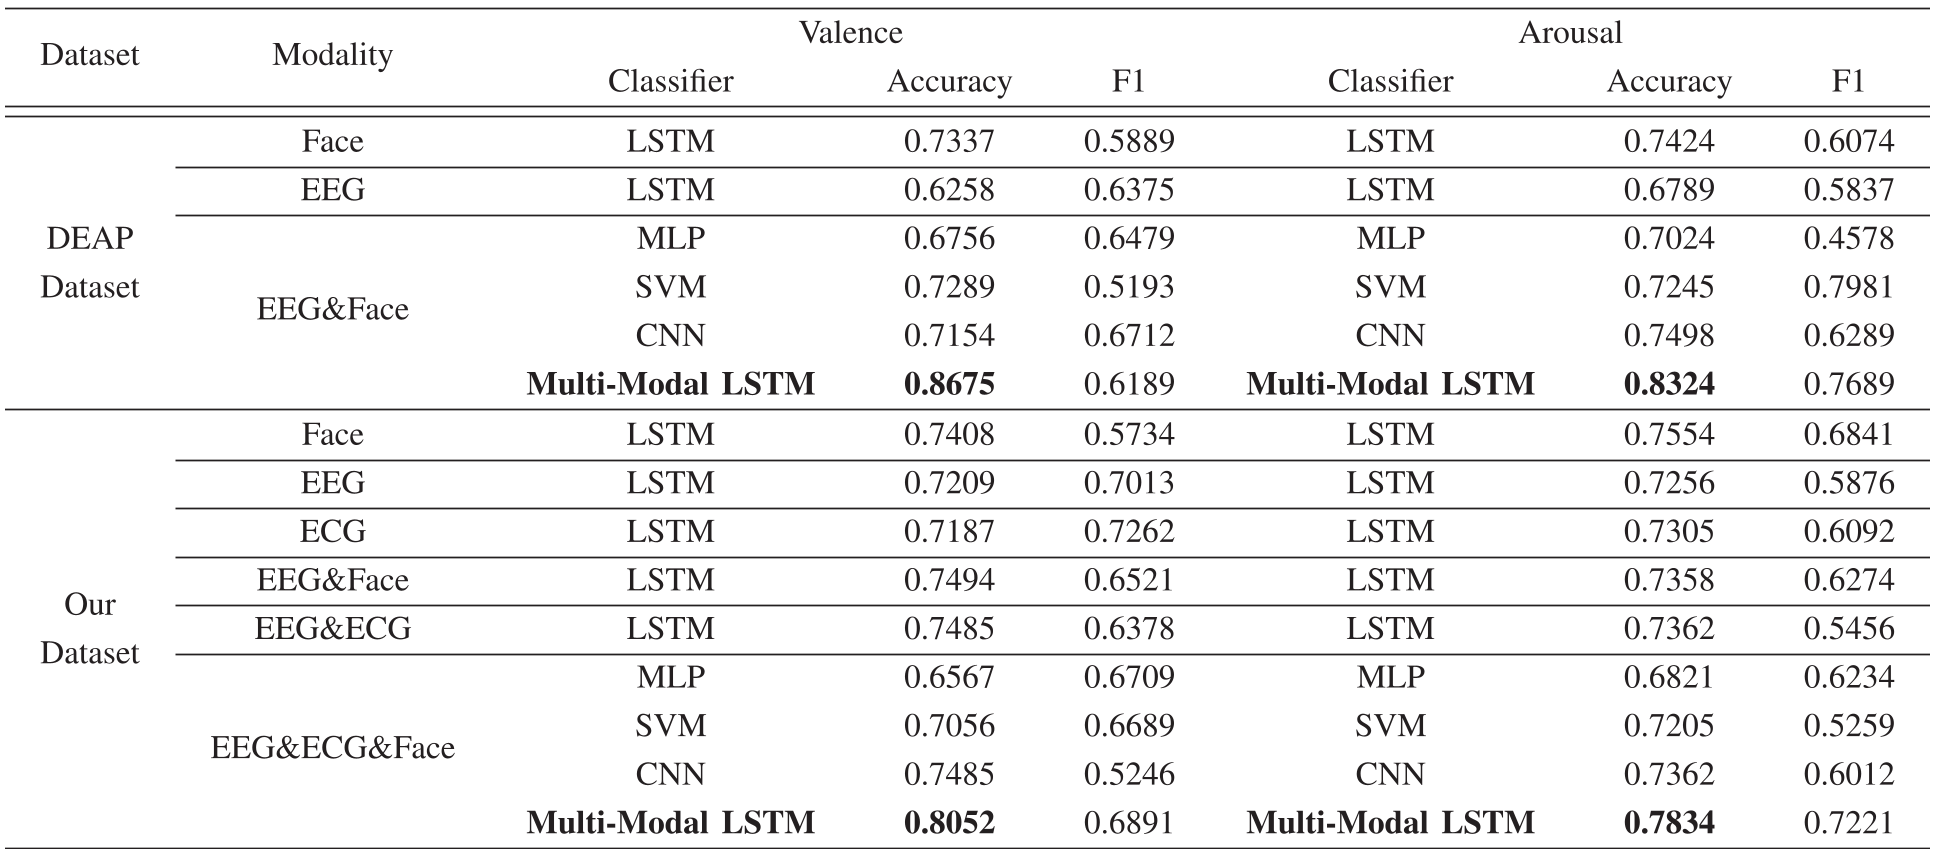 表 1:不同分类器在各模态下的性能对比,可见多模态 LSTM 系列全面占优
5. 深度洞察:未来已来,但门槛犹在
这篇工作最核心的商业/学术启示在于:个性化(Customization)是情绪干预的唯一出路。 传统的流媒体音乐推荐是基于标签的,而本文展示了基于“生物反馈”的实时生成的未来。
局限性分析:
- 硬件依赖:目前仍需佩戴 EEG 和指夹式血氧仪,虽然为了实验精度可以接受,但要落地到日常场景(如通勤或办公),如何利用集成在耳机里的入耳式 EEG 或智能手表的传感器实现等效精度,是下一个挑战。
- 计算延迟:多模态 LSTM 虽准但重,在实时系统中如何在毫秒级延迟内完成决策,仍需进一步性能优化。
总结: 该研究通过严谨的数学建模和闭环控制逻辑,将音乐从一种“艺术消遣”转变为一种“数字处方”,为未来患有焦虑或抑郁情绪的群体提供了一种低成本且无副作用的辅助治疗手段。