
设计文档作为唯一真值:SMART 如何用 AI 重生成 ML 性能建模库
Design Docs Are All You Need An AI-native Machine-Learning Performance Tool
本文提出 SMART,一个以自然语言设计文档为长期维护资产的 AI-native 机器学习性能建模库。其核心方法是由子代理按文档依赖图重新生成实现,并用 worked examples、可发现 DAG 和最小符号 IR 保证可再生性与可验证性。论文报告该库约 50 篇文档、约 9,000 行规范文本,完整重生成耗时约 1.5 到 3 小时,可复现 DeepSeek-V3 serving on a TPU pod slice 等手审参考模型至 round-off precision。
TL;DR
这篇论文提出 SMART,一个面向机器学习系统协同设计的 symbolic performance-modeling library。它不试图让 AI 代理在旧代码上继续打补丁,而是把主分支几乎清空,只保留一份由自然语言设计文档组成的 DAG,再让多个 coding sub-agents 按依赖顺序重新生成整个库。论文给出的关键证据是:约 50 篇设计文档、约 9,000 行规范文本,可在 1.5 到 3 小时内完成一次全量重生成,并且再生实现可复现包括 DeepSeek-V3 serving on a TPU pod slice 在内的手审参考模型,精度达到 round-off precision。这个工作的核心洞见是:当规格变化速度超过人工维护代码的速度时,代码本身可以不再是长期资产,设计文档与可执行示例才是。
背景定位
从论文结构看,SMART 更像一篇“范式主张强烈的系统工程论文”,而不是单纯的性能建模算法论文。它并没有报告新的 roofline 模型、新的调度算法或新的硬件计数器,也没有与若干既有 performance modeling frameworks 做大规模精度排行榜。它的贡献集中在软件组织方式:主分支几乎不含代码,生成过程由设计文档 DAG 驱动,人类修改文档,机器再生代码。因此,判断这项工作的价值时,不应主要问“它预测性能是否比其他模型更准”,而应问“在架构与系统快速演进的领域,设计文档能否真正替代代码成为 durable artifact”。
问题与动机:性能建模框架为什么天然不适合长期维护
机器学习性能建模处于两个高速变化区域的交界处:上方是模型架构的快速演化,例如 MoE routing、latent attention、异构 inference phase;下方是 accelerator、interconnect 和 collective runtime 的持续变化。传统抽象往往假设某类结构稳定,例如 transformer layer 具有同构模式,但新架构会立刻打破这类假设。于是,性能建模框架不得不持续吸收来自两端的 churn,表现为不断追加条件分支、局部 hack 和重构。
论文将这类问题形式化为“incremental generation debt”。设 是某个时间点的库规格, 是代码生成器, 是生成后的实现。全新构建满足 ,但现实维护中,下一版生成器会拿到上一版实现作为额外输入,于是变成 。这种“拿着旧代码改新设计”的路径,会让旧实现中的妥协反向污染新设计空间。
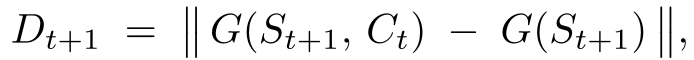
这个式子把“增量修补产生的技术债”定义为一种实现距离:右边第一项是使用旧代码作为上下文生成的下一版实现,右边第二项是只根据当前规格重新生成的理想实现,两者之间的范数差代表偏离程度。原文用范数符号表达距离,但没有进一步规定它必须是欧氏距离、编辑距离还是功能差异度量,因此这里更像概念性定义,而非可精确测量的物理量。它的关键作用是指出失效机制:只要 继续参与生成, 就很难回到 的干净路径。若每次都以零历史重新生成,理论上债务可被清零;但对人类而言,“删掉全部代码重来”成本极高,因此实际维护中往往只能不断 patch,债务持续累积。
论文还指出第二个失效机制,即 context-window myopia。AI coding agents 虽然可以局部修改代码,但无法把整个成熟 codebase 放入有限上下文窗口。开发者只能提交碎片化代码片段,代理看不到全局 invariant、跨模块依赖和架构意图。于是它会生成“局部合理但全局次优”的修改。这种问题与前面的技术债相互放大:旧代码越复杂,上下文碎片越严重;碎片越严重,再生成的全局结构越容易被破坏。SMART 的出发点正是利用 AI 代理生成速度提升这一现实,改变“增量修代码”的默认工程模式。
核心章节:把代码变成构建产物,把文档变成真值
从补丁债到全量再生:SMART 的生成工作流
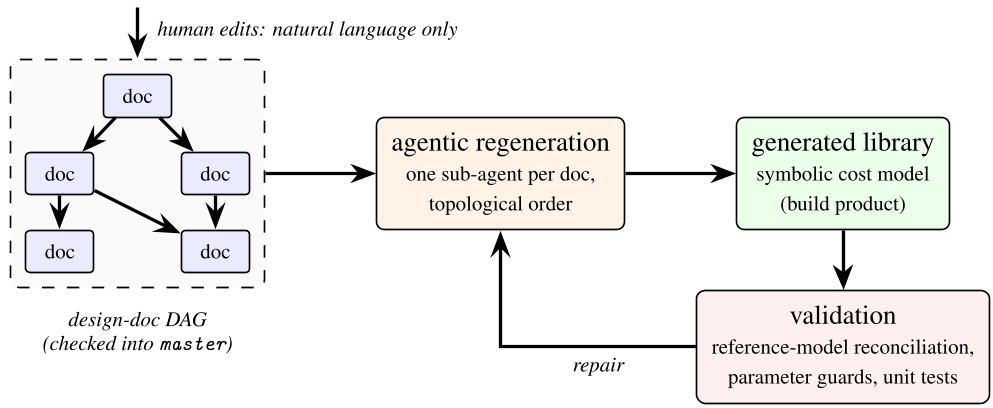
SMART 的主分支几乎不含代码,而是一组 Markdown 设计文档。这些文档不是松散笔记,而是组成有向无环图,也就是 DAG。例如 hardware topology 和 numerics 文档应先于 collective cost models,后者又先于 model catalog。论文强调,这个 DAG 的边不是人工维护,而是由 read-only agents 阅读设计文档并推断依赖关系。依赖图确定后,orchestrator agent 按拓扑顺序调度 coding sub-agents,每个 sub-agent 实现一份自包含文档。生成结束后,系统还要与手审参考模型做 reconciliation,只有通过后才允许替换前一次构建。
这一设计之所以成立,依赖两个前提。第一,AI 代码生成速度和成本已经下降到“全库重生成”变得可负担;第二,目标领域的规格可以被分解成相对稳定、相互依赖明确、语义自包含的模块。SMART 没有声称任何领域都适合这种模式,而是针对 ML performance modeling 这种两端变化剧烈的场景:模型结构和硬件系统频繁演进,但性能建模的核心对象可以被抽象成有限 IR。换言之,它不是简单地把 prompt 写长,而是重构了软件仓库的形态:人类负责维护可理解、可验证的规格,机器负责维护代码。
这里需要追问一个设计理由:为什么不继续让 AI 代理做 incremental patch?论文的回答直接对应前面的债务公式。只要生成过程是 ,旧实现就会以难以追踪的方式进入新实现;而定期计算 ,则让式中的 在构造上归零。这个推理来自论文对技术债的形式化,而不是单纯工程偏好。它隐含一个强假设:从文档重新生成的成本低于维护旧代码的累积成本。论文给出的 1.5 到 3 小时和约 100 美元正是为了说明该假设在 SMART 场景中可行。
设计文档怎么写:worked examples 作为语义锚点
SMART 对文档写作有明确风格。论文认为,传统 AI 软件工程实践偏向 top-down rules,例如写测试、写高层约定、让代理遵守某种项目宪法。但仅靠这类抽象规则不够,因为多个 sub-agents 在独立生成时必须共享同一种具体语义。作者主张补充 bottom-up ingredient,也就是 worked examples:把一段伪代码在具体输入上的执行过程逐步写出来,包括中间 shape、中间 values、最终应得到的 closed-form cost expression。Section 2 给了一个典型例子:在 2×2×2 torus with wraparound 上,每节点 link count 是 3,不是 6;因此 all-gather 的 V bytes 成本应如何计算,也应按同一语义得到。
这种写法本质上是在对抗 context-window myopia。每个 coding sub-agent 看到的文档自包含,但不同子任务之间必须保持跨模块一致。worked example 的价值在于,它把自然语言中容易漂移的“应该这样计算”变成可追踪的“按这条具体轨迹计算”。它类似 in-context learning 中的 concrete demonstration:模型未必理解抽象规则的全部边界,但能根据具体步骤复制语义。论文引用 Brown et al., 2020 和 Dong et al., 2022 来说明这一机制,因此这不是纯直觉,而是借用了 LLM 在示例上更容易学习结构的已有观察。
文档还包含 reconciliation anchor。每个带数字语义的文档末尾都要给出一个小型预设场景,期望输出被明确写出,并由生成后的测试强制执行。这个机制很关键:如果没有锚点,子代理可能写出看似合理但细节不一致的模型;有了锚点,再生成结果可以被自动检查,错误会在早期暴露。论文将这种机制称为 self-documenting by construction,意思是系统文档不是事后补充,而是生成过程的输入和验证依据。
最小符号 IR:让文档可再生,也要让模型可审计
仅靠文档风格和代理编排还不够。性能建模库的抽象必须少、正交,并且能抵抗架构 churn。SMART 因此使用一个最小 symbolic IR。其基本对象是 Op,可递归定义:一个 Op 的输入和输出是 symbolic-shaped tensors,包含 OpCost,按 compute、memory、comm 分类的 SymPy cost expressions,以及 RRT,也就是 resource reservation table。资源表行表示资源,列表示 cycle,单元格表示使用了多少单元。Op 可以是 InnerLoop,带有 trip count 和 body graph;可以是 GraphParams,表示子图;也可以是 LeafParams,表示叶子 op。
在论文的目标平台上,叶子节点对应 TPU-shaped system abstractions,例如 an MXU matmul tile,即 mxu_op;a VMEM tile load,即 load_tile_to_vmem;a ICI collective,例如 allgather。这个分解方式非常重要:算法侧把叶子组合成 loop nests,系统侧给叶子定价。更换 attention variant 时,主要影响模型侧文档;更换 interconnect generation 时,主要影响系统侧文档。两侧不必互相牵动,因此抽象能吸收新架构,而不是每次新模型都迫使整个框架重写。
SMART 的 builder DSL 也不是让开发者手工拼 Op 节点。模型在 thin Python-embedded tracing DSL 中表达,decorated block 被 trace 成命名子图,decorated loops 变成 InnerLoop。论文举例说明 flash-attention core 在 Listing 1 中的表达:B、H、Tq、Tkv、hd_qk、hd_v、q_blk、kv_blk 等维度都是 SymPy symbol,trip counts 如 Tq divided by q_blk 保持 symbolic。score matrix 不离开 VMEM 的约束可以被表达为设计语义;非对称的 Tq 和 Tkv 让同一段 loop nest 既服务 prefill,其中 Tq 等于 Tkv 等于 T,也服务 flash-decoding,其中 Tq 为 1,Tkv 为 Tctx。这个设计选择说明它要处理的是异构 inference phase,而不是只支持同构 transformer layers。
分布语义方面,SMART 不要求开发者手写所有 collective。张量通过 sharding annotations 指明每个 dimension 位于哪些 mesh axes 上,sharded-einsum wrapper 根据 operand 和 output sharding 推断 collective,例如对 sharded contracting weight 做 just-in-time AllGather,或在输出被 sharded dimension 上 reduce 时推断 ReduceScatter。只有 layout-moving collectives 才显式写出,例如 DeepSeekMoE block 中 dispatch all_to_all 将 expert-parallel axis 从 token-group dimension 移到 expert dimension,combine 再移回。这个取舍很明确:常见 collective 由规则推断,降低文档噪音;真正改变布局的 collective 必须显式,因为它们往往是正确性关键。
代价评估被分成 fast mode 和 slow mode。fast mode 做粗粒度 roll-up:每个 leaf cost 乘以 enclosing trip counts,再用简单 analytical scheduler 建模通信与计算 overlap,例如 weight pre-collection、all-to-all hiding;其风格类似 roofline bound,适合在数千设计点上扫描。slow mode 则把每个 loop 用 modulo-scheduling 编译进 RRT,对 body 进行 software pipelining,得到 dependency- and resource-aware schedule,并通过 recursive initiation interval roll-up 得到更细粒度结果。这个设计回答了一个关键问题:如果所有研究都做精细调度,扫描设计空间太慢;如果只做 coarse roll-up,则无法支持 schedule studies。SMART 用同一 IR 支撑两种模式,让 sweep 和 fine-grained analysis 共享同一个 symbolic 真值。
所有成本都保持 symbolic propagation。每个 roll-up 输出的是关于 batch、sequence length、bandwidth、mesh axes、datatype widths 等 free variables 的 SymPy closed-form expressions。数值绑定只发生在边缘,每个 design point 做一次 substitution。这样,一份 symbolic build 就能服务整个 sweep,而不是每个配置都重新推导成本表达式。设计文档甚至可以写明某个 collective cost 的 exact expected expression,生成测试直接断言该表达式,从而把“模型公式是否一致”纳入自动化验证。
实验与证据:再生成本、规模与复现精度
论文报告的证据主要不是模型精度排行榜,而是“这套再生工作流是否真的经济且可审计”。Section 2 与 Section 4 给出了规模和成本数字。
| 指标 | 论文给出的数值 |
|---|---|
| 设计文档数量 | 50 篇 |
| 规范文本规模 | 约 9,000 行 |
| 完整重生成耗时 | 1.5 到 3 小时 |
| Claude Code API 成本 | 约 100 美元 |
| 占 Claude Max 高配周预算比例 | 约 20% |
这些数字说明 SMART 的方法在工程成本上并非停留在概念演示。一次完整重生成在数小时内、百美元级别 API 成本内完成,且占用高配周预算约五分之一。这支持论文的核心主张:当生成成本足够低时,全量再生可以成为常规版本更新方式,而不是灾难恢复手段。
更关键的证据来自 Abstract:再生实现可复现 hand-audited reference models,包括 DeepSeek-V3 serving on a TPU pod slice,并且达到 round-off precision。这里需要把证据拆开看。它证明的不是“SMART 的预测与真实硬件测量误差极小”,而是“SMART 从文档再生出的实现能复刻已有手审参考模型的数值输出”。这在软件工程层面已经很有说服力:如果不同 sub-agents 各自生成,最终仍能精确复现复杂模型的成本结构,说明文档、worked examples、依赖 DAG 和 reconciliation tests 确实约束了生成语义。
但论文没有提供传统维护方式与 SMART 方式的直接对照实验。例如,它没有给出“人类在 12 个月内维护同一框架产生的代码改动量、缺陷率、预测误差”与“SMART 定期重生成产生的对应指标”之间的表格。它也缺少消融实验:如果去掉 worked examples,只保留高层规则,错误率会如何变化;如果不用自动发现 DAG,而让人类维护依赖,是否仍稳定;fast mode 与 slow mode 在真实设计 sweep 中的误差差异如何。由于论文未提供这些控制实验,读者对“设计文档足以替代代码”的结论应理解为在 SMART 这个特定 IR、特定 TPU 建模目标和特定文档风格下的成功,而不是普适工程定律。
从证据强度看,最强的是可复现性:round-off precision 对 reference models 是严格测试信号。最弱的是泛化性:论文主要面向 TPU、ML serving 和 co-design,文档规模约 9,000 行,模型数量约 50 篇,尚不足以证明大型生产数据库、编译器或操作系统也能用同样方式以文档为真值再生。另一个边界是,性能模型的“正确”最终仍取决于 reference model 的假设;如果参考模型本身编码了过时的 TPU 调度假设,SMART 会忠实地复现它。它能减少代码腐化,但不自动保证物理现实对齐。
深度洞察与总结
SMART 的贡献可以落到三个机制上。第一,它用全量重生成切断增量生成债。只要旧代码不再作为生成上下文,式中的 就不需要靠人类纪律慢慢偿还,而是在每次再生时被清零。第二,它用 worked examples 把设计文档从“说明性文本”提升为“语义约束源”。独立子代理共享的不只是术语,而是一步步可复现的执行轨迹,这弥补了 context window 无法容纳全库的问题。第三,它用最小 symbolic IR 把性能建模对象抽象得足够少、足够正交,使文档可再生、测试可断言、架构可插拔。
这项工作的局限性同样具体。首先,文档写作难度被转移而非消除。作者需要把复杂 cost model 写成自包含文档、worked example 和 reconciliation anchor,约 9,000 行规范文本本身就是高成本工程。其次,机器发现 DAG 和 orchestrator central log 的鲁棒性未被详细量化;如果依赖推断遗漏跨文档不变量,再生结果可能仍然错误。再次,论文以 TPU leaves 为核心抽象,向 GPU、ASIC 或网络拓扑扩展时需要替换 leaf system docs,但新平台上的 collective semantics、memory hierarchy 和 resource reservation 是否同样稳定并未验证。最后,round-off precision 只说明复刻手审参考模型,不等于预测真实硬件时延达到同等精度,也不等于对未知新模型的外推误差很小。
未来最有技术含量的方向,是把 SMART 从“再生工具”推进到“可证明的规格编译体系”。例如,可以为 design-doc DAG 增加形式化依赖检查,确保 worked examples 与 reconciliation anchors 覆盖所有边界条件;可以把 fast mode 和 slow mode 的误差差异量化,作为设计空间扫描的可信度预算;也可以把 IR 的 leaf set 从 TPU-specific 扩展为多硬件 backend,验证同一文档是否能在替换系统层文档后稳定再生。更长远看,这项论文提示了一种新的软件工程分工:人类负责写出可执行语义,AI 负责把语义物化为代码;一旦规格变化,先改文档,再重建世界。