
DeTeCtive:重新定义 AI 检测——基于写作风格库的多级对比学习
DeTeCtive: Detecting AI-generated Text via Multi-Level Contrastive Learning
本文提出了 DeTeCtive,一种基于多级对比学习(Multi-Level Contrastive Learning)的 AI 生成文本检测框架。该方法将检测任务重新定义为对不同“作者”(包括人类和各种 LLMs)写作风格的区分,并在多个基准测试中达到了 SOTA 性能。
TL;DR
字节跳动与国科大的研究者提出了一种名为 DeTeCtive 的新型检测框架。它打破了“人/机”二元对立的传统检测逻辑,转而通过多级对比学习捕捉细微的“写作风格”特征。该方法不仅在常规测试中刷新 SOTA,更在分布外(OOD)检测中表现惊人,并支持一种无需训练即可进化的 TFIA 机制。
核心速览:跳出“二分类”的陷阱
目前的 AI 文本检测器大多在玩“猫鼠游戏”,训练一个二分类器来识别特定模型的输出。然而,随着 GPT-4, Llama-3 等新模型层出不穷,这种方法在面对“未见过”的模型时往往会瞬间失效。
DeTeCtive 的核心直觉是:每一个 LLM 都可以被视为一个独特的“作者”。与其去猜一段话是不是 AI 写的,不如去学习区分不同作者的写作痕迹。
痛点与动机:为什么之前的检测器不灵了?
- 特征坍缩:简单的二分类法会将所有 LLM 的输出挤压在一个标签下,忽略了不同模型家族(如 Meta 的 Llama vs OpenAI 的 GPT)内部的风格差异。
- 泛化瓶颈:面对 OOD 数据(新领域、新模型),固定权重的分类头很难适应特征空间的偏移。
- 对抗脆弱性:经过改写(Paraphrasing)的 AI 文本很容易骗过传统的统计特征检测。
方法论详解:多级对比学习与检索式推理
1. 多级对比损失函数 (Multi-Level Contrastive Loss)
作者通过数学约束,强迫编码器(Encoder)在向量空间中构建一种“亲缘关系”:
- 第一层:同一模型生成的文本,距离最近。
- 第二层:同一公司/家族的模型,距离次之。
- 第三层:所有 AI 生成文本,应聚集成群。
- 第四层:人写文本与 AI 文本,距离最远。
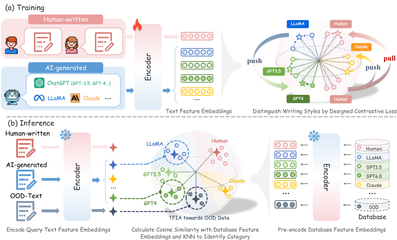 图 1: DeTeCtive 框架概览,展示了从多级对比训练到 KNN 推理的全流程。
2. TFIA 加持:无需训练的“增量学习”
这是本文最惊艳的设计——免训练增量适配 (Training-Free Incremental Adaptation)。 当用户发现一种新的 AI 写作风格时,不需要重新训练整个模型,只需将这种新风格的少量样本通过编码器存入“特征数据库”。在检索推理阶段,KNN 算法会自动利用这些新坐标点进行精准匹配。
实验与结果:全线 SOTA
研究团队在 Deepfake, M4, TuringBench 三大主流数据集上进行了验证。
- 泛化性巅峰:在 Deepfake 的“未见领域”测试中,AvgRec 达到了 82.60%,远超 Longformer 基线的 68.40%。
- 抗攻击性:面对 DIPPER 或 OUTFOX 的改写攻击,DeTeCtive 的性能下降幅度远小于其他对手,表现出极强的鲁棒性。
- 可视化证据:通过 UMAP 降维可以明显看到,DeTeCtive 学到的特征空间具备清晰的层级簇状结构。
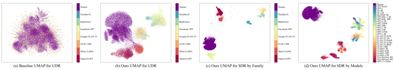 图 2: UMAP 可视化显示,DeTeCtive 成功将不同模型的写作风格映射到了互不干扰的特征区域。
深度洞察:为什么这行得通?
DeTeCtive 的成功在于它从“特征工程”转向了“流形学习”。它不再寻找 AI 文本的通用统计规律(如熵或困惑度),而是构建了一个高维的风格坐标系。
局限性与挑战: 虽然该方法在长文本检测中表现卓越,但对于极短文本(如推文)的风格特征捕捉可能依然存在挑战。此外,大规模特征数据库的检索效率在超大规模生产环境下也需要进一步优化。
总结
DeTeCtive 证明了:防御 AI 伪造文本的最佳武器,可能不是更复杂的判别模型,而是一把能精准量化写作风格的“标尺”。其 TFIA 机制为未来工业级的 AI 内容合规监管提供了一个非常务实的路径。