
DFPO:通过连续价值流建模,破解 LLM 强化学习的稳定性难题
DFPO: Scaling Value Modeling via Distributional Flow towards Robust and Generalizable LLM Post-Training
本文提出了 DFPO (Distributional Value Flow Policy Optimization),一种旨在提升大语言模型(LLM)后训练鲁棒性的强化学习框架。该方法通过将价值函数建模为连续的“生成流(Generative Flow)”而非离散标量,实现了对价值分布的精细化表征,并在对话、数学和科学任务中取得了 SOTA 性能。
TL;DR
复旦大学与荣耀的研究团队提出了 DFPO (Distributional Value Flow Policy Optimization)。该方法核心在于:不再让模型死记硬背一个不稳定的“价值标量”,而是学习一套价值演化流场。通过将 Flow Matching 与风险控制、一致性约束结合,DFPO 成功解决了 LLM 在噪声奖励环境下性能容易崩溃(Catastrophic Collapse)的顽疾,在对话与推理任务中展现出惊人的稳定性。
痛点深挖:为什么你的 LLM 强化学习总是不稳定?
在 LLM 的后训练(Post-training)阶段,模型往往依赖于 Reward Model 的反馈。然而,现有的 RL 流程(如 PPO, GRPO)面临两大杀手:
- 奖励噪声 (Reward Noise):Reward Model 并不完美,误判会导致错误的梯度更新。
- 分布外偏离 (OOD):当模型生成的文本偏离训练分布时,标量化的价值估计(Scalar Value)会迅速失效,导致政策更新进入“死循环”或性能骤降。
传统的**分布强化学习(Distributional RL)**尝试通过学习多个分位数来解决,但由于各分位数是孤立学习的标量,它们无法捕捉到语义空间中的精细连续变化。
核心机制:价值流(Value Flow)的语义跃迁
DFPO 放弃了离散的回归,转向了连续时间轴上的流匹配(Flow Matching)。
1. 建模价值流场 (The Value Flow Field)
作者将每个 token 的价值分布建模为一个从标准高斯噪声到目标回馈分布的连续传输过程。通过求解一个神经 ODE: 模型学习的是粒子在虚拟时间 内的“速度”,从而将噪声转化为复杂的、多峰的价值分布。
2. 几何一致性与风险控制
为了让流场更“听话”,DFPO 加入了两道严密的枷锁:
- 几何一致性 (Consistency Regularization):强制流场路径为直线。这不仅简化了优化,还允许模型在推理时仅需单步(NFE=1)即可获得精确的价值分布。
- 尾部风险管理 (Conditional Risk Control):通过显式惩罚左尾分布(规避风险)并鼓励右尾分布(探索高价值),防止模型在噪声干扰下走向极端。
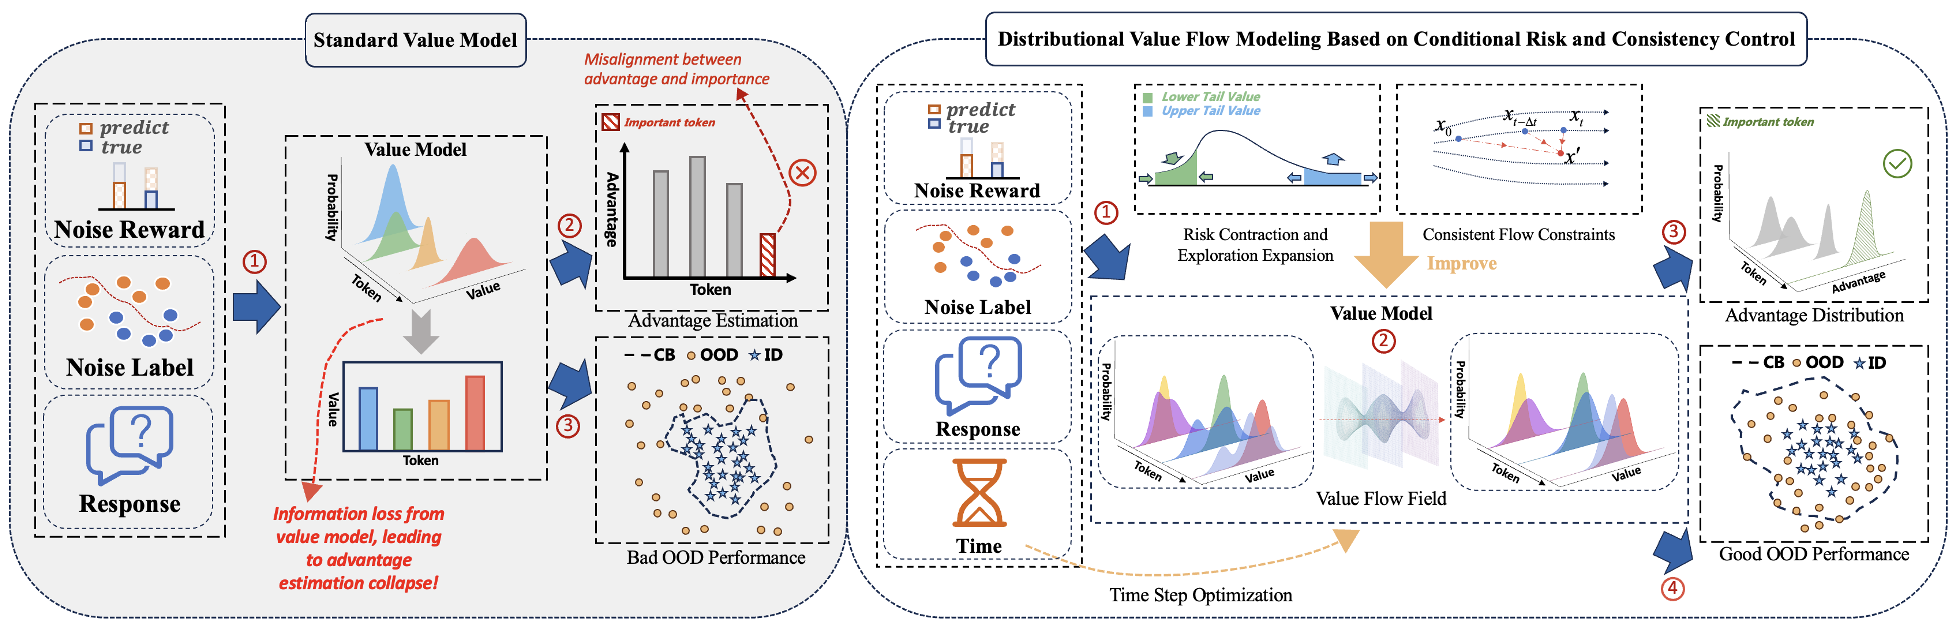 图 1:标量价值模型对比 DFPO 连续价值流建模。DFPO 能在噪声环境下压制伪波动,保留高价值探索潜力。
实验战绩:无惧崩溃的稳定性
在对话任务(Honor-Dialogue)的长期训练中,DFPO 展示了极强的抗衰减能力。
- 稳定性对比:如图 6 所示,PPO 和 GRPO 在训练中后期均出现了惨烈的性能塌陷,而 DFPO 的曲线则如水平线般稳定,最终保持在 86% 以上的高位。
- 数学与科学推理:在 OOD 场景下,DFPO 在 MATH500 上的表现比传统 PPO 提升了约 3-5 个百分点,且对模型规模(从 Qwen-1.5B 到 8B)具有良好的可扩展性。
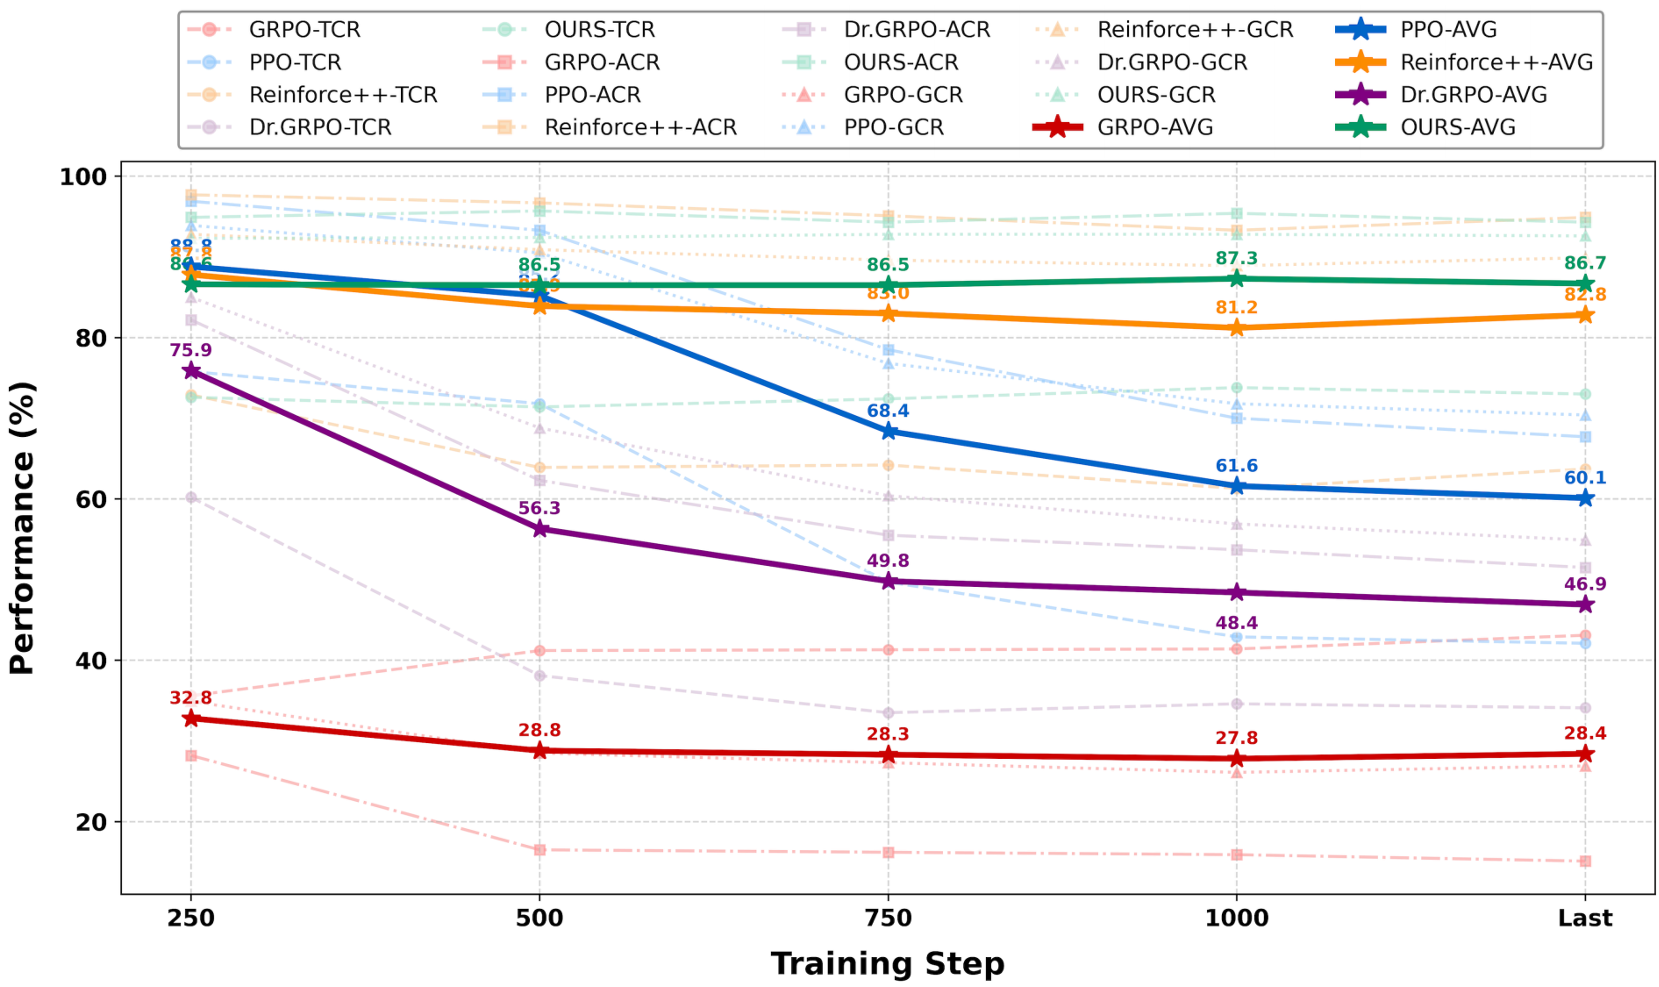 图 6:对话任务训练动态图。DFPO(橙色)相比于产生严重崩溃的基线(黄色、蓝色),表现出极强的鲁棒性。
深度洞察:为什么“流”比“数”好?
从物理直觉看,标量回归就像是在汹涌的大海中试图钉住一个点,稍有风吹草动(噪声)就会偏离。而价值流建模则是在学习海水的流动规律。即使某个奖励标签是错的,流场的连续性和一致性约束也会像过滤器一样,滤掉高频的随机噪声,保留全局的价值趋势。
此外,DFPO 在 token 级别进行的精细化 Advantage 估计(如图 13),能精准捕捉到如“Maximum”等关键语义词,避免了传统方法中 Advantage 值漫天飞(Overestimation)的现象。
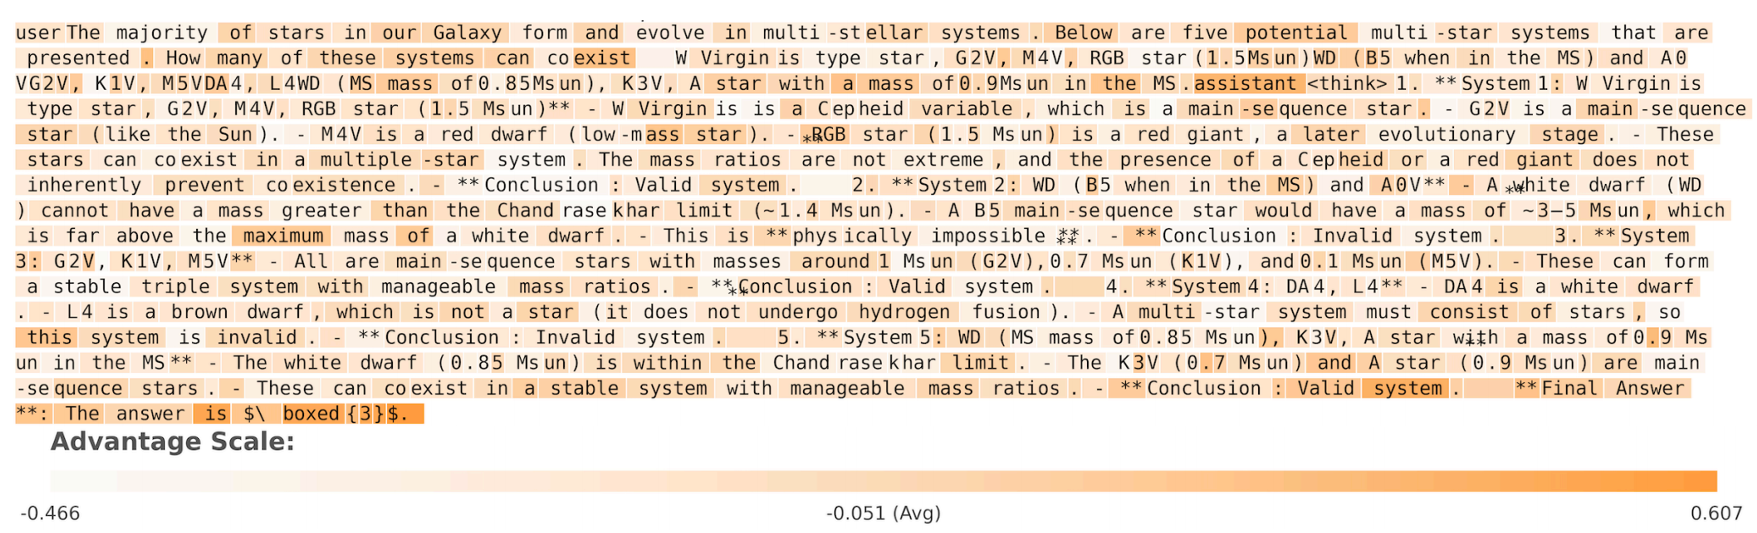 图 13:DFPO 的 token 级 Advantage 估计。可见其对关键解题步骤有更合理的权重分配。
总结与展望
DFPO 不仅是一个更强的 RL 算法,它更揭示了一个重要趋势:大模型的内部价值世界应该是连续的、分布式的。
局限性:虽然 1-step 欧拉求解器极大提升了速度,但在极度非线性的演化环境下,近似误差仍待进一步评估。未来,将这种价值流场与多模态数据、具身智能结合,可能会带来更强的跨领域适应能力。
Senior Editor's Note: DFPO 的贡献在于对 Critic 端的底层重构。在当前 Reinforcement Learning from Verifiable Feedback (RLVF) 的热潮下,如何处理中间步骤的噪声反馈是核心挑战,DFPO 给出了一份优雅的数学答卷。