
DPO:大模型偏好对齐的范式革命,告别 PPO 的繁琐时代
Direct Preference Optimization: Your Language Model is Secretly a Reward Model
本文提出了 Direct Preference Optimization (DPO),一种无需强化学习(RL)即可在大语言模型(LM)中实现人类偏好对齐的算法。DPO 通过数学转换,将经典的 RLHF 目标直接转化为简单的二元交叉熵损失函数(Binary Cross-Entropy Loss),在多个 NLP 任务(摘要生成、对话、情感控制)中达到了 SOTA 性能。
TL;DR
斯坦福大学研究团队提出的 Direct Preference Optimization (DPO) 彻底挑战了 RLHF 的传统流程。它通过优雅的数学代换,将原本需要奖励模型和强化学习(PPO)的复杂过程,简化为一个极其稳定的 分类损失函数。简单来说,DPO 让模型直接从人类偏好数据中学习“哪一个更好”,而无需在训练中进行在线采样或处理 PPO 的复杂收敛问题。
背景定位:这是大模型对齐领域的里程碑式工作,它是目前业界(如 Llama-3, Mistral 等)最主流的偏好微调技术之一,也是从“RL 对齐”向“非 RL 对齐”转型的开山之作。
痛点深挖:RLHF 为什么这么难?
在 DPO 出现之前,RLHF(Reinforcement Learning from Human Feedback)是唯一可行的路径。但这条路布满荆棘:
- 流程冗长:你得先训练 SFT 模型,再训练 Reward Model,最后用 PPO 调优。
- 不稳定性:RL 算法(如 PPO)极其脆弱,KL 约束稍微不对,模型就会产生低质量或重复的垃圾字符。
- 计算代价:PPO 需要在训练时频繁进行 Forward 采样,占用大量显存和计算资源。
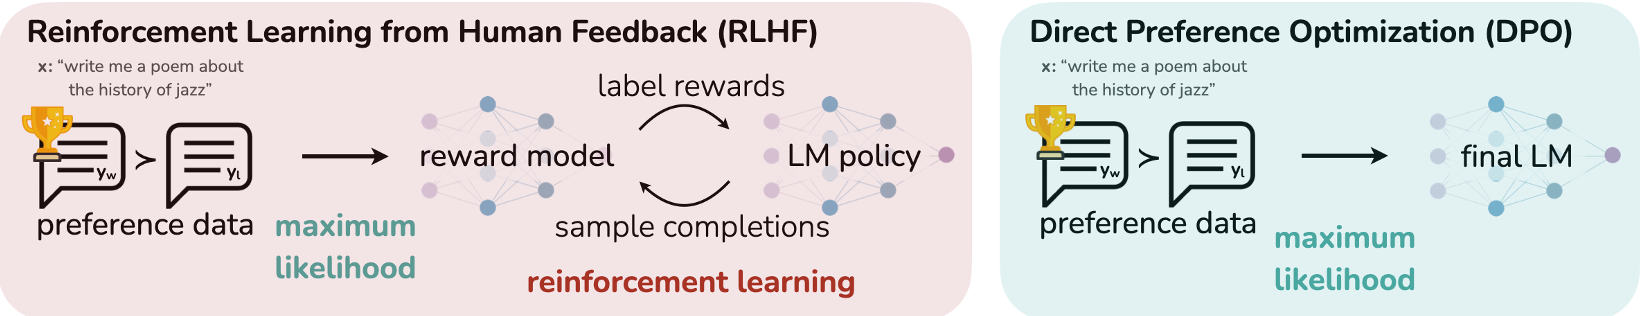 左侧为传统 RLHF,需独立训练 Reward Model 并进行 RL 闭环;右侧为 DPO,直接通过分类损失优化模型。
核心算法描述 (Methodology)
DPO 的核心直觉在于:一个训练良好的语言模型,本身就潜藏着它对奖励的理解。
通过对经典的 Bradley-Terry 模型进行重参数化,作者证明了最优策略 和奖励函数 之间存在一一对应关系。最终推导出的 DPO 损失函数如下:
这个公式的物理含义非常直观:
- 它在拉大“好答案”()与“坏答案”()相对于参考模型的对数概率差。
- 参数 起到了正则化作用,限制策略模型不偏离原始分布太远。
- 隐式奖励:模型在训练过程中,实际上是在不断修正其内部对“什么是好响应”的评分标准。
实验与战绩
在电影评论情感控制实验中,DPO 展示了极其“高效”的 Pareto 前沿。
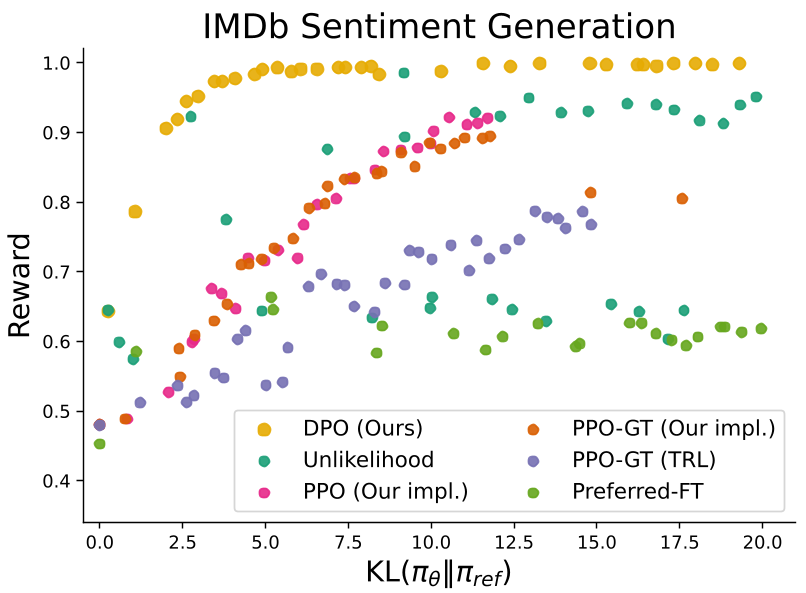
- 优化效率:在相同的偏离度(KL 散度)下,DPO 获得的奖励值显著高于 PPO。
- 任务覆盖:在摘要任务(TL;DR)和 Anthropic HH 对话数据集中,DPO 的 GPT-4 胜率全面压制 PPO。
- 鲁棒性:PPO 在温度(Temperature)升高时性能会显著下降(发生模式坍塌),而 DPO 表现非常稳健。
深度洞察:为什么 DPO 有效?
- 无偏估计:DPO 避免了奖励模型训练迭代中的二次误差累积。
- 梯度加权:DPO 的梯度包含了一个动态权重。当模型对偏好判断错误越严重时,权重越高,这使得模型能高效地专注在“难样本”上,而不是在已经学会的样本上反复磨洋工。
- 计算效率:由于不需要实例化奖励模型,DPO 节省了至少 50% 的额外权重加载,且无需在训练循环中生成文本,速度大幅提升。
局限性与展望
尽管 DPO 很强大,但作者也指出:
- 分布漂移:DPO 属于 Offline RL 范畴,它极度依赖于静态的偏好数据集。如果数据集质量不高,DPO 无法像在线 PPO 那样通过实时采样探索新状态。
- 过拟合风险:在极少数情况下,DPO 可能会过度优化对数概率差距,导致生成文本的语言质量下降(虽然实验中这种情况较少)。
总结
DPO 改变了我们对模型对齐的认知。它深刻地揭示了所谓的“偏好微调”,本质上是一个分类问题。对于大多数工业界应用而言,DPO 凭借其优异的 轻量化特性 和 训练稳定性,正迅速取代 PPO 成为大模型微调的首选方案。