
DIPPER:双层优化驱动的层次化强化学习,突破子目标生成的“不可触及”壁垒
Direct Preference Optimization for Primitive-Enabled Hierarchical Reinforcement Learning
本文提出了 DIPPER,这是一种基于双层优化(Bi-level Optimization)框架的层次化强化学习(HRL)方法。该方法首次将直接偏好优化(DPO)引入高层策略训练,并结合底层价值函数正则化,旨在解决长时程机器人操控任务中的非平稳性和不可行子目标问题。
TL;DR
层次化强化学习(HRL)长期受困于高、低层策略之间的“非平稳性”博弈和“不可行子目标”生成的陷阱。本文提出的 DIPPER 框架另辟蹊径,将 HRL 建模为双层优化问题,并首次利用 直接偏好优化 (DPO) 来平滑训练。在复杂的机器人操控任务中,DIPPER 将成功率提升了 40%,展现了其在处理极度稀疏奖励任务中的卓越能力。
背景定位:HRL 的“动态泥潭”
传统的 HRL 就像一个公司:高层经理(High-level Policy)负责下达子任务(Subgoals),底层员工(Lower-level Policy)负责执行。然而,问题在于:
- 员工在进化(Non-stationarity):随着训练进行,底层员工的能力在变,高层曾经下达的任务反馈不再准确。
- 经理瞎指挥(Infeasible Subgoals):高层由于缺乏对底层现状的理解,经常下达底层根本完成不了(比如穿墙或超距移动)的任务。
DIPPER 的出现,本质上是为这个公司引入了一套基于“偏好评价”而非“实时反馈”的考核机制,并强制高层必须参考底层的“工作能力量表”。
核心机制:双层优化与原始层正则化的 DPO
作者提出,要从根本上解决问题,必须建立一个严谨的数学模型。他们将 HRL 建模为受约束的优化:
核心创新一:解耦非平稳性的 DPO
为了逃离非平稳的环境奖励,DIPPER 采用了 DPO。通过学习静态的轨迹偏好(哪组子目标序列更好),高层策略不再受底层策略实时波动的干扰。这种基于静态偏好数据集的方法,为高层学习提供了稳定的“北极星”。
核心创新二:价值函数正则化
DIPPER 在高层策略的损失函数中加入了一个巧妙的惩罚项:利用底层的价值函数 。如果高层生成的子任务对应的 极低,说明该任务超出了底部能力的范畴,高层将受到严厉惩罚。
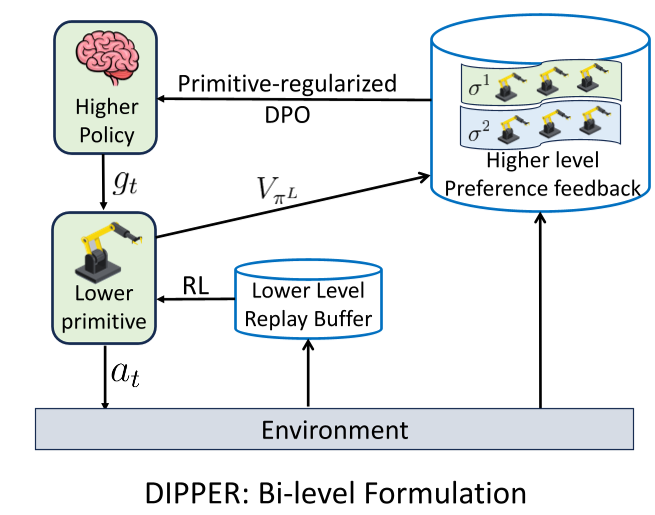 图 1: DIPPER 框架概览,左侧对比了传统 HRL 的痛点,中间展示了如何利用 正则化和 DPO 进行策略对齐。
实验与结果:全方位碾压 SOTA
作者在四类极具挑战性的环境中进行了实验:包括需要复杂避障的迷宫导航、精细的物体取放(Pick and Place)以及 Franka 厨房任务。
- 性能跨越:在 Pick and Place 任务中,当传统 HRL 基线(如 HIRO, HAC)接近零进度时,DIPPER 实现了极高的成功率提升。
- 消融验证:移除“价值函数正则化”后(见 DIPPER-No-V),性能大幅下降,证明了子目标可行性约束的必要性。
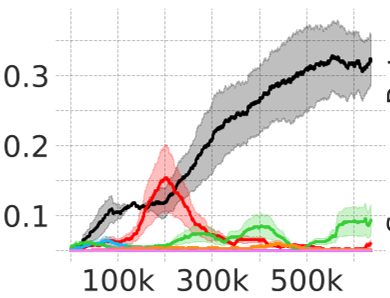 图 2: 在各类复杂任务下的成功率对比,DIPPER(红色实线)表现出极强的稳定性与高效的学习动力。
深度洞察:为什么偏好优化能行?
DIPPER 的成功说明了一个重要的直觉:在层次化结构中,明确的数值奖励(Environment Rewards)往往伴随着高噪声和滞后性。而**偏好(Preferences)**作为一种相对稳定的信号,能够过滤掉底层策略迭代带来的瞬时扰动。
此外,DIPPER 引入的高层梯度分析(Equation 8)揭示:它在增加“好轨迹”概率的同时,通过 实时调整权重,确保了高层预测的子目标永远在底层的“服务区”内。
总结与局限
Takeaway: DIPPER 是 HRL 理论与 PbL 技术的一次成功跨界融合。它告诉我们,要解决多级系统的协同问题,不仅要让每一级“做对的事”,更要通过共享的“能力边界(Value regularizer)”进行对齐。
局限性:尽管 DIPPER 减少了非平稳性,但大规模偏好数据集的生成(PiL 流程)在现实环境中可能仍面临采样效率的挑战。此外,在更高维、非稠密观察的子目标空间下,价值函数的拟合精度将成为系统的瓶颈。未来,如何结合多模态大模型作为高层先验,可能是该路径的下一步演进。