
DRO:深入 Token 的方差,解锁不可验证任务的推理优化
Direct Reasoning Optimization: Constrained RL with Token-Level Dense Reward and Rubric-Gated Constraints for Open-ended Tasks
本文提出了 Direct Reasoning Optimization (DRO),一种针对不可直接验证任务(如科学写作、医学问答)的约束强化学习框架。该方法结合了基于 Token 级方差加权的推理反射奖励 (R3) 与基于规则的门控机制 (Rubric-gating),在保持样本效率的同时显著提升了长文本推理质量。
TL;DR
在强化学习(RL)的世界里,数学公式和代码逻辑因其“可验证性”而成为了大模型推理的主战场。然而,当我们面对科学文献修订、法律合同分析等不可验证(Unverifiable)的任务时,失去客观裁判的 RL 往往会陷入奖励稀释或模型坍缩的困境。微软与 UCLA 最新的研究提出了 Direct Reasoning Optimization (DRO) 框架,通过 Token 级的方差加权(R3 奖励)和规则门控(Rubric-gating),在不需要外部奖励模型的情况下,让模型在“开放命题”中也能学会严谨推理。
痛点深挖:被稀释的“推理之光”
传统的自监督 RL 方法(如 RLPR)通常计算模型对参考答案的平均 Log-probability 作为奖励。但在长文本中,这存在一个致命的稀释效应(Dilution Effect):
- 信噪比低:长文章中 95% 以上的 Token(如虚词、标准术语)对前文的推理(CoT)不敏感。
- 梯度遮蔽:那 5% 真正反映推理质量的关键 Token(推理反射 Token),其信号在平均值计算中会被海量的背景噪声淹没。
- 奖励黑客:模型可能会学会通过生成极端保守、毫无意义但“稳健”的回复来骗取高分(例如在修订任务中干脆不进行修改)。
核心机制:R3 奖励与方差驱动的洞察
DRO 的核心在于它不平等地对待每一个 Token,而是通过**跨采样方差(Cross-rollout Variance)**来寻找那些真正受到推理逻辑影响的 Token。
1. Reasoning Reflection Reward (R3)
作者发现,如果一个 Token 的预测概率在不同的推理路径(CoT)下波动巨大,那么这个 Token 就是“推理反射”的。R3 奖励会对这些高方差 Token 进行 Softmax 加权,使模型更关注那些能证明其推理有效性的关键点。
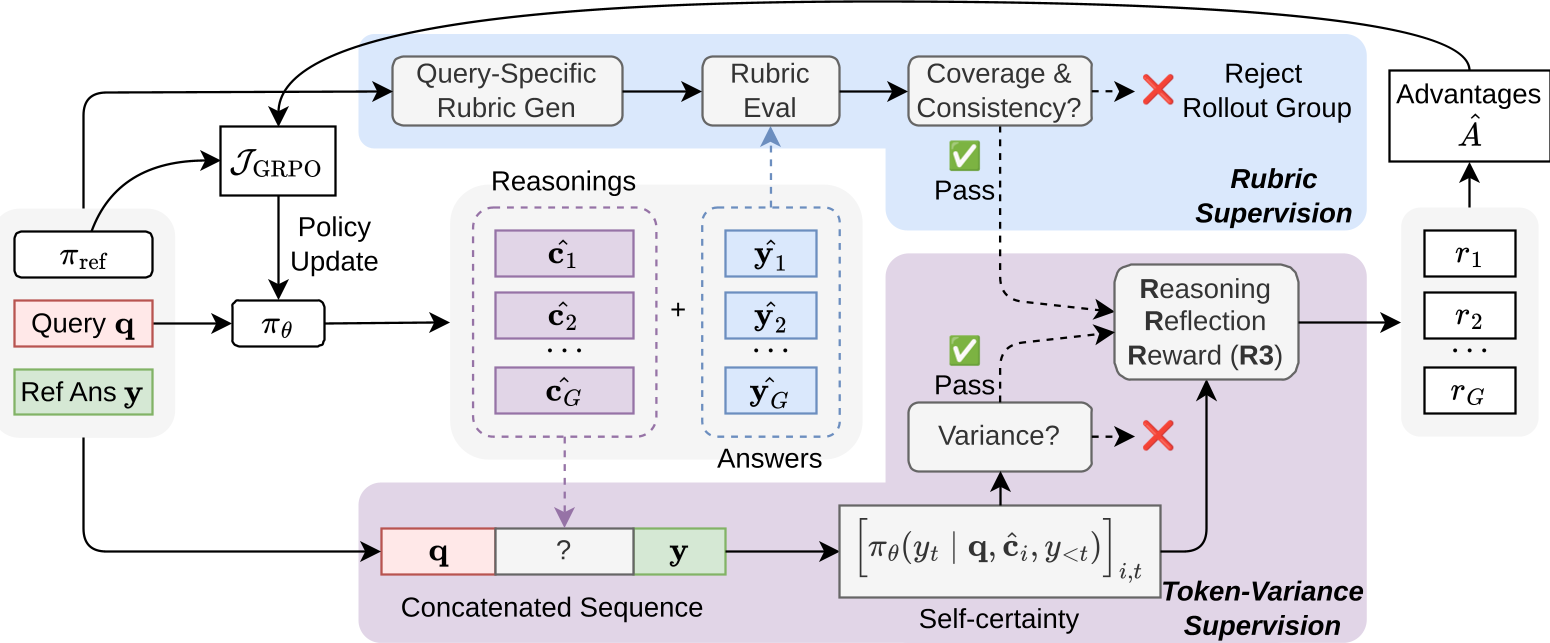 图 1:DRO 框架总览。展示了 R3 奖励计算、方差过滤以及规则门控的协同工作流程。
2. Rubric-gating:规则即约束
为了防止模型“刷分”而不顾事实,DRO 引入了 Rubric-gating。它不把规则评分直接加进奖励函数(这会导致训练不稳定),而是将其作为可行性约束(Feasibility Constraint)。如果采样组不满足预设的硬性规则(如:必须提及某核心概念),整个采样组将被丢弃。这种“拒收”机制迫使模型在合规的前提下进行优化。
实验与结果:快、准、稳
研究人员在科学写作(ParaRev)、医学、法律和金融四个专业领域进行了测试。
- 两倍速收敛:在达到相同性能时,由于 R3 奖励提供的梯度信号更纯净,DRO 的训练步数仅为对比方法的 1/3 到 1/2。
- 突破 SOTA:在 ParaRev 数据集上,其胜率(Win Rate)显著超越了强基线模型及单纯的 SFT。
- 解决坍缩:在没有 Rubric-gating 的情况下,模型往往会演化出“不修改”的策略;而 DRO 通过硬约束强制模型在有效修订的路径上探索。
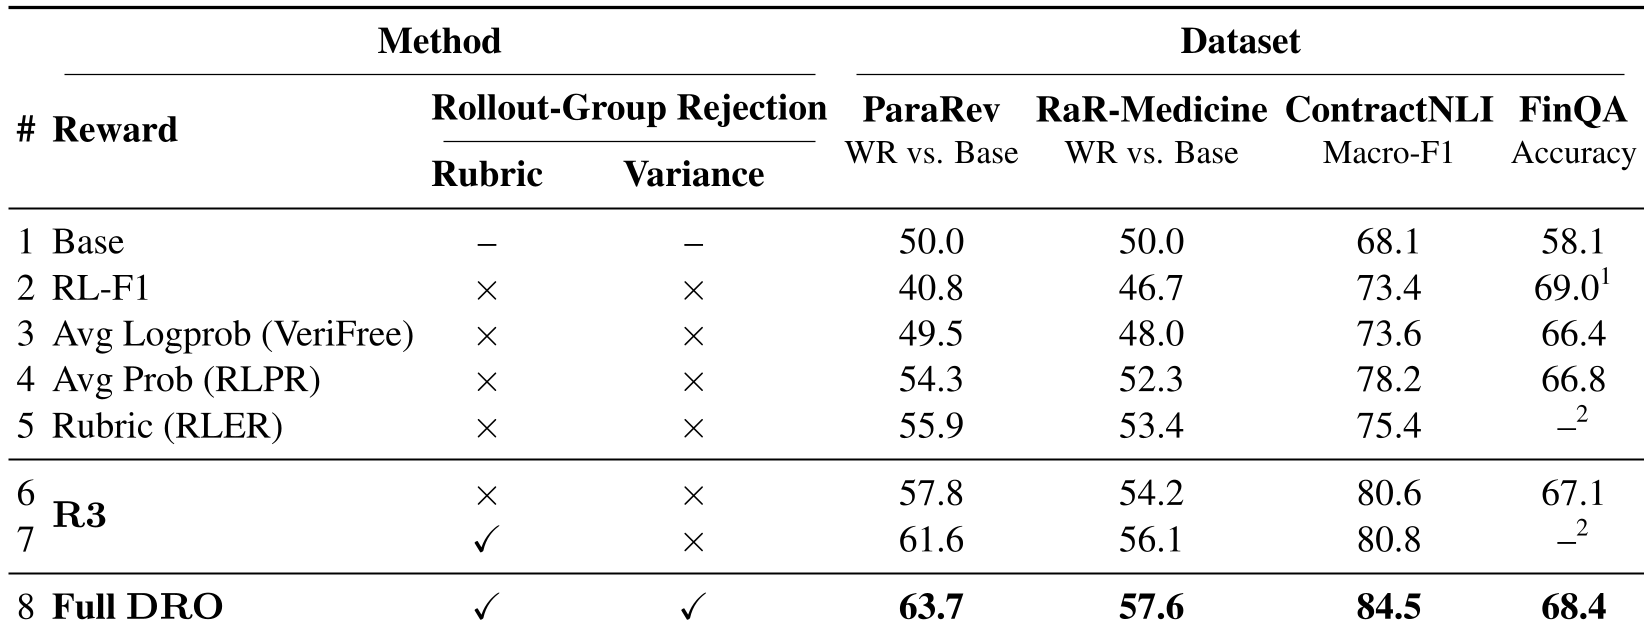 表 1:DRO 与各基线模型在四大数据集上的性能对比。可以看到 Full DRO 在各维度均处于领先地位。
深度洞察:为什么方差是关键?
从物理直觉上看,方差代表了“不确定性”。在 RL 探索过程中,那些概率分布极窄的 Token 代表了模型的 Inductive Bias 或常识,不应作为推理奖励的依据。而方差大的 Token 正是模型在不同“逻辑链路”中挣扎的部分。通过奖励这些部分,DRO 实际上是在奖励模型在逻辑分支点上做出的正确选择。
总结与展望
DRO 证明了即使在没有黄金标准验证器的情况下,通过精心设计的 Token 级反馈和宏观规则约束,依然可以引导大模型进行高质量的深度推理。
局限性:
- 依然依赖于一份高质量的参考答案(Reference Answer),无法完全脱离标注数据实现“零样本”自进化。
- Rubric 的生成质量高度依赖于 Baseline 模型的指令遵循能力。
启示: 未来的长文本处理不应只关注全文本的全局 Score,深入到 Token 级、利用方差信息提取“信号中的信号”,将是提升模型专业领域推理能力的必然选择。