
DiskANN:单台机器挑战十亿级向量检索,打破 SSD 高延迟魔咒
Diskann: Fast accurate billion-point nearest neighbor search on a single node
本文推出了 DiskANN,一个专为单节点十亿级点规模设计的近似最近邻搜索(ANNS)系统。其核心是一个名为 Vamana 的新型图索引算法,配合 SSD 存储优化,实现在仅 64GB RAM 的机器上提供高于 95% 的 1-recall@1,且查询延迟低于 5ms。
TL;DR
在向量搜索领域,一直存在着“高性能必选内存”的共识。然而,微软研究员们提出的 DiskANN 彻底颠覆了这一认知。通过新型图索引 Vamana 配合 SSD 优化策略,它只需一 economy 台 64GB 内存的普通工作站,就能在 10 亿规模的数据集上实现 95% 以上的召回率,平均延迟甚至不到 3 毫秒。
背景定位:这是向量数据库(Vector Database)领域具有里程碑意义的工作,它解决了大规模 ANNS(近似最近邻搜索)中“内存成本”与“搜索精度”之间的长期矛盾。
1. 痛点:被“内存墙”困住的十亿级搜索
在 DiskANN 出现之前,学术界和工业界主要走两条路:
- 内存派 (Graph-based):如 HNSW。速度快、召回高,但十亿点规模需要 T 级别的内存,多机集群成本高昂。
- 压缩派 (IVF+PQ):如 FAISS 的典型方案。通过 Product Quantization 压缩向量,虽然省内存,但因为是有损压缩,召回率(尤其是 1-recall@1)通常惨不忍睹(通常在 50% 左右波动)。
当时的共识是:SSD 太慢了。SSD 的随机读取延迟是内存的数百倍,直接把内存索引搬到磁盘会导致性能断崖式下跌。
2. 核心黑科技:Vamana 构图算法
DiskANN 的核心在于一种名为 Vamana 的新型图索引算法。它在逻辑上继承了 RNG(相对邻域图)的思想,但引入了两个致命杀手锏:
2.1 可调控的“长程边” ( 参数)
HNSW 等算法通常通过多层分级来加速,但在磁盘上这会增加随机读取次数。Vamana 引入了一个参数 。在剪枝(Pruning)过程中,它不仅考虑邻居是否更近,还通过 过滤掉过于“冗余”的短边,主动保留跨度更大的长程边。
这意味着搜索时,单次跳转能覆盖更远的距离,从而大幅减少到达目标区域所需的磁盘 IO 跳数(通常仅需 3-5 跳)。
2.2 小内存构建大索引
针对内存装不下的问题,作者提出了重叠分区合并策略。先在各分片上并行构建 Vamana 索引,最后合并成全局一张图。这种合并策略保证了即使查询点跨越分区,依然能通过重叠部分的连通性找到全局最优解。
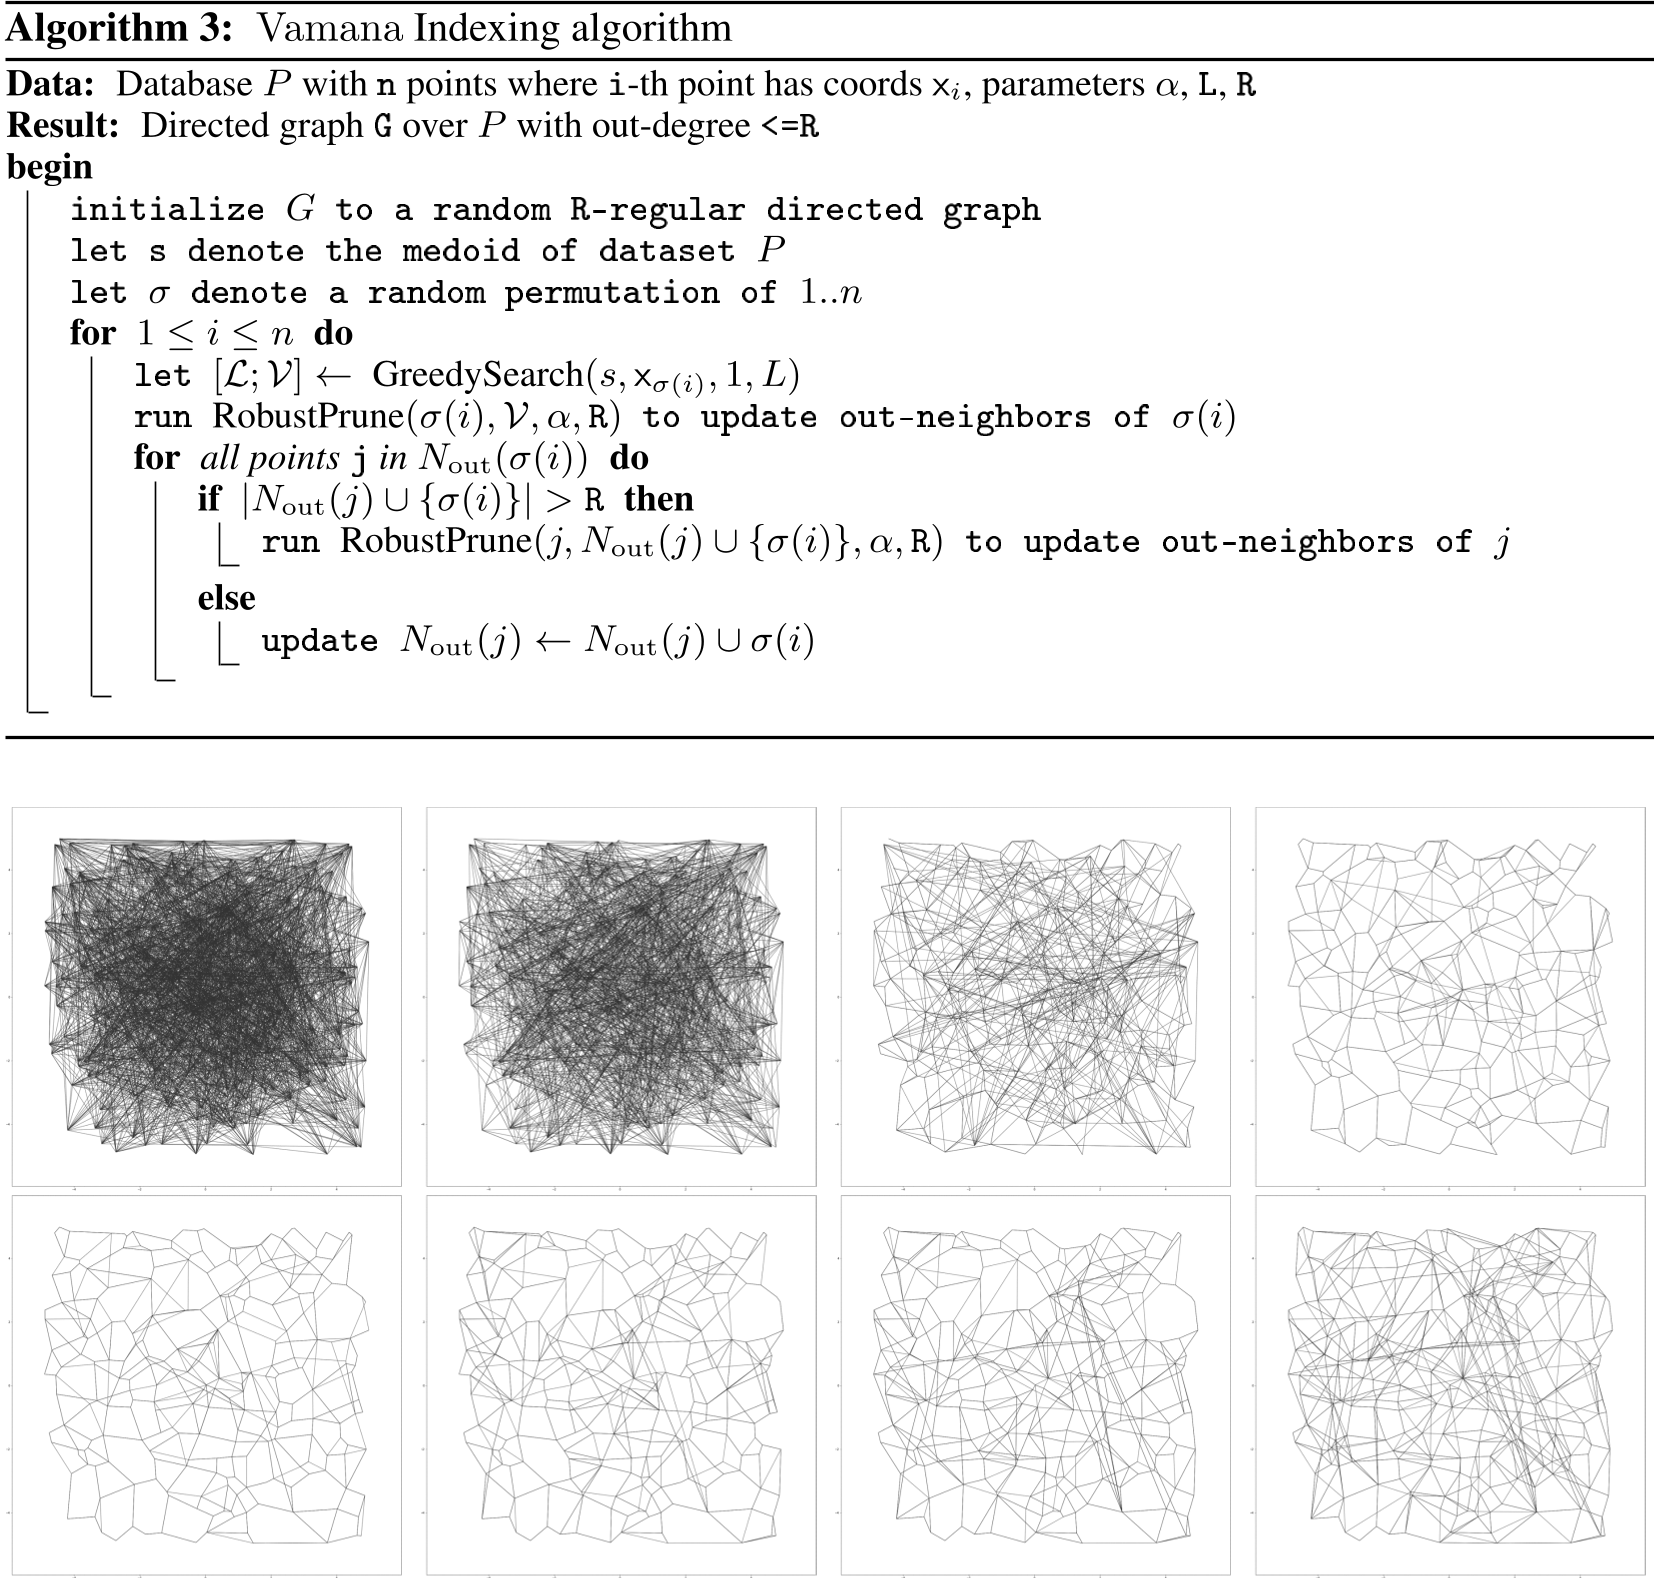 上图展示了从随机初始图(a)到第一轮 优化(b),再到引入 构建长程边(c)的演进过程。
3. 磁盘 I/O 的极限压榨:Beam Search 与 重排
DiskANN 的高性能不仅靠图结构,更靠一套精妙的执行系统:
- Beam Search(束搜索):不同于传统的贪婪搜索一次只读一个点,Beam Search 每次并行发起 个磁盘请求。利用现代 SSD 的并发处理能力,在不显著增加延迟的情况下,一次性获取多个候选者的邻居信息。
- 原地重排(On-disk Re-ranking):内存中只存压缩后的 PQ 向量(用于快速估算距离),而将原始全精度向量与图邻居表存放在同一个磁盘扇区中。当系统访问邻居表时,会顺便把对应的原始向量读出来。这样在最后阶段可以用无损数据进行精排,召回率直接拉满。
4. 实验结果:降维打击
在 SIFT1B(十亿级点集)测试中,DiskANN 的表现极其抢眼:
- 召回率高:在相同内存占用下,召回率远超 FAISS。
- 效率极高:在 95% 召回率时,延时保持在 3ms 级别。
- 跳数更少:由于 Vamana 的拓扑优势,其搜索路径深度仅为 HNSW 的 1/2 到 1/3。
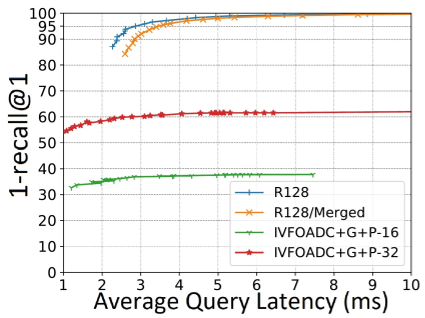 可以看到 DiskANN (R128) 在高召回区间(右上角)完全覆盖了传统的压缩方案。
5. 深度洞察与总结
DiskANN 的成功证明了:索引算法的演进可以弥补硬件性能的天然差距。
- 局限性:尽管查询非常快,但其构图过程(Indexing)依然需要数天时间(10亿点规模约 2-5 天),在大规模动态增删场景下尚有改进空间。
- 启示:对于正在构建 AI 应用的团队,DiskANN 提供了一条低成本、高精度的技术路径。不需要购买动辄 TB 内存的高端服务器,一块高性能 NVMe SSD 配合优秀的图拓扑设计,就能盘活十亿级规模的向量数据。
这种“软硬协同设计(Hardware-aware algorithm design)”的思路,值得所有从事 AI 基础设施研发的人员借鉴。