
Word2Vec 进化论:分布式表示的短语学习与计算效率飞跃
Distributed representations of words and phrases and their compositionality
本文提出了 Skip-gram 模型的数个重要扩展,包括负采样(Negative Sampling)、高频词下采样(Subsampling)以及短语表示学习(Phrase Representation)。这些改进不仅将训练速度提升了 2-10 倍,还在语义类比任务上显著超越了原有的 SOTA 模型。
TL;DR
本文由 Google 的 Mikolov 团队发布,是深度学习 NLP 领域的里程碑之作。它在原始 Skip-gram 模型的基础上,通过引入负采样 (Negative Sampling) 和短语训练 (Phrase Training),彻底解决了大规模语料训练效率低和固定搭配语义缺失的问题,正式开启了表示学习的新纪元。
背景定位与痛点深挖
在本文发表之前,词向量(Word Embeddings)的训练往往受限于 Softmax 层的巨大计算量。当词表规模(Vocabulary Size)达到百万级时,Softmax 的分母项计算变成了推理和训练的噩梦。
此外,单纯的“词”表示存在天然缺陷:语义并非总是线性叠加的。比如 “Air” 和 “Canada” 各有含义,但 “Air Canada” 是一个特定的航空公司实体。如果不能将短语作为整体建模,模型就无法触及深入的语义理解。
核心方法论:从效率到表达力
1. 负替换与计算优化
为了加速训练,作者对比了两门“重炮”:
- Hierarchical Softmax (HS):利用霍夫曼树(Huffman Tree)将计算复杂度从 降至 。
- Negative Sampling (NEG):这是一种由 NCE (Noise Contrastive Estimation) 简化而来的方法。其核心直觉是:既然我们无法计算所有干扰词的概率,不如直接随机抽取 个干扰项(噪声),让模型学会区分“正确答案”和“噪声”。实验证明,这种简化方案不仅快,而且对于高频词的表示质量提升巨大。
2. 高频词下采样 (Subsampling)
对于像 “the”、“in”、“a” 这种出现频率极高但信息量极低的词,作者引入了丢弃概率公式:。这不仅加速了训练,更重要的是,它给了生僻词(Rare Words)更多的“上场机会”,让它们的向量也能够得到充分调优。
3. 短语学习 (Learning Phrases)
基于数据驱动的得分机制: 通过多次扫描语料并使用 作为折扣系数防止低频组合被错误提取,模型得以将 “New_York_Times” 这样的短语视为单一 token。
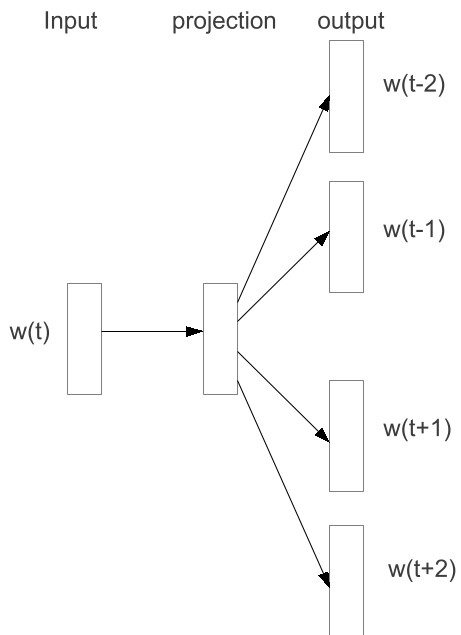 Figure 1: Skip-gram 模型架构,通过中心词预测上下文语境
实验与线性组合性 (Additive Compositionality)
该工作最令人惊叹的发现之一是线性结构。通过 PCA 降维,我们可以清晰地看到“国家-首都”的对应关系在空间中呈现基本平行的排列(见下图)。
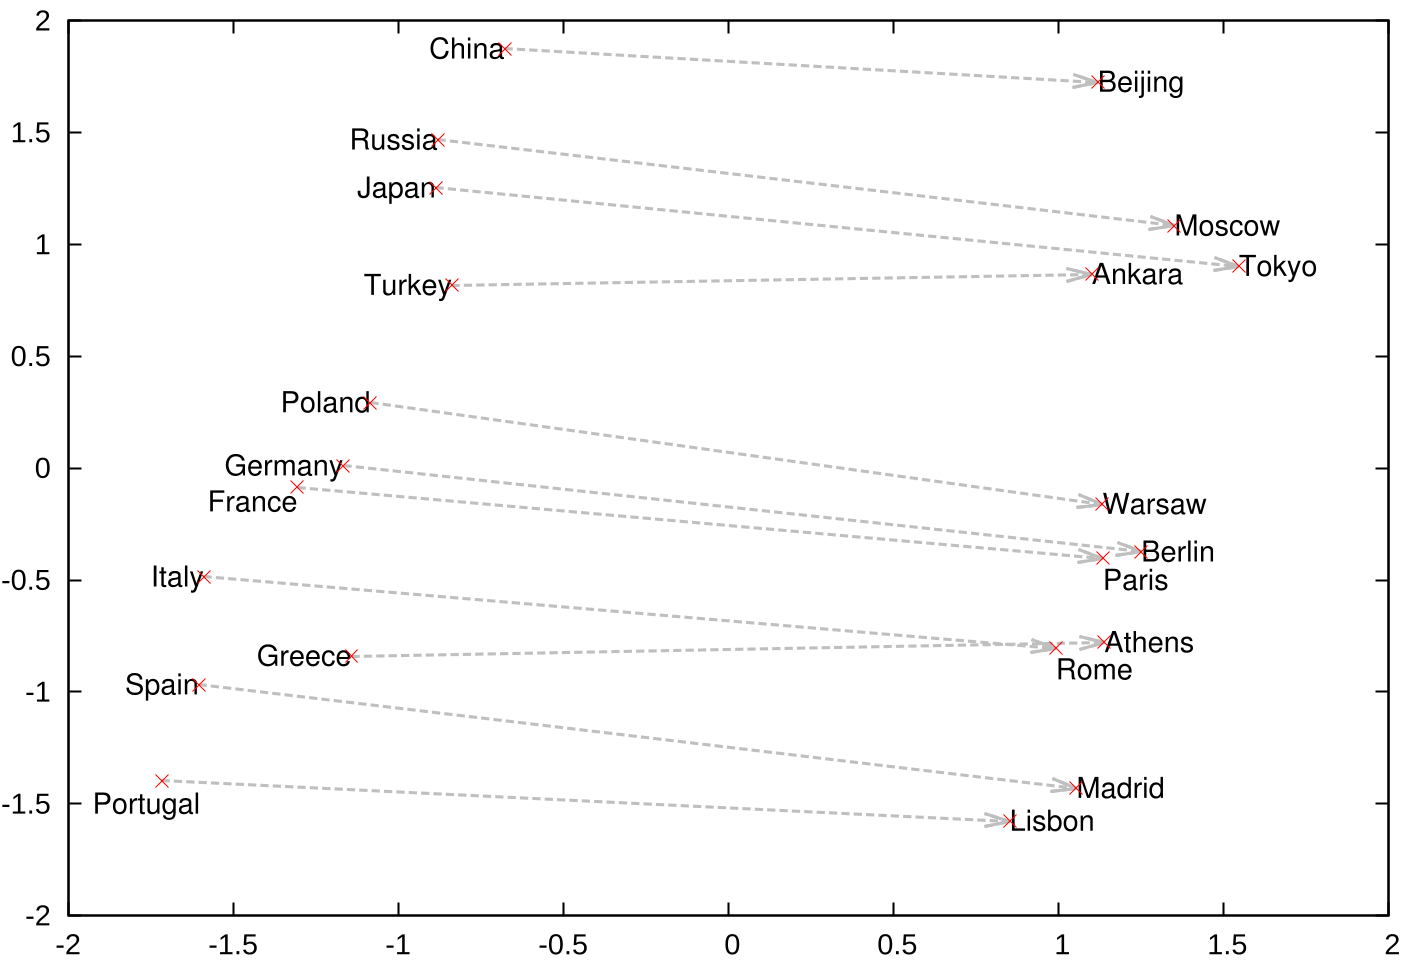 Figure 2: 国家与首都的向量投影展示了清晰的线性映射关系
此外,作者展示了向量的可加性:
vec("Russia") + vec("river")最接近vec("Volga River")vec("Germany") + vec("capital")最接近vec("Berlin")
这证明了 Skip-gram 学习到的向量实际上是上下文分布的对数表示,向量相加等同于上下文分布的乘积,即一种朴素的语义 "AND" 操作。
历史坐标与深度洞察
在与 Collobert & Weston 以及 Mnih & Hinton 等前辈工作的对比中(见原文 Table 6),Word2Vec 展示了其降维打击般的优势:仅需 1 天训练出的 1000 维模型,在处理复杂语义(如 ninjutsu 近义词)时,明显比训练数周的旧模型更具鲁棒性。
深度总结与展望
主要贡献:
- 引入 Negative Sampling,大幅降低了计算开销。
- 提出 Phrase learning 方案,填补了分布式表示从词到语义单位的鸿沟。
- 发现了向量空间中的数学加法特性,为后续的组合语义研究指明了方向。
局限性: 尽管 Word2Vec 在工程上极其成功,但它本质上仍是静态词向量,无法处理一词多义(Polysemy)问题(例如 "bank" 在不同语境下的含义)。这一挑战直到几年后 ELMo 和 BERT 的出现才得以完美解决。
启发: 在大数据时代,模型架构的“轻量化”与“规模化”同样重要。Skip-gram 的成功告诉我们,通过合理的采样策略平衡数据分布,往往能获得意想不到的泛化能力。